LangChain 与 LangGraph 全景解析:一个让你跑得快,一个让你跑得稳
序言
先说一个我见过最多的误解:很多人把 LangChain 和 LangGraph 当成两个竞品,在两者之间做选择。
这是一个方向性的错误。官方自己的定位写得很清楚——LangChain 是框架(framework),LangGraph 是运行时(runtime)。它们不是同一层的两个选项,而是同一条抽象阶梯上的两层:一个负责「怎么把零件拼起来」,一个负责「拼起来之后怎么跑、跑崩了怎么续」。
更要命的是,从 2025 年 10 月的 1.0 版本开始,LangChain 的 agent 本身就跑在 LangGraph 的运行时之上。所以「选 LangChain 还是 LangGraph」这个问法,本身就像在问「选方向盘还是选发动机」。
这篇文章想讲清楚四件事:
- 它们分别是什么、什么时候出现的;
- 各自真正解决的是什么问题(不是功能列表,是它们在工程上填补了哪个坑);
- 什么场景该用哪个——判断标准其实只有一条;
- 两个能跑起来的 Demo,一个走 LangChain 的捷径,一个走 LangGraph 的显式路线,放在一起对比着看。
文中代码基于 langchain 1.4.x 与 langgraph 1.2.x(2026 年 10 月),接口跟 0.x 时代差别很大,如果你搜到的是老教程,别照抄。
一、先把时间线钉住
讨论这两个框架,时间点错位是最常见的混乱来源。很多人印象里的 LangChain 还停留在 2023 年那个「抽象过重、包体臃肿」的版本,而 LangGraph 则被当成「后来才出的新东西」。
实际上两家是同一个团队、同一个仓库体系,前后脚长出来的。
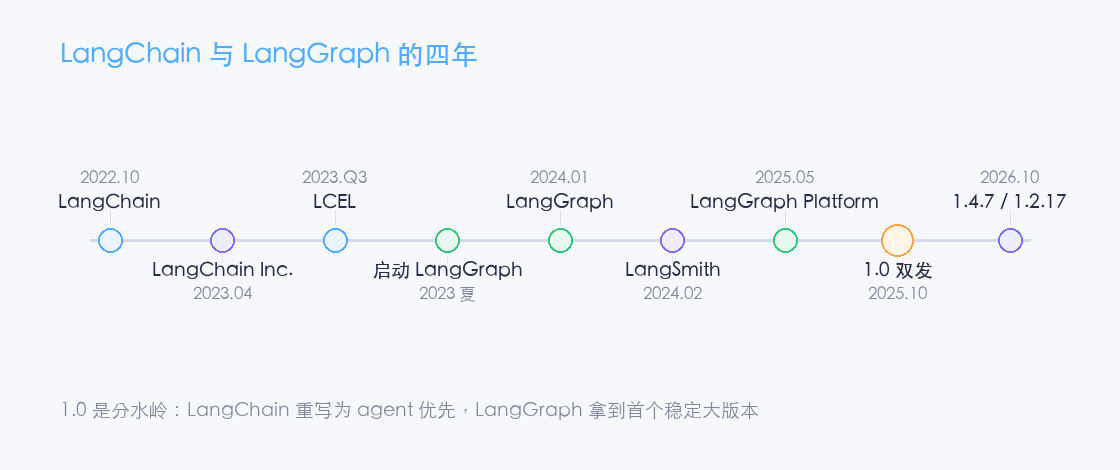
| 时间 | 事件 | 为什么重要 |
|---|---|---|
| 2022.10 | LangChain 开源(Harrison Chase) | 把「LLM + 外部数据 + 工具」的胶水代码标准化 |
| 2023.04 | LangChain Inc. 成立 | 从个人项目变成公司 |
| 2023.Q3 | LCEL(LangChain 表达式语言) | 声明式地定义链,prompt | model | parser 的写法就是这时候定的 |
| 2023.10 | LangServe | 把 LCEL 链一键发布成 API |
| 2023 夏 | 内部启动 LangGraph | 起因很直接:用户抱怨「高层抽象挡路了」 |
| 2024.01 | LangGraph 发布 | 循环图 + 持久化状态,把控制权还给开发者 |
| 2024.02 | LangSmith 发布 | 可观测与评估,Agent 调试的刚需 |
| 2025.05 | LangGraph Platform GA | 托管部署,长期运行的有状态 Agent 有了基建 |
| 2025.10 | LangChain 1.0 与 LangGraph 1.0 | 分水岭:LangChain 推倒重写为 agent 优先,LangGraph 拿到首个稳定大版本 |
| 2026.10 | langchain 1.4.7 / langgraph 1.2.17 | 当前版本,承诺 2.0 之前不再破坏性变更 |
有两条线值得单独说。
第一条:LangGraph 不是「LangChain 2.0」,它是被 LangChain 的失败逼出来的。
官方在复盘里写得很坦率:2023 年夏天开始收到大量负面反馈——破坏性变更、隐藏的 prompt、包体膨胀、依赖冲突。这些问题大多能修,但有一条修不了:用户想要更多控制权。LangChain 为了易用性牺牲了控制力,而一旦要上生产,那些让入门变简单的高层抽象,恰恰成了障碍。
于是他们用「可控性」和「运行时」两根柱子重新做了一个东西:没有隐藏 prompt、没有隐藏的上下文工程,流式、状态、人机协同、持久化执行全部一等公民。这就是 LangGraph。
第二条:2025 年 10 月的 1.0 是双发,而且是一次「合流」。
LangChain 1.0 做的事,本质上是三件:
- 把重心收敛到核心 agent 循环(模型 → 工具 → 模型 → 结束),其它都往外挪;
- 引入 middleware 这个新概念,让你在循环的每个钩子上做定制;
- 把运行时换成 LangGraph——持久化、流式、人机协同这些能力直接继承,不用自己实现。
同时,老的 0.x 版本被改名 langchain-classic 继续维护。所以你今天看到的 LangChain,和 2023 年那个 LangChain,已经是两个东西了。
二、LangChain 是什么:给 LLM 装一个万能插座
一句话定义:LangChain 是把「模型、提示词、检索、工具」这些零件标准化并组装起来的框架。
它填补的坑很具体:2022 年的时候,每换一个模型厂商,调用方式、消息格式、工具定义全都不一样;每接一个数据源,加载和切分逻辑都要重写。LangChain 做的事就是抽出一层统一接口——同一套代码换个模型字符串就能跑,这是它当年爆红的最直接原因。
到 1.0 之后,它的重心收敛成三块:
| 组成 | 作用 |
|---|---|
| Model | 统一模型接入,provider:model 一个字符串切换厂商 |
| Tools | 把任意 Python 函数变成模型可调用的工具(@tool 装饰器) |
| Agent(harness) | create_agent 提供标准 agent 循环 + middleware 定制 |
这里有个概念值得单独拎出来:官方现在把 agent 定义成 Model + Harness。Harness(线束)指的是循环之外的一切——提示词、工具集、中间件。而 harness 的工作只有一个:在该给模型上下文的时候,把对的上下文给它。
这也解释了 middleware 为什么是 1.0 最重要的新东西:它是「上下文工程」在框架层面的落点。1.0 内置了几类常用中间件:
- Human-in-the-loop:工具执行前暂停,让人批准、修改或拒绝;
- Summarization:历史快撑爆窗口时压缩旧消息,保留最近的;
- PII redaction:把邮箱、手机号之类的敏感信息在送进模型前打码。
当然也可以自己写,挂在循环的各个钩子上(before_model、after_model 等)。
LangChain 的气质是「默认值优先」:它替你做了一大堆决定,你接受这些默认值就能很快跑起来;一旦你的需求和默认值不符,就要动 middleware 往下挖。
三、LangGraph 是什么:给 Agent 装一个操作系统内核
一句话定义:LangGraph 是一个低层编排框架和运行时,把 Agent 表达成「带状态的图」。
它的三个核心概念,其实就是三件事:
| 概念 | 是什么 | 类比 |
|---|---|---|
| State | 一张贯穿全程的共享数据结构 | 全局变量 / 数据库里的一行 |
| Node | 读写 State 的函数 | 一个处理步骤 |
| Edge | 决定下一步走哪 | 流程连线,可以是条件分支 |
| Checkpointer | 每一步的存档 | 游戏存档点 |
关键在于那个环:LangGraph 允许边指回上面,所以 Agent 可以「调工具 → 看结果 → 再调一次」,而不是一条道走到黑。这也是它和 DAG 编排最本质的差别。
设计来源也说明了它的定位:LangGraph 受 Google 的 Pregel(图计算)和 Apache Beam 启发,公开接口参考了 NetworkX。这不是给业务开发看的框架,是给「要控制每一步」的人用的运行时。
有三个事实容易被忽略:
- 它可以完全脱离 LangChain 单独使用。 你用不用 LangChain 的模型抽象都行。
- LangChain 的 agent 就跑在它上面。 所谓
create_agent,本质是「预置好的 LangGraph 图」。 - 它的生产验证来自大厂的长跑场景——LinkedIn、Uber、J.P. Morgan、BlackRock 这类,共同点是流程长、要审计、不能重跑。
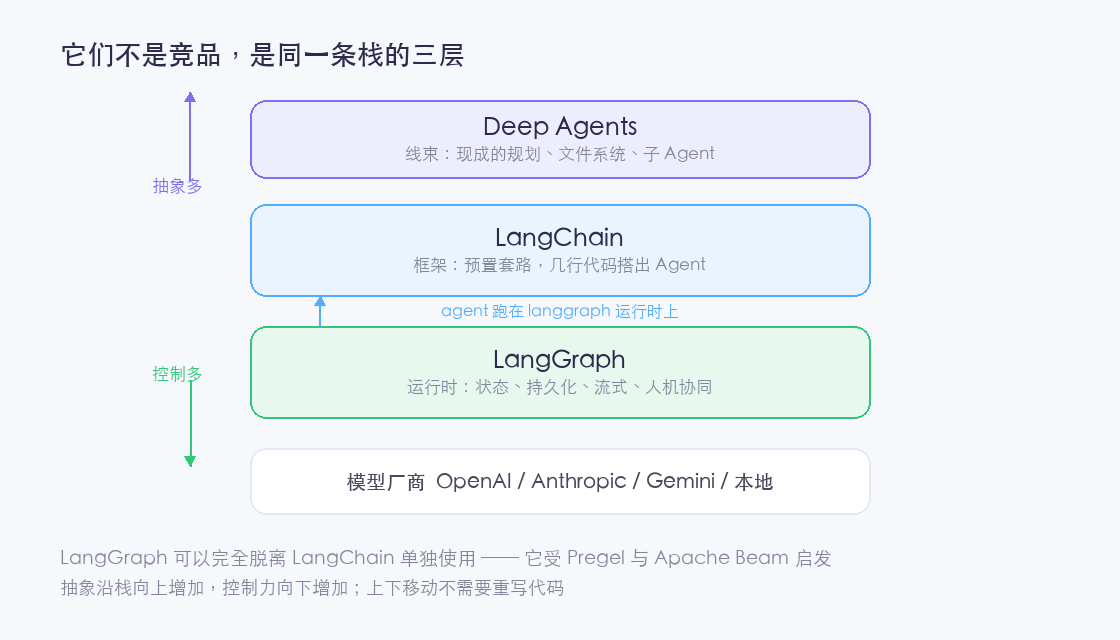
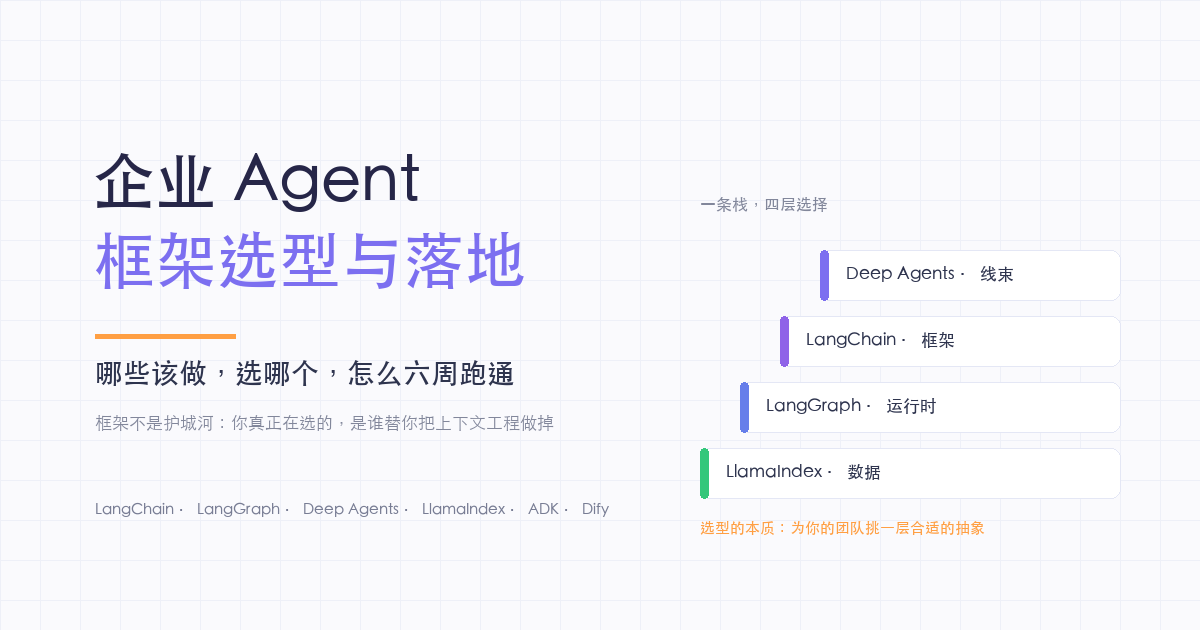
这张图值得记住:抽象沿栈向上增加,控制力向下增加。官方给的落地建议是反直觉的——从最高层起步,被需求逼着往下掉,而不是一上来就画状态机。
四、一张表看清区别
| 维度 | LangChain | LangGraph |
|---|---|---|
| 定位 | 框架(framework) | 低层编排 + 运行时(runtime) |
| 心智模型 | 流水线 / 链 | 状态机 / 图 |
| 拓扑 | 基本是 DAG,单向 | 有环,可回头 |
| 状态 | 随消息传递,偏隐式 | 显式 State,全程可见可改 |
| 持久化 | 靠底层 runtime(即 LangGraph) | 一等公民,Checkpointer |
| 中断恢复 | 内置中间件可做 | interrupt() + Command(resume=) |
| 上手成本 | 低,十几行出活 | 高,要先想清楚状态怎么设计 |
| 定制深度 | 通过 middleware 钩子 | 任意,每个节点都是你的代码 |
| 最适合 | 快速做出可用的 Agent | 长流程、要审计、要断点续跑 |
如果把区别压缩成一句话:
LangChain 关心「你要做什么」,LangGraph 关心「这件事怎么一步步跑完」。
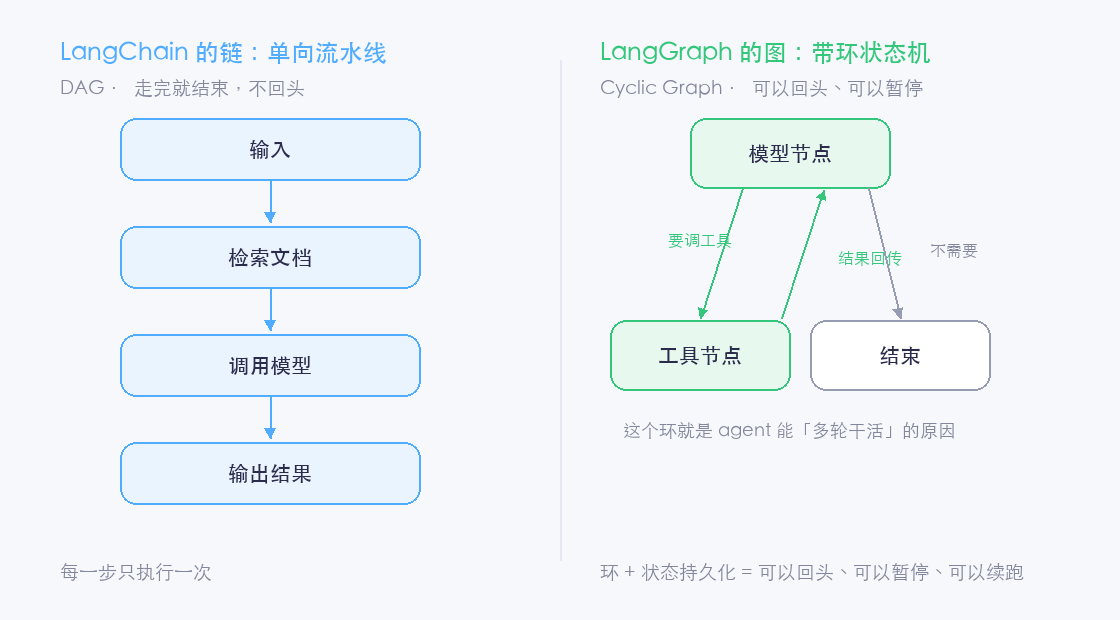
左边是 LangChain 的典型形态:输入进、结果出,中间几步串起来,走完就结束。右边是 LangGraph:模型判断要不要调工具,调完把结果塞回去,再判断一次——这个环就是 Agent 能「多轮干活」的原因。
环的价值不只是多轮,而是它顺带带来了两个能力:暂停和续跑。 因为没有环、没有状态存档,你既没法「跑到一半停下等人」,也没法「崩了从中间接着跑」。这两件事在 demo 里无所谓,在生产里是生死线。
五、什么时候用哪个
判断标准其实只有一条,我把它放在最后,先看场景表:
| 你的场景 | 建议 | 原因 |
|---|---|---|
| 单次问答、企业 RAG、文本处理 | LangChain | 一次跑完,不需要回头 |
| 快速验证一个 Agent 想法 | LangChain(或更上层的 Deep Agents) | 十几行就能跑,别过度设计 |
| 多步工具编排、需要记忆 | LangChain + 中间件 | checkpointer + thread_id 就够 |
| 流程要人工审批 | LangGraph | interrupt() 是硬需求 |
| 长流程、失败要断点重试 | LangGraph | 重试单步而不是整条重跑,直接省成本 |
| 强合规,每步要可举证 | LangGraph | 显式状态图 + checkpoint,逐步可回溯 |
| 多智能体协同 | LangGraph | 子图天然支持嵌套与共享状态 |
那条判断标准是:
你的流程需不需要「回头」和「中断恢复」?
不需要——LangChain 的流水线更轻更快,别上状态机。
需要——LangGraph 的 Checkpointer 就是刚需,硬用 DAG 兜不住。
我在框架选型那篇里提过一个反模式,这里再强调一次:一上来就 LangGraph 画状态机,结果 80% 的节点是空转。 抽象阶梯应该从最高层起步,被需求逼下来。
六、Demo 一:用 LangChain 十几行搭一个能干活的 Agent
场景:电商客服。用户问「我的订单到哪了」,Agent 要先查订单,再基于真实结果回答——不能编。
6.1 装环境
1 | pip install -U langchain langchain-openai |
最小依赖就这两个。langgraph 会被作为依赖自动装上,因为 LangChain 的 agent 运行时就是它——这一点很多人不知道,以为要单独装。
6.2 定义工具
工具就是一个普通函数加一个装饰器,docstring 是给模型看的说明书,写得越清楚模型越少调错。
1 | from langchain.tools import tool |
6.3 创建 Agent
1 | from langchain.agents import create_agent |
跑起来大概会看到:
1 | 您的订单 A1001 已发货,承运商是顺丰,预计 10 月 28 日送达。 |
就这么多。create_agent 内部帮你做了:绑定工具、构造循环、解析工具调用、把结果回填、再问模型、直到它不给工具调用为止。同一段代码换成 model="anthropic:claude-sonnet-4-6" 就能切厂商,不用改其它任何东西——这就是 LangChain 最核心的价值。
6.4 加三样生产必需的东西
Demo 到这里只是「能跑」。真上线还差三件事:记得住上下文、看得见中间过程、不把敏感信息喂出去。
① 记忆:给一个 thread_id
1 | from langgraph.checkpoint.memory import InMemorySaver |
注意两个坑:
thread_id划的是会话,不是用户。一个用户多个会话就该多个 id;InMemorySaver只活在内存里,进程一重启全丢。生产必须换SqliteSaver或PostgresSaver。
② 流式:让用户看到进度
一次工具调用可能等好几秒,界面干等着体验很差:
1 | stream = agent.stream_events( |
values 给的是每个节点执行完后的完整状态,适合做「过程可视化」;如果你要逐 token 输出,用 stream.messages 那一路。
③ middleware:敏感信息打码
1 | from langchain.agents.middleware import PIIMiddleware |
除了 PII,1.0 还内置了 human-in-the-loop(工具执行前暂停等人批)、summarization(历史太长时自动压缩)等中间件。这些就是「上下文工程」的现成产品化——你不用自己写,但要知道它在替你做什么。
6.5 顺手拿结构化输出
客服系统往往要和工单系统对接,需要的是 JSON 而不是一段话:
1 | from pydantic import BaseModel |
结果在 structured_response 这个键里,已经被 pydantic 校验过一遍。
七、Demo 二:用 LangGraph 搭一个能暂停等人审批的流程
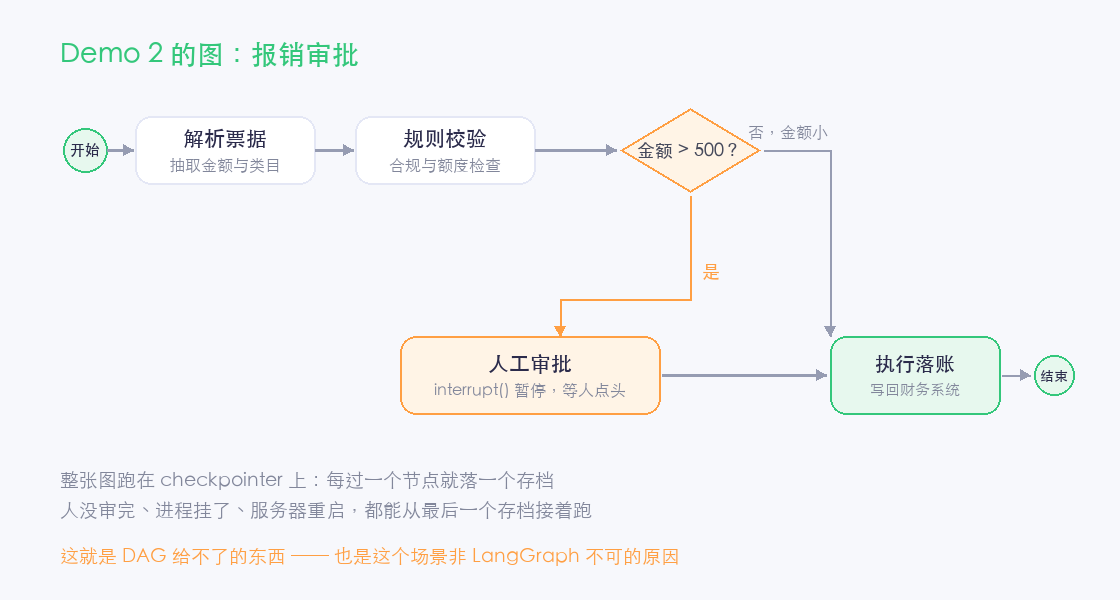
场景:员工提交报销,金额超过 500 元必须有人审批。审批人可能三天后才点。
这个场景为什么非 LangGraph 不可? 因为它是「跑一半停下,三天后接着跑」——中间进程早就没了。用链式写法,你要自己做序列化、做状态恢复、做幂等,做完发现你手写了一个 LangGraph。
7.1 先想状态,再写代码
LangGraph 的开发顺序和 LangChain 相反:先定 State,再填节点。状态设计错了,后面全是返工。
1 | from typing import Literal |
7.2 四个节点
每个节点就是一个「读 state、返回增量」的普通函数。注意返回值是增量,不是完整状态——LangGraph 会帮你合并。
1 | def parse(state: ExpenseState) -> dict: |
interrupt() 这一句是全篇的重点:它把当前状态存档、暂停执行、把 payload 抛给外层。三天后有人点了「批准」,流程从这一行继续,而 decision 拿到的就是审批结果。
7.3 连成图
1 | from langgraph.graph import StateGraph, START, END |
几个细节:
add_conditional_edges的第三个参数是可能的目标列表,显式声明能让图渲染正确,也方便静态检查;compile()必须带 checkpointer,否则interrupt()用不了——没有存档,就没有「接着跑」这回事;- 想看图画成什么样:
graph.get_graph().draw_mermaid_png()。
7.4 第一轮:跑到审批就停
1 | config = {"configurable": {"thread_id": "exp-2026-10-001"}} |
输出是审批 payload:
1 | {'question': '请确认是否批准这笔报销', 'amount': 1280.0, 'category': '差旅'} |
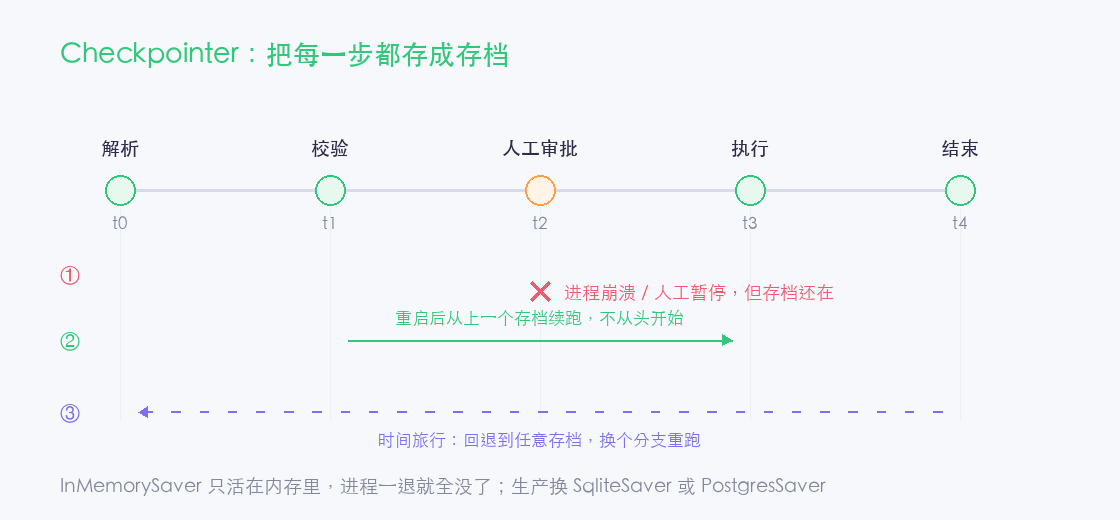
注意 graph.invoke() 到这里就返回了,没有报错、没有死循环。整个图的状态已经存进 checkpointer,进程可以安全退出。
7.5 三天后:用同一个 thread_id 接着跑
1 | from langgraph.types import Command |
Command(resume=True) 里的值,就是 interrupt() 那一行的返回值。
这里有个必须知道的坑:恢复时,节点会从函数开头重新执行,而不是从 interrupt() 那一行继续。所以 interrupt() 之前的代码会再跑一遍。如果你的节点前半段有副作用(发短信、扣库存),要放在 interrupt() 之后,或者做成幂等。
7.6 看清它到底存了什么
1 | state = graph.get_state(config) |
get_state_history 就是「时间旅行」的入口——你能看到每一步的存档,也能用 graph.update_state(...) 回到某个存档、改一个字段、换个分支重跑。调试 Agent 的时候这个能力价值极高:不用重跑整条流程,就能复现某个中间状态。
7.7 换成能真的活过重启的存储
1 | # pip install langgraph-checkpoint-sqlite |
生产环境换 PostgresSaver,并按需清理老 checkpoint——长时间运行的会话,存档会无限增长。
八、两个 Demo 放在一起看
同一个「客服 + 审批」的需求,两条路线的代码量大概是:
| Demo 1(LangChain) | Demo 2(LangGraph) | |
|---|---|---|
| 核心代码 | 约 15 行 | 约 60 行 |
| 你要想清楚的事 | 提示词、工具描述 | 提示词 + 状态结构 + 分支条件 + 中断点 |
| 出问题怎么查 | 看 trace,粒度是「一轮对话」 | 看 checkpoint,粒度是「一个节点」 |
| 加个人工审批 | 加中间件(有限定制) | 加一个 interrupt() 节点(任意定制) |
那个「60 行 vs 15 行」的差距,不是 LangGraph 啰嗦,而是那 45 行本来就是真实流程的复杂度。LangChain 用默认值把它藏起来了,LangGraph 要求你写出来。
什么时候这笔账划算?我的判断是:
- 流程能在一次会话内跑完 → 用 LangChain,藏起来是好事;
- 流程会跨越「人」和「时间」 → 用 LangGraph,那 45 行不是成本,是保险。
九、生产上真正会踩的坑
1. 把 InMemorySaver 带上了生产。
进程一重启,所有会话历史清空。这个 bug 在测试环境永远不会出现,上线第一天就会。
2. thread_id 用了用户 id。
一个用户同时开两个会话就会串味。thread_id 应该唯一标识一次会话,不是一个人。
3. 以为 interrupt() 是从断点那一行继续。
节点会从头重跑。有副作用的代码要么放 interrupt() 之后,要么做成幂等。
4. interrupt() 的 payload 塞了不可序列化的东西。
它必须是 JSON 可序列化的。把 ORM 对象、datetime 直接传进去会炸。
5. 一上来就画状态机。
大多数「Agent 需求」用 create_agent 加两个中间件就解决了。先证明简单方案不够用,再往下沉。
6. 忽略了版本断层。
0.x 时代的 AgentExecutor、initialize_agent 在 1.x 里已经不在主命名空间了(挪到了 langchain-classic)。照着 2023 年的博客抄代码,报错会报得莫名其妙。
十、总结
回到开头那个问题:LangChain 和 LangGraph 的区别是什么?
它们不是两个框架的比较,而是一条栈上两层的分工。
- LangChain 是框架:把模型、工具、检索标准化,用默认的 agent 循环和 middleware,让你在十几行代码里得到一个能用的 Agent。它替你做的决定越多,你上手越快,定制时改的也越多。
- LangGraph 是运行时:把 Agent 表达成带状态的图,每一步都是你的代码,每一步都有存档。它不替你做决定,但给你暂停、续跑、回溯的全部能力。
一条判断标准,拿走就能用:流程需不需要「回头」和「中断恢复」? 不需要,就用 LangChain 的流水线;需要,就上 LangGraph 的状态机。
最后一句:这两个东西的边界还会动。LangChain 1.0 已经把 agent 跑在 LangGraph 上了,未来「框架」这一层会越来越薄,「运行时」会越来越重要。所以真正值得学的不是某个 API,而是那个「带状态的循环」的模型——它才是这一代 Agent 框架共同的底层。
参考
 微信
 支付宝
欢迎来到李苟蛋的个人博客,对本站的文章和技术问题有疑问或建议,欢迎留言,或者关注我的公众号:狗蛋的智栈