Harness Engineering:当工程师的核心工作从写代码变成造环境
序言
先讲一个我个人的观察:过去一年,我身边聊 AI 编程的话题经历了一次静悄悄的迁移。
2025 年大家聊的是「哪个模型写代码更强」,比的是 benchmark 分数;2025 年底开始聊「上下文工程」,比的是谁能把该给的资料喂对;到了 2026 年春天,话题变成了另一个词——Harness Engineering,中文社区译作「驾驭工程」或「约束工程」。
这个转变有一个很朴素的判断打底:模型决定能力下限,Harness 决定效率上限。
同一个模型,有人用起来像高级实习生,交代的活七成能用;有人用起来像一支工程团队,PR 自己开、测试自己跑、错了自己修。模型是一样的,差的是模型外面那层东西——工具怎么配、上下文怎么管、错了怎么被发现、谁来判断「做完了」。
这篇文章想把这件事讲透。我会按五个部分展开:
- Harness Engineering 这个词是怎么诞生的——它不是被发明的,是被逼出来的;
- OpenAI 和 Anthropic 的两场实战——一家赌「仓库即环境」,一家赌「评估器分离」,路线差别很有意思;
- 两大争议的正反面——「新瓶装旧酒」和「迟早被模型吃掉」,各自有多少道理;
- 国内大厂的探索——腾讯、阿里、字节各自的打法,以及国内特有的三个约束;
- 我的几点思考——包括中小团队能从哪里开始。
一、一个词的诞生:六周,从个人习惯到行业名词
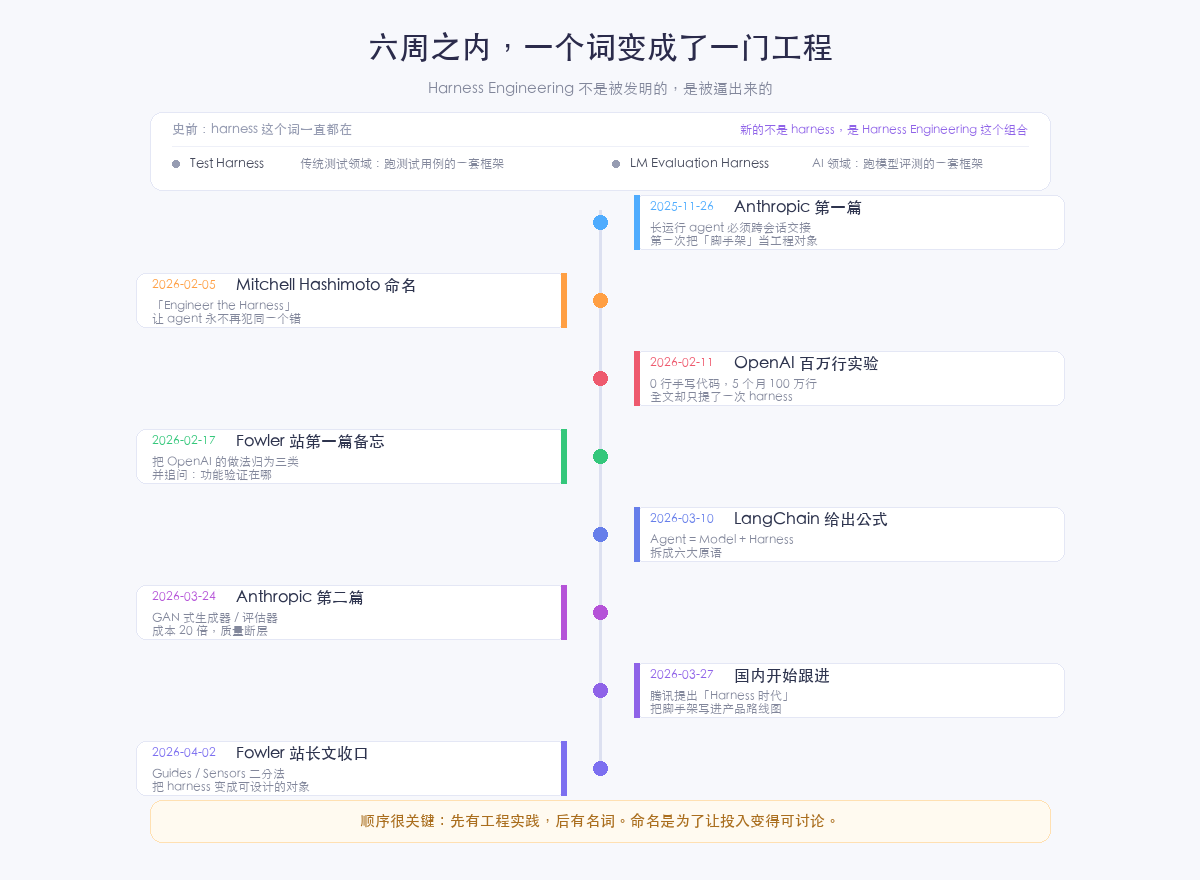
先把时间线钉住,因为这个词的流行速度本身就说明了一些问题:
| 时间 | 事件 |
|---|---|
| 2025-11-26 | Anthropic 发布《Effective Harnesses for Long-Running Agents》,第一次把「harness」作为正经工程对象来设计 |
| 2026-02-05 | Mitchell Hashimoto(Ghostty / HashiCorp 创始人)发《My AI Adoption Journey》,Step 5 直接命名为「Engineer the Harness」 |
| 2026-02-11 | OpenAI 发布《Harness engineering: leveraging Codex in an agent-first world》,百万行代码实验曝光 |
| 2026-02-17 | martinfowler.com 刊出 Birgitta Böckeler 的第一篇备忘,把 OpenAI 的做法归为三类 |
| 2026-03-10 | LangChain 发布《The Anatomy of an Agent Harness》,给出 Agent = Model + Harness 的公式 |
| 2026-03-24 | Anthropic 发布《Harness Design for Long-Running Apps》,GAN 式生成器/评估器架构出场 |
| 2026-03-27 | 腾讯汤道生在云城市峰会提出「AI 落地不只是算法题,更是工程题」,Harness 进入国内产品叙事 |
| 2026-04-02 | Fowler 站长文《Harness Engineering for Coding Agent Users》收口,提出 Guides / Sensors 二分法 |
有几个细节值得玩味。
第一,词是个人开发者先叫响的,但引爆靠的是大厂。 Mitchell Hashimoto 在文章里原话是:「我不知道这有没有一个行业公认的名词,我自己把它叫做 harness engineering——每当发现 agent 犯一个错,就花时间造一个方案,让它永远不再犯这个错。」他举的例子很接地气:Ghostty 仓库里 src/inspector/AGENTS.md 的每一行,都对应一条 agent 曾经犯过的错。有意思的是,这篇命名之作本身的讨论热度并不算高——真正让这个词出圈的,是几天后 OpenAI 那篇信息量极大的实战文章。一个朴素的私人说法,碰上一个大厂的公开战报,才算完成了从「个人习惯」到「行业名词」的跳变。
第二,OpenAI 全文只提了一次「harness」。 Fowler 站的文章专门指出了这一点:OpenAI 那篇标题里带 harness 的文章,正文只出现一次这个词。也就是说,OpenAI 是先做了五个月的工程实践,名词是后来补上的——Fowler 甚至推测这可能是受了 Hashimoto 的启发,事后才把词放进标题。先有实践、后有名词,这个词的生命力反而更足。
第三,harness 这个词本身一点也不新。 考一下词源会发现,它早就默默服役了几十年:传统软件测试领域的 Test Harness,指的是支撑测试代码运行的一整套框架(测试运行器、测试环境等);AI 领域大名鼎鼎的开源项目 LM Evaluation Harness,是跑模型评测的标准框架;Anthropic 第一篇文章里的 harness,指的是支撑 agent 长时间运行的框架。新造的不是 harness 这个词,而是「Harness Engineering」这个组合——把一直在私下使用的工程动作,上升成了一门可以系统讨论的学科。
第四,Anthropic 是最早把 harness 当工程对象的,但两家切入的角度完全不同。 这也是本文第三、四、五节的主线。
二、Harness 到底是什么:三层定义与一个公式
2.1 最清晰的公式
LangChain 那篇《The Anatomy of an Agent Harness》给了目前最清晰的定义:
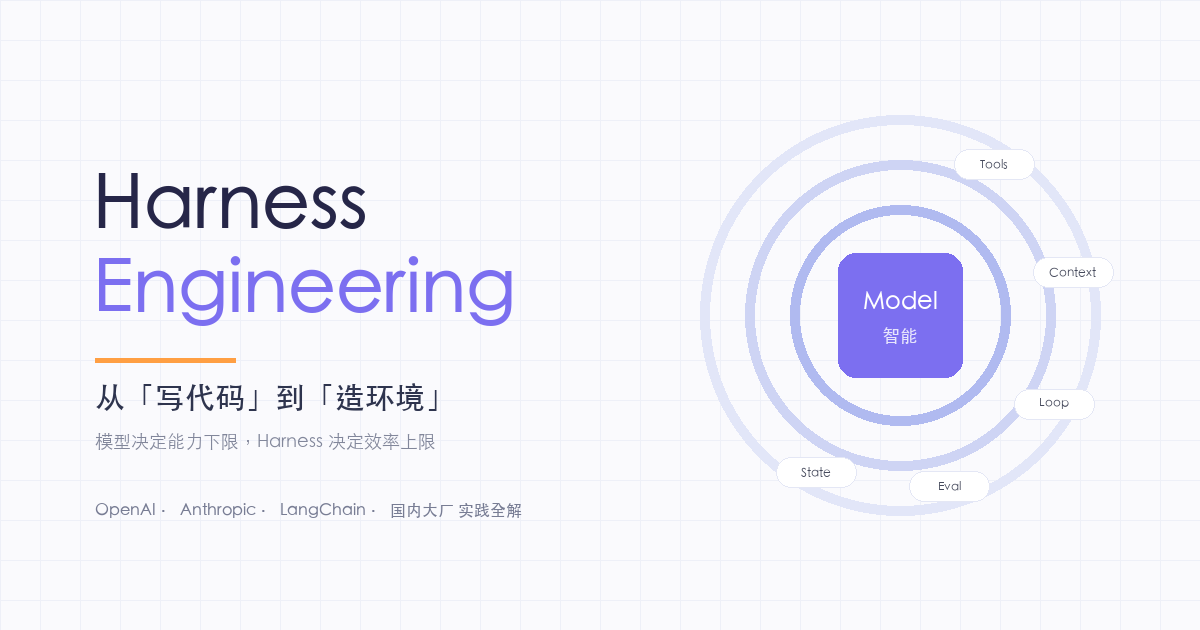
Agent = Model + Harness
Harness 是除模型本身之外的一切代码、配置和执行逻辑。模型包含智能,Harness 让智能变得有用。
这个公式还可以换一种更直观的写法:Harness = Agent − Model——一个完整的 Agent 减去大模型,剩下的所有东西都是 Harness。要强调的是,这不是严格的学术定义,目前业界也还没有公认体系,它只是多数人认可的一种说法。但好处是一眼就能看懂边界:拿 Claude Code 举例,CLAUDE.md 里那些模型要遵循的规则、它可以调用的工具、它的定时调度机制——凡是不是 Claude 模型本身的部分,统统属于 Harness。
这个定义的好处是足够宽——系统提示词、工具集、文件系统、沙箱、编排逻辑、钩子与中间件,全都装得进去。坏处也是太宽,所以 Fowler 站的文章又做了收窄:对使用编码 agent 的人来说,真正要动手搭的是「外层 harness」——编码 agent 自带的部分你改不了,但你可以为你自己的仓库、你自己的业务搭一层壳。
2.2 为什么需要它
从模型的视角看,这个问题一目了然。开箱即用的模型只会一件事:输入文本,输出文本。它不能持久化状态、不能执行代码、不能访问训练截止之后的知识、不能自己搭环境。这些能力全部来自框架层:
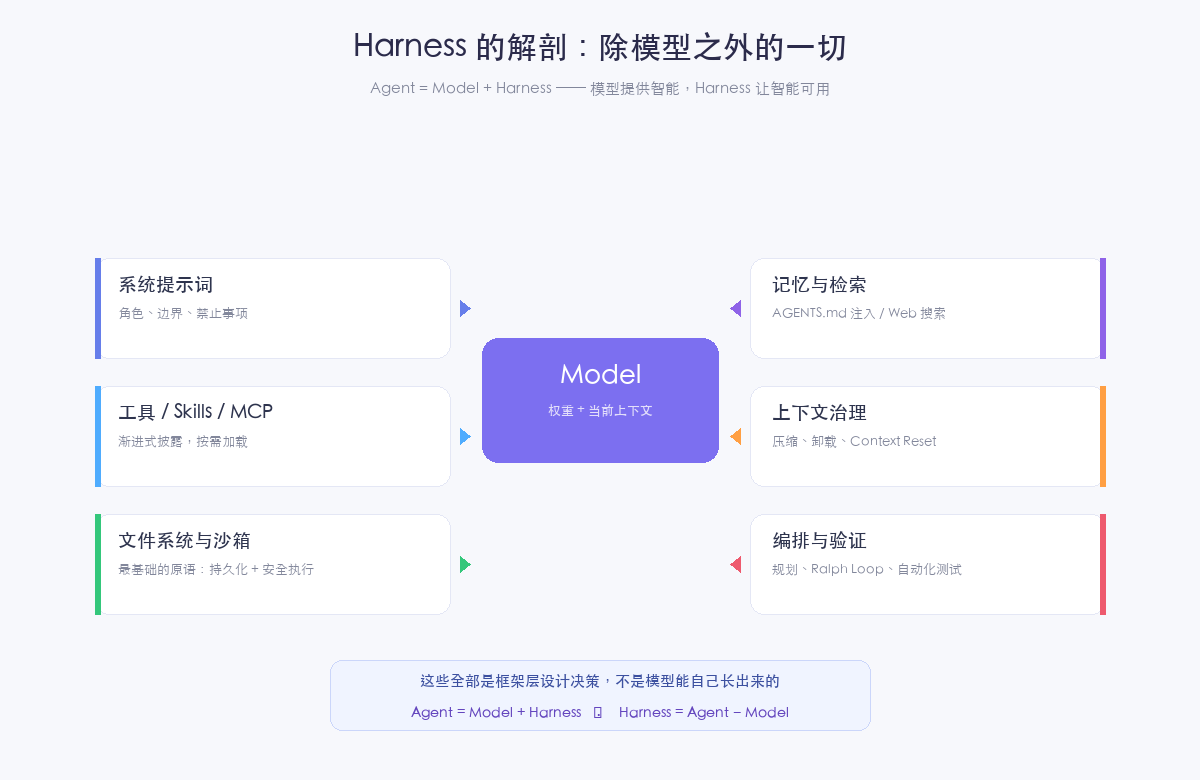
LangChain 把这些归纳为六大原语:文件系统(最基础的原语,解锁持久化、增量卸载、多 agent 协作)、Bash + 代码执行(让模型即时造自己的工具)、沙箱(安全执行 + 自我验证循环)、记忆与检索、上下文治理、长时程编排。
2.3 和 Prompt / Context Engineering 的关系
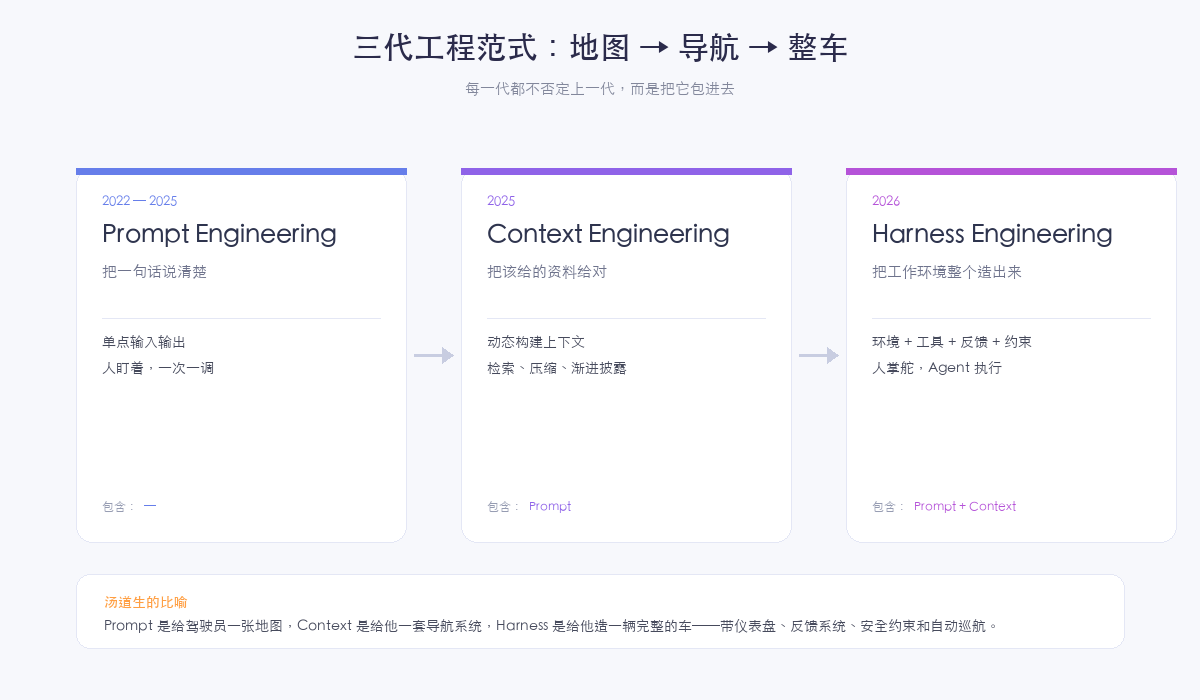
腾讯汤道生 2026 年 3 月底那篇被广泛转发的文章里,比喻打得最好:
Prompt Engineering 是给驾驶员一张地图,Context Engineering 是给他一套导航系统,Harness Engineering 是给他造一辆完整的车——带仪表盘、反馈系统、安全约束和自动巡航。
注意这是包含关系而非替代关系。每一代范式都不否定上一代,而是把它包进去。地图和导航仍然重要,但只有地图和导航、没有车,哪儿也去不了。
还有一个藏在 Anthropic 文章里、我认为最重要的元认知:
**「Harness 的每一个组件,都编码了一条关于『模型自己做不到什么』的假设。这些假设值得被压力测试——它们可能本来就是错的,而且会随模型进步迅速过时。」
这句话是全文的题眼,第八节我会展开。
三、OpenAI 实战:0 行手写代码的百万行实验
OpenAI 这篇是目前所有 harness 文章里信息密度最高的一篇,因为它不是方法论,是一份五个月的战报。
3.1 实验设定
设定本身就足够激进:一个空 git 仓库,0 行手写代码,工程师从不直接写代码,一切——产品代码、测试、CI 配置、内部工具、文档、甚至第一版 AGENTS.md——全部由 Codex 生成。五个月后:
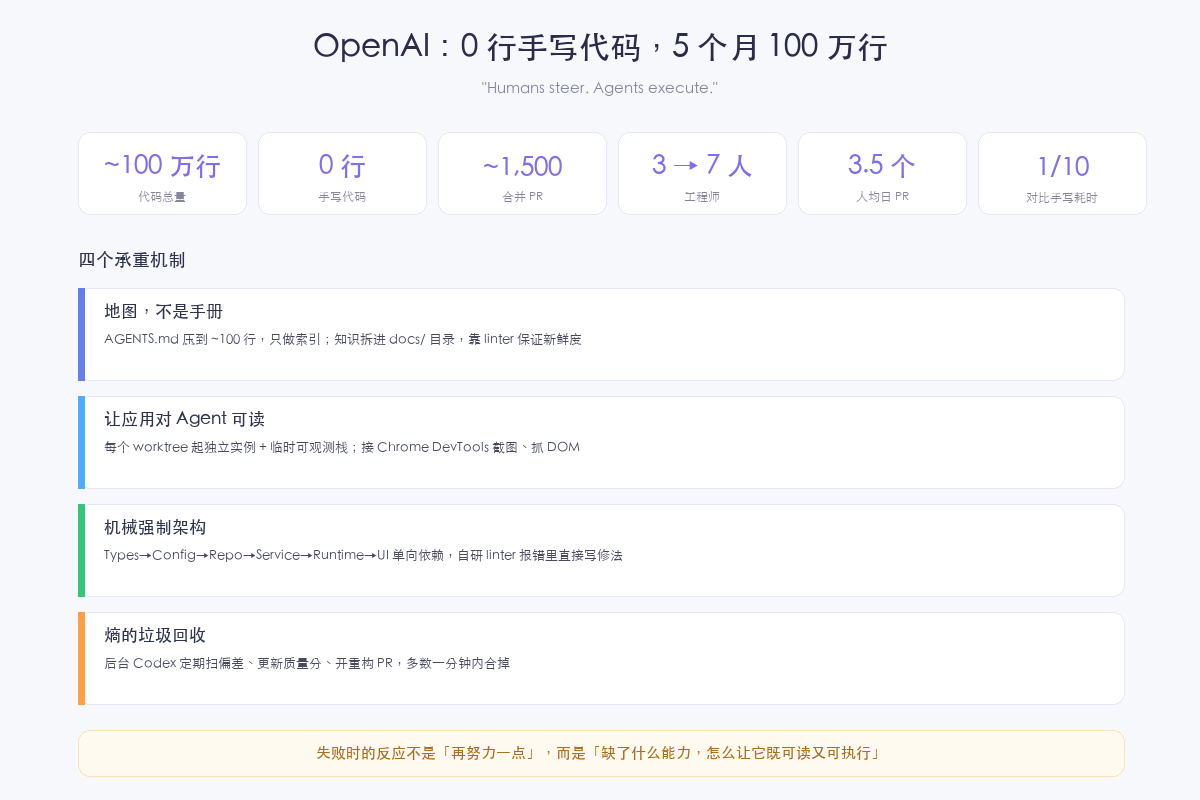
| 指标 | 数值 |
|---|---|
| 代码总量 | 约 100 万行(含基础设施、工具、文档) |
| 手写代码 | 0 行 |
| 合并 PR | 约 1,500 个 |
| 团队 | 3 人起步,后扩到 7 人 |
| 吞吐 | 人均 3.5 PR/天,且随团队扩大而上升 |
| 单次 agent 运行 | 常见超过 6 小时,常在人类睡觉时 |
| 效率对比 | 约为手工编码所需时间的 1/10 |
3.2 四个承重机制
早期进展并不顺利。团队复盘的结论很有意思:慢不是因为 Codex 能力不足,而是环境规格不足——agent 缺少推进高层目标所需的工具、抽象和内部结构。于是工程师的角色被重新定义:遇到失败,反应不是「再提示得好一点」,而是问「缺了什么能力?怎么让它对 agent 既可读又可执行?」
围绕这个问题,他们建了四个承重机制:
机制一:给地图,不给手册。 早期把所有规范堆进一个大 AGENTS.md,结果上下文被挤爆、指导变成噪音、文件迅速腐烂。后来 AGENTS.md 压到约 100 行,只做目录,知识拆进 docs/ 的结构化知识库,由专门的 linter 和 CI 校验新鲜度,还有常规的「doc-gardening」agent 定期扫过时文档、开修复 PR。上下文是稀缺资源——什么都重要,就等于什么都不重要。
机制二:让应用对 agent 可读。 瓶颈从代码产能转移到人类 QA 能力之后,他们给每个 git worktree 起独立应用实例、接 Chrome DevTools Protocol 让 agent 自己截图抓 DOM、配一套任务结束即销毁的临时可观测栈(日志、指标、链路追踪)。效果是「确保服务启动在 800ms 内完成」这类要求变得可执行、可验证。
机制三:机械强制架构。 严格的分层架构 Types → Config → Repo → Service → Runtime → UI,依赖只能单向流动;自研 linter 的报错信息里直接注入修复指令——「正向的提示注入」。这个在人类团队通常几百人规模才做的事,在 agent 时代成了早期前提条件:约束是「速度快而不腐化」的前提,不是代价。
机制四:熵的垃圾回收。 agent 会复制仓库里已有的模式——哪怕那些模式并不好。初期靠人类每周五花一天手动清理,完全不可规模化。后来把「黄金原则」编码进仓库,配后台 Codex 任务定期扫偏差、更新质量分、开定向重构 PR,多数一分钟内评审合掉。技术债像高利贷,持续小额偿还好过任其复利。
3.3 被忽视的代价
两个细节提醒我们别只看漂亮数字。
其一,初期 20% 的工作时间花在清理「AI slop」上——每周五全天。垃圾回收机制是被痛苦逼出来的,不是设计出来的。
其二,合并哲学变了:最小阻塞门禁,测试偶发失败常靠重跑解决。理由是「agent 吞吐远超人类注意力时,纠错便宜,等待昂贵」。OpenAI 自己也承认,这在低吞吐环境里是不负责任的。这套打法的前提是吞吐,不能只抄结论不抄前提。
四、Anthropic 实战(上):给长跑 agent 做「交接班」
Anthropic 的第一篇(2025-11)针对的是另一个问题:长时运行任务。让 agent 从零构建一个 claude.ai 克隆,即便用上当时最强的模型加上下文压缩,也达不到生产质量。他们归纳了三种失败模式:
- 贪多求快:想一次性做完整个应用,中途耗尽上下文,下一个会话面对半成品瞎猜;
- 过早宣布完工:后来的会话一看「已经有不少进展」,直接宣布任务完成;
- 未验证就标完成:跑了单测、curl 通了,但功能端到端根本不工作。
解决方案的灵感来自人类工程师最日常的行为——交接班:
想象一个软件项目由轮班的工程师负责,每个新来的工程师对上一班发生的事毫无记忆。
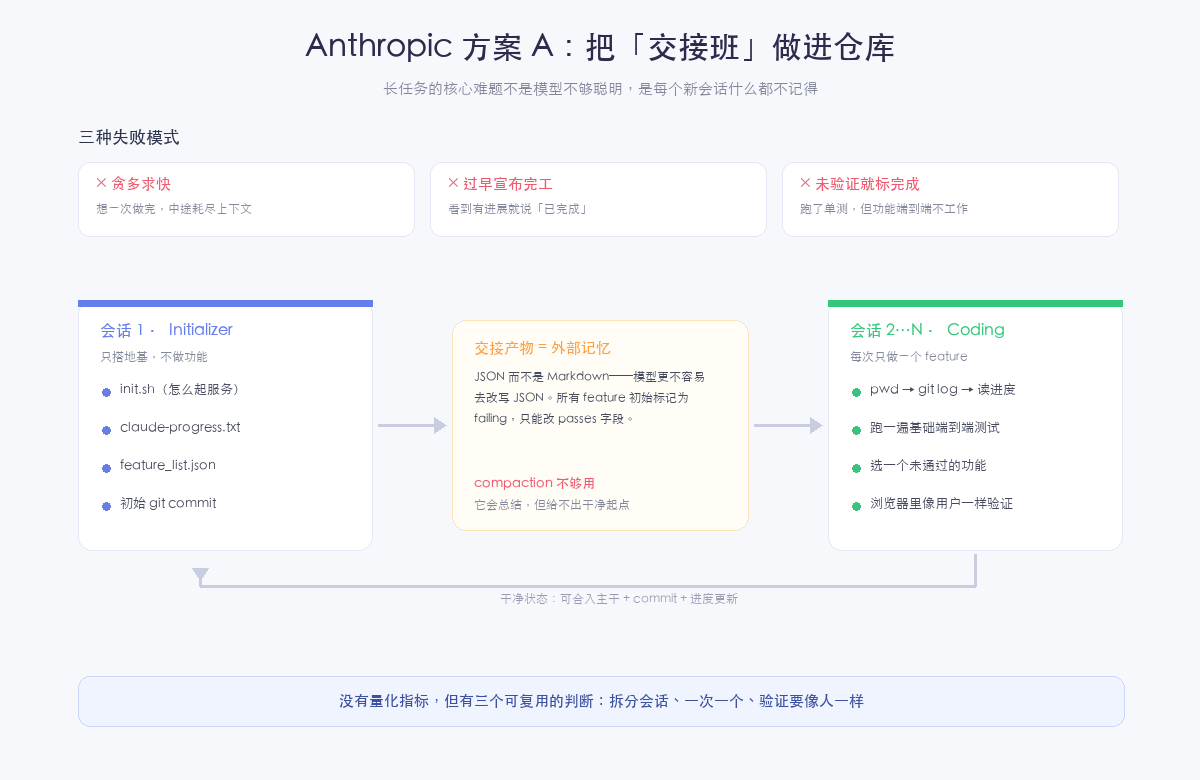
具体做法是双 agent 架构:
- Initializer agent 只跑第一个会话,负责搭地基:
init.sh(怎么起服务)、claude-progress.txt(进度日志)、feature_list.json(功能清单)、初始 git commit。以 claude.ai 克隆为例,功能清单展开成超过 200 条端到端功能描述,全部初始标记为failing。 - Coding agent 每个后续会话只做一个功能。会话开头固定动作:
pwd→ 读 git log 和进度文件 → 读功能清单 → 先跑一遍基础端到端测试确认应用没坏 → 再开工。
三个工程细节特别值得学:
为什么用 JSON 而不是 Markdown? 实验发现模型相对不容易去不当改写 JSON 文件。功能清单里硬性规定:coding agent 只能修改 passes 字段,「删测试或改测试是不可接受的」。对抗 agent 的「自说自话」,结构化约束比自然语言恳求有效得多。
为什么 compaction 不够? 压缩能延续对话,但给不出干净起点——压缩后的总结未必把关键指令传下去,上下文焦虑也还在。跨会话记忆要靠进度文件 + git 历史两个载体共同承担,而不是指望窗口内自愈。
验证要像人一样。 明确要求 agent 用浏览器自动化工具(Puppeteer MCP)「像人类用户那样做所有测试」,这让性能显著提升——很多 bug 只看代码看不出来。当然也有残留盲区:agent 看不见浏览器原生弹窗,依赖弹窗的功能就是更容易出 bug。
坦率说,这篇没给任何量化指标,全部是定性结论。但它给出了三个任何团队当天就能抄的判断:拆分会话、一次只做一个、验证要像用户一样。
五、Anthropic 实战(下):把评分外包给另一个 Agent
第二篇(2026-03)解决的是一个更根本的问题,Anthropic 的原话说得很不客气:
当被要求评估自己产出的工作时,agent 往往会自信地夸奖——即便在人类观察者看来质量明显平庸。
「这个设计好不好」没法稳定回答,但「它是否符合我们的四条设计标准」可以。于是他们借鉴 GAN 的思路,把生成和评估拆成不同的 agent。这里值得注意两篇文章的演进关系:第一篇里干「拆需求」这活的是 Initializer agent——拆需求、写 init.sh、记进度一把抓;第二篇把其中最关键的「把模糊需求扩展成功能列表」单独拎出来,升级成了独立的 Planner。至此规划、执行、评估三种职责彻底分离:
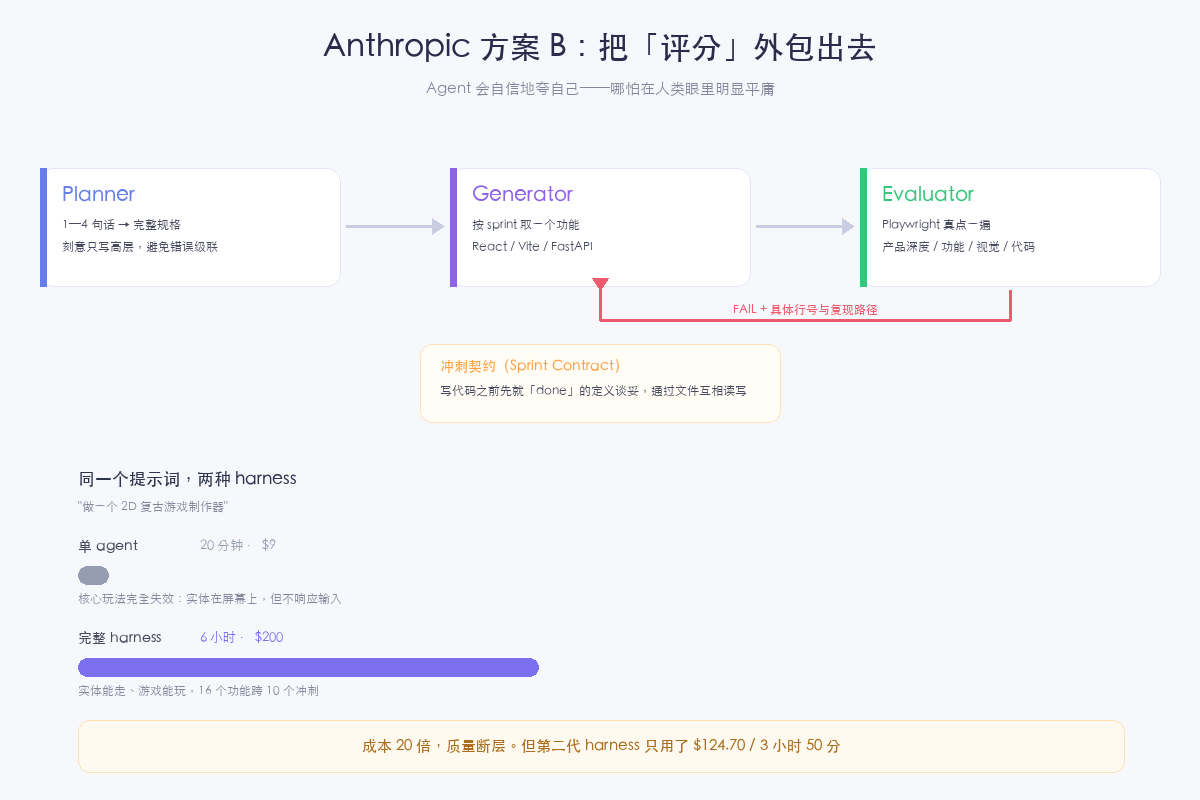
- Planner:把 1—4 句话的 prompt 扩展成完整产品规格。刻意只写高层设计、大胆定范围——因为规划器若过早指定技术细节且出错,错误会级联到下游;
- Generator:按冲刺(sprint)从规格里一次取一个功能实现,每个冲刺结束先自评再交 QA;
- Evaluator:配 Playwright MCP,像用户一样真实地点一遍应用,按「产品深度、功能、视觉设计、代码质量」四个标准打分,每条都有硬性阈值,低于阈值冲刺即失败。
两个机制特别精巧。一是冲刺契约:写代码之前,生成器和评估器先就「done 的定义」谈妥,通过文件互相读写——规格是高层的,契约负责弥合「用户故事」到「可测试实现」之间的鸿沟。二是评估器输出的不是笼统差评,而是带文件名行号的复现路径,比如「LevelEditor.tsx:892 的删除处理器条件写错」「FastAPI 路由把 reorder 匹配成了整数 frame_id 返回 422」。
效果如何?同一个提示词「做一个 2D 复古游戏制作器」:
| 方案 | 时长 | 成本 | 结果 |
|---|---|---|---|
| 单 agent | 20 分钟 | $9 | 核心玩法完全失效:实体在屏幕上,但不响应输入 |
| 完整 harness | 6 小时 | $200 | 实体能走、游戏能玩;16 个功能跨 10 个冲刺 |
成本 20 倍,质量是断层差异。 这个权衡其实和人类考试一样:考 60 分也许复习三天就够,考 90 分得复习一个月——精雕细琢是有代价的。而简化后的第二代 harness 做浏览器 DAW,降到了 $124.70 / 3 小时 50 分,agent 能连续构建 2 小时保持连贯,最后交付了一个能通过提示词作曲、铺轨、混音的可用 DAW。
这篇文章最珍贵的部分其实是做减法的方法论:模型从 Opus 4.5 升到 4.6 后,他们发现「按冲刺分解」不再必要——模型已经能原生处理长任务的分块;但 Planner 和 Evaluator 依然承重。于是得到那条关键结论:
评估器不是一个固定的「是 / 否」决策。只有当任务超出当前模型可靠独力完成的范围时,它才值得这个成本。
换句话说:harness 的边界会随着模型进步而移动,每个模型升级都要把组件拆下来重测一遍。
六、两条路线的对照
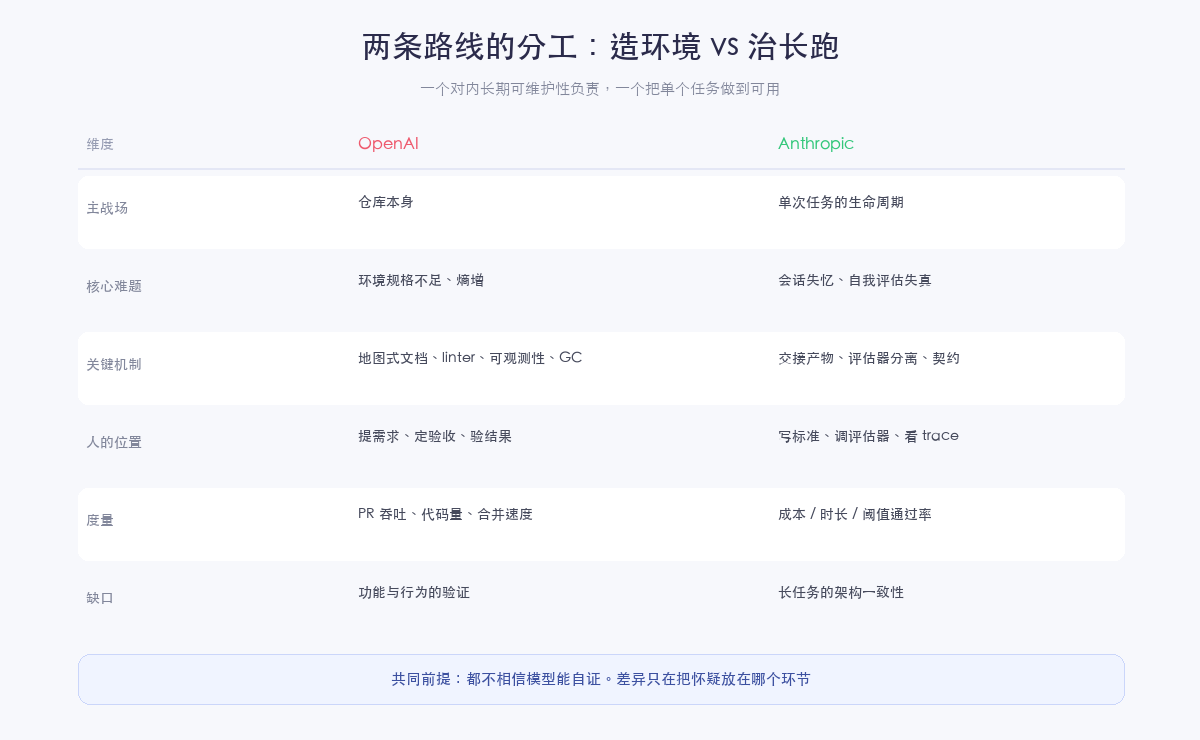
把两家的实战放在一张表里,分歧和共识都很清楚:
| 维度 | OpenAI | Anthropic |
|---|---|---|
| 主战场 | 仓库本身(长期可维护性) | 单次任务的生命周期 |
| 核心难题 | 环境规格不足、熵增 | 会话失忆、自我评估失真 |
| 关键机制 | 地图式文档、linter、可观测性、GC | 交接产物、评估器分离、冲刺契约 |
| 人的位置 | 提需求、定验收、验结果 | 写标准、调评估器、看 trace |
| 度量 | PR 吞吐、代码量、合并速度 | 成本 / 时长 / 阈值通过率 |
| 未解决 | 功能与行为的验证 | 长任务的架构一致性 |
共识只有一条,但足够硬:都不相信模型能自证。 差别只在把怀疑放在哪个环节——OpenAI 用确定性的 linter 和结构测试怀疑每一行代码,Anthropic 用一个独立调校的评估器怀疑每一次「我做完了」。
Fowler 站的 Birgitta Böckeler 补了两刀,值得记录。第一刀指向 OpenAI:整套机制都在提升长期内部质量,但功能与行为的验证在哪里?AI 生成的测试套件不值得过度信任,这是目前所有团队的房间里的大象。第二刀是概念工具:她把 harness 拆成 Guides(前馈,行动前引导) 和 Sensors(反馈,行动后纠偏),每个又分计算型(linter、架构测试,毫秒级、确定)和推理型(LLM 审查、LLM as judge,慢、贵、非确定)。尤其强的是让传感器输出「为 LLM 消费优化的信号」——linter 报错里直接写怎么改。她还提了一个很有想象力的判断:harness 模板可能会成为新时代的 service template——团队按应用拓扑选一套现成的 guides + sensors 起步,再按业务塑形。
七、争议:新瓶装旧酒,还是真的有东西?
复盘完两家的实战,必须直面这个概念目前最大的争议——Harness Engineering 到底是不是噱头?
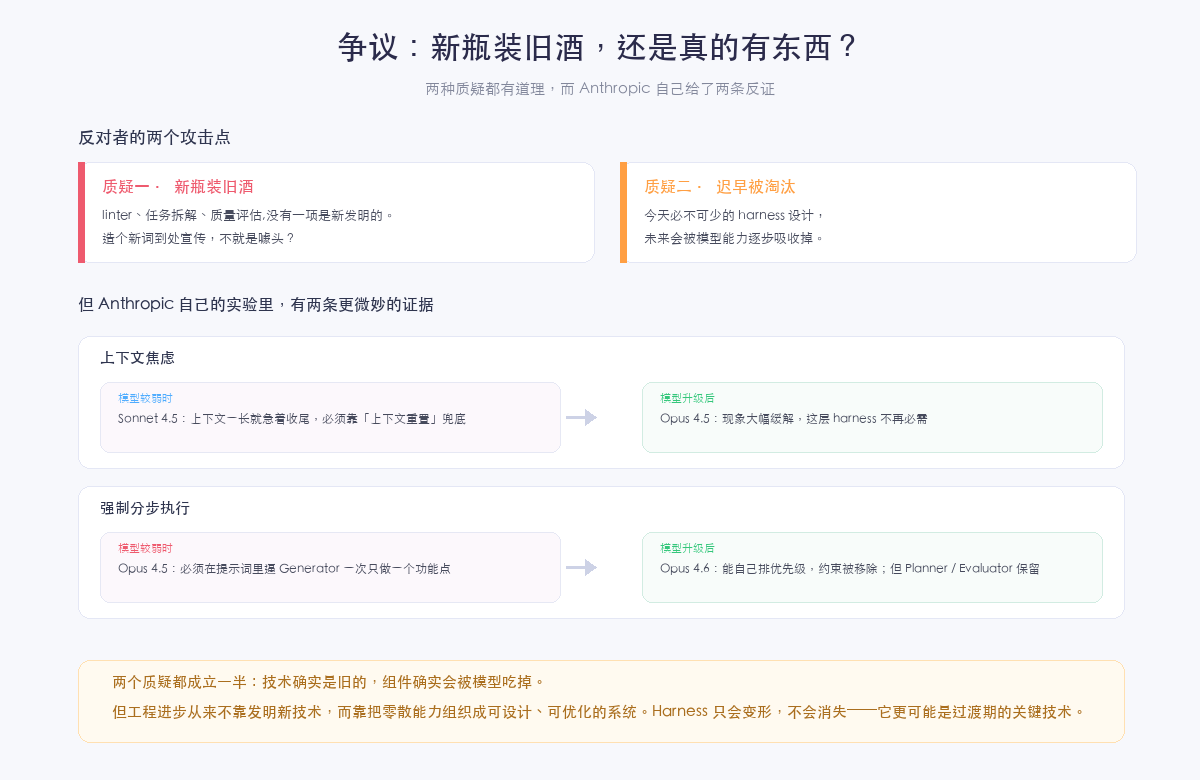
反对者的攻击点主要有两个:
- 新瓶装旧酒。 冷静盘一盘就会发现,harness 里用到的技术没有一项是新的:linter 代码检查、任务拆解规划、质量评估机制,很多工程师甚至一直在做相关的工作。Harness Engineering 真正做的,只是把这些技术重新组织到一个新词下面——提供的是一套新的系统思维架构,而不是一批颠覆性新技术。既然如此,特意造词宣传,不是噱头是什么?
- 迟早被淘汰。 随着模型能力持续增强,今天这些用来约束模型、纠正模型、给模型兜底的设计,很可能被模型自身逐步吸收,最终不再需要。
这两个质疑并非空穴来风,而且有趣的是,Anthropic 自己的实验里就藏着两条「模型吃掉 harness」的实锤:
其一,上下文焦虑。Sonnet 4.5 有个毛病:上下文越长越急着收尾,倾向于用更少的 token 草草交付。Anthropic 当时的对策是一种叫「上下文重置」的 harness 技术——与其硬撑,不如清空重来、靠交接产物续命。但模型升级到 Opus 4.5 后,这个现象大幅缓解,这层 harness 就不再必需了。
其二,强制分步执行。Opus 4.5 时代,必须在提示词里硬性要求 Generator 一次只做一个功能点,否则它就会急于求成留下一堆烂摊子。到了 Opus 4.6,模型的全局统筹能力已经够强,能自己决定先做哪个、再做哪个——这个约束被直接移除了。不过注意,Planner 和 Evaluator 依然保留:被吃掉的是流程管控,没被吃掉的是规划与评估的职责分离。
我的看法是:Harness Engineering 不是噱头,但大概率也不是终局。
说它不是噱头,是因为工程领域真正的进步,从来不在于发明了什么新技术,而在于有没有一套统一的框架,把零散的能力组织成可以系统设计、可以持续优化的工程方法。Git 没有发明 diff,CI 没有发明编译,但它们都改变了行业。Harness Engineering 的意义正在于此——何况 OpenAI 和 Anthropic 的成果都是可验证的工程产出,不是概念表演。
说它不是终局,是因为「模型越强,需要的 harness 越少」这个趋势是真实存在的。Anthropic 官方的表述倒是乐观:harness 的形态会随模型进化,去解锁更复杂的任务——harness 只会变形,不会消失。但不妨大胆推演一下:如果模型强到离谱呢?也许只需要最基础的 harness,模型自己就能搞定剩下 99% 的问题,到那时 Harness Engineering 会退化成一个环境接口、一层基础设施。
所以更准确的定位是:Harness Engineering 是过渡期的关键技术。 它不是终局答案,但是当下最现实的答案——只要模型还会犯错、还有幻觉、还会在复杂任务中跑偏,谁能把 harness 搭得更稳,谁就能更早把 AI 的能力兑换成生产力。
八、国内的探索与落地
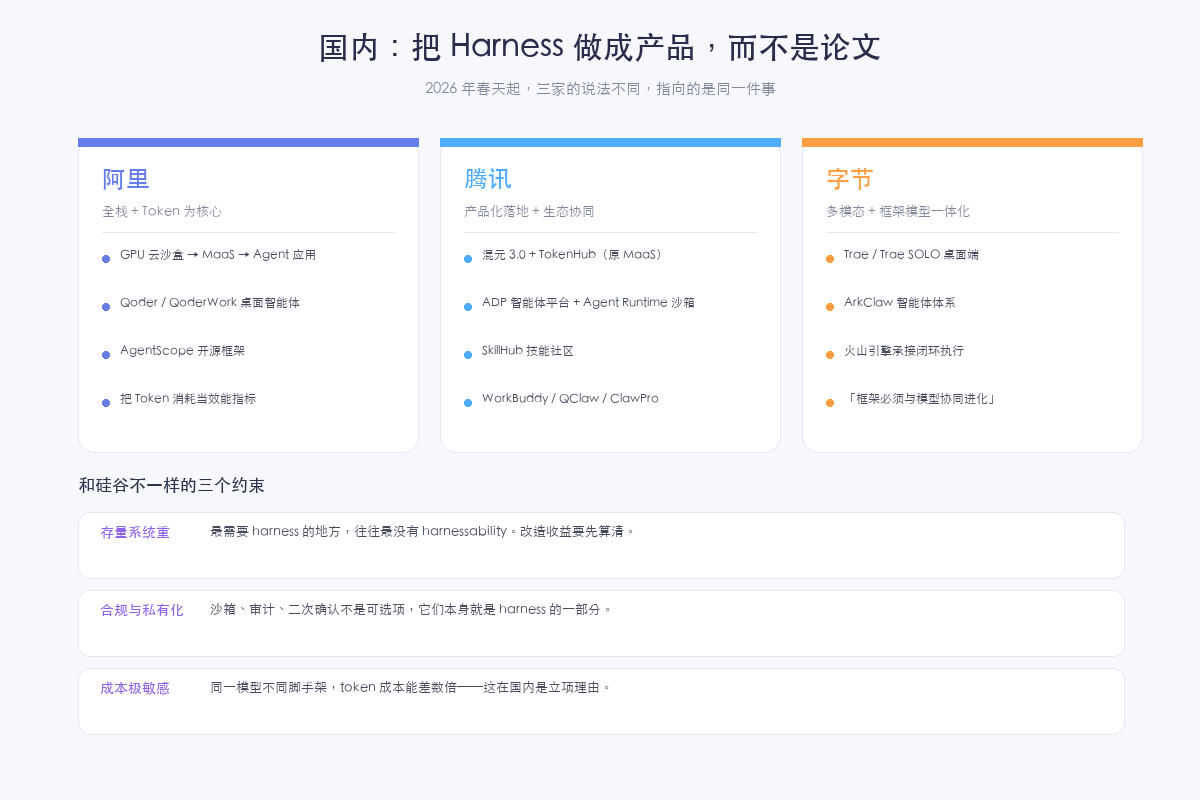
国内这一波跟进速度很快,而且有个鲜明特点:海外把 harness 当工程方法论在写博客,国内把它当产品叙事在做发布。
8.1 腾讯:Harness 时代的定义者
腾讯是把这个概念推到国内台前的主力。汤道生 2026 年 3 月底在两场公开场合系统表述了「人工智能正式进入 Harness 时代」的判断,核心论点有三个:
- 主流大模型的能力差距正在缩小,企业比拼的不再是谁的模型更强,而是谁能通过工程化手段把模型用好;
- 模型是发动机,Harness 是线束,使用者是驾驶员——三者缺一不可,但价值权重正在重新分配;
- Harness 让大模型更安全:权限边界、沙箱隔离、操作审计、人工审批,这是 AI 进入企业生产环境的前提。
落到产品上是一套完整拼图:混元 3.0 夯实模型底座;MaaS 平台升级为 TokenHub;智能体开发平台 ADP 用 RAG 和知识库给 agent 接上「图书馆」;Agent Runtime 提供安全沙箱,支撑强化学习的结果验证;再配上 SkillHub 技能社区和 WorkBuddy、QClaw、ClawPro 等面向 C 端和企业的「龙虾」系产品。值得注意的是,腾讯对 Skills 的定位很高——基于自然语言描述的能力单元可以被不同 Harness 框架调用,这让技能生态成为跨框架的通用资产。
8.2 阿里:全栈 + Token 为核心
阿里的路线是全栈纵深:从 GPU、云沙盒,到 MaaS 平台,再到 Agent 应用。产品侧 Qoder / QoderWork 桌面智能体上线几个月拿下几十万用户,官方披露近 80% 用户日均发起 3 次以上任务;框架侧持续投入开源的 AgentScope,并发布了 Harness 低代码部署套件,强化多模型调度与 RAG 的协同。一个有意思的内部信号是 Qoder 负责人提出「AI 原生组织要鼓励使用 Token」——把 token 消耗当效能指标而非成本负担,这和「纠错便宜、等待昂贵」的硅谷逻辑是同一个意思。
8.3 字节:框架与模型协同进化
字节的牌是多模态与框架一体化。火山引擎总裁谭待对 Harness Engineering 的回应只有一句但很关键:「框架必须与模型协同进化」——旗下 ArkClaw 智能体体系支撑多模态与复杂任务的闭环执行。产品侧在 Trae 基础上推出 Trae SOLO 桌面版,同时覆盖写代码和其他生产力场景,工程师和产品经理都能用。这句「协同进化」其实是 Anthropic 那套「harness 组件编码了模型能力假设」的产品化表述:模型升级,harness 跟着重调。
8.4 和硅谷不一样的三个约束
国内落地没法照搬硅谷打法,我观察有三个结构性差异:
存量系统重。 Fowler 站那句话在国内尤其扎心:「最需要 harness 的地方,往往最难建 harness。」国内企业的核心系统大多技术栈陈旧、模块边界模糊、缺类型约束——harnessability 极低。改造一个遗留系统到「可被 agent 治理」,收益要先算清楚。
合规与私有化是硬约束。 沙箱隔离、操作审计、数据不出域、二次确认——这些在硅谷博客里是「最佳实践」,在国内是企业采购的前置条件。反过来看这也是机会:这些安全组件本来就是 harness 的一部分,国内厂商把「管控」做成了产品差异化。
成本极敏感。 「同一个模型不同脚手架,token 成本差数倍」在国内不是技术细节,是立项理由。这解释了为什么阿里的叙事核心是 Token、腾讯把 MaaS 直接改名 TokenHub——token 的单位经济学,就是国内 harness 竞赛的计分板。
九、我的几点思考
最后给几条我自己的判断,供参考也供批评。
第一,约束不是对智能的压制,而是对智能的引导。 这是所有实战不约而同验证的反直觉结论:给模型无限自由,它反而花大量 token 探索死胡同;定义清晰边界,agent 更快收敛。Cursor 团队、OpenAI 的分层强制、Anthropic 的硬阈值,讲的是同一件事。
第二,评估器比生成器更需要投入。 大家的直觉是把钱花在「做得更好」上,但实战数据说明钱该花在「知道做得好不好」上。Agent 是个自信的夸奖机器,没有独立调校过的评估器,整个循环就是在自我表扬中过拟合。
第三,harness 是易耗品,不是固定资产。 回到那句题眼——每个组件都编码了一条「模型做不到 X」的假设,而模型版本的每次跳变都在作废其中一部分(第七节的两条实锤就是证据)。所以别追求一步到位的完美 harness,要建的是持续做减法的机制:模型升级时,把组件一个一个拆下来重测,不承重的拆掉。有趣 harness 组合的空间不会随模型进步而缩小,而是会移动。同时也要接受它的过渡属性:它不是终局答案,而是当下最现实的答案。
第四,harnessability 是一种架构属性,选型时值得为它付溢价。 强类型、清晰模块边界、结构化日志、无聊而稳定的技术栈——这些传统意义上的「工程美德」,在 agent 时代多了一重身份:它们决定了你的仓库能被多深的 harness 治理。选技术栈时问一句「agent 好不好建模」,不再是个玩笑。
第五,人的位置上移了一层,但没有消失。 OpenAI 的工程师「从不写代码」,但他们的全部工作是确定优先级、把用户反馈翻译成验收标准、验证结果;汤道生的说法是驾驶员从操作者升级为委托人——不再告诉 AI 怎么跑,而是告诉它去哪里。当机器什么都能干的时候,「干什么」变成了唯一重要的问题。品味被捕获一次,然后在每一行代码上持续执行——这可能是这个时代对工程师最浪漫的定义。
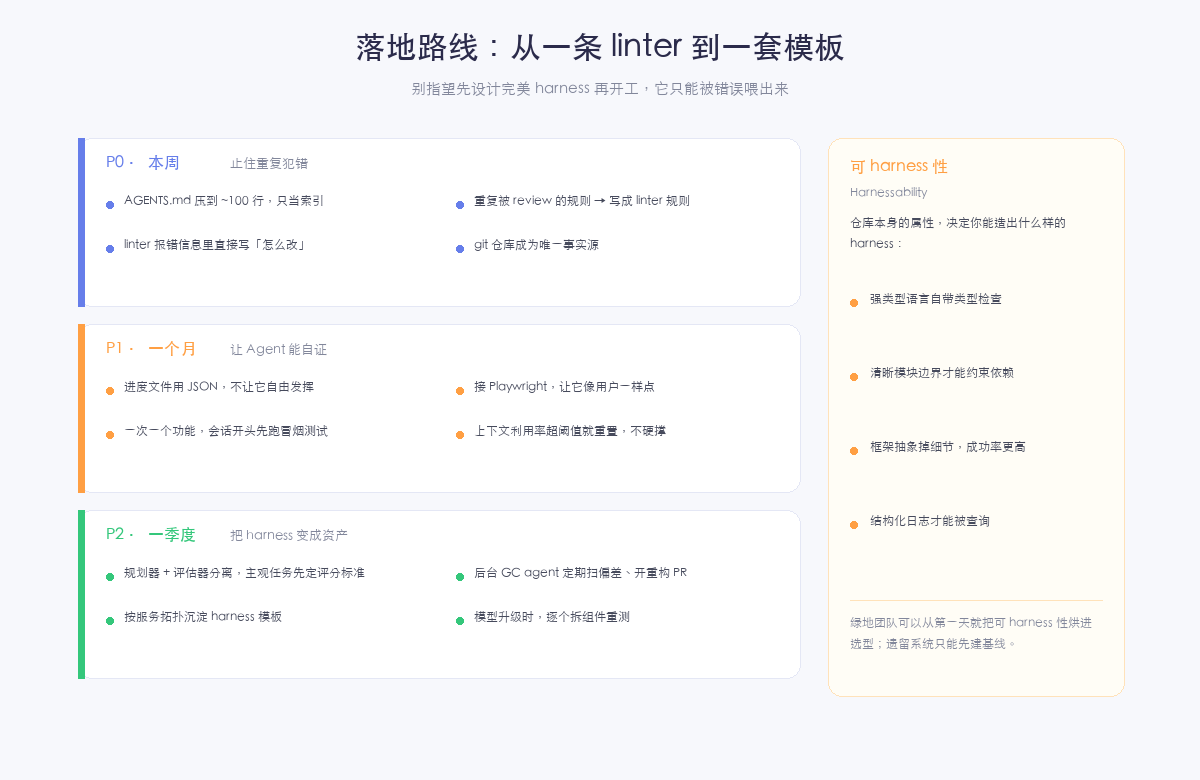
如果你在中小团队、看完想动手,我按 P0 / P1 / P2 整理了一份渐进路线(见上图),核心就一句:别指望先设计完美 harness 再开工,它只能被你的错误喂出来——每犯一次重复的错,就造一个机制让它不再发生。从一条报错信息里写着修复方法的 linter 开始,就够了。
十、结语
Harness 这个词的本义是马具:缰绳、马鞍、挽具。数千年前人类第一次给马套上缰绳,改变世界的不是马的力量,而是那套驾驭系统。
今天大模型就是这匹力量惊人的野马。过去三年全世界的注意力都在「马」身上,2026 年开始,竞争转移到了「缰绳」上——而缰绳的尽头,永远握在一个知道目的地的人手里。
参考
- OpenAI — Harness engineering: leveraging Codex in an agent-first world
- Anthropic — Effective Harnesses for Long-Running Agents
- Anthropic — Harness Design for Long-Running Application Development
- LangChain — The Anatomy of an Agent Harness
- Mitchell Hashimoto — My AI Adoption Journey
- martinfowler.com — Harness Engineering: first thoughts
- martinfowler.com — Harness Engineering for Coding Agent Users
- 新华网 — 腾讯汤道生:AI 落地不只是算法题,Harness 工程能力是关键变量
- B 站 — 马克的技术工作坊《Harness Engineering 到底是什么?概念、实战与争议,一次全部讲清楚》(关于词源考古与争议部分受到这期视频启发)
 微信
 支付宝
欢迎来到李苟蛋的个人博客,对本站的文章和技术问题有疑问或建议,欢迎留言,或者关注我的公众号:狗蛋的智栈