总指挥 + 质检员:2026 传统行业企业级 Agent 的三层多智能体落地方法论
序言
2026 年,AI Agent 正在从「会聊天」走向「能干活」。传统企业不再是看热闹,而是真正把 Agent 接进 ERP、CRM、数据库、工单系统,让它处理财务对账、信贷尽调、生产排程、设备维修、客服质检这些脏活累活。
但落地越深,问题越明显:一个 Agent 扛不住复杂业务。给它 5 个工具,它还能正常使唤;工具一多,上下文窗口被工具描述塞满,推理质量开始跳水;让它既做规划又写代码还管风控,它就成了样样通样样松的通才;一旦某个环节出错,整条链路都得重来。
解决方向很清晰:把 Agent 拆成多个专职智能体,用 LangGraph 做状态机编排。2026 年企业级的主流实践,是「总指挥 + 执行团队 + 质检员/风控官」的三层结构:
- 总指挥(规划层)负责拆解任务、调度 Agent;
- 执行层负责调用 Skill 工具库、对接企业系统;
- 质检员/风控官(验证层)负责审查结果、拦截风险、决定放行还是回退。
这篇文章会把它讲透:先讲清架构,再讲每层的实现细节,然后给一段可运行的 LangGraph 代码,最后补上传统行业落地案例和趋势判断。
一、先建立全局认知:单智能体为什么不够用
1.1 从「能回答」到「能干活」的跃迁
2026 年,Agent 的能力边界在快速外扩。浦发银行已累计建设 440 多个 AI 应用、落地 220 多个智能体,承载了超过 2500 人年的工作量;赛力斯在财务、IT、质量等部门部署了 30 多个智能体,财务对账每月 80 小时的工作量被压缩到 10 多小时,自动化率达到 95%。
这些场景的共同特点是:不是问一句答一句,而是围绕一个目标跑多步流程。
比如「对公信贷尽调」:要读财报、查舆情、调工商、算指标、写报告、过风控。单 Agent 要把这几件事全做对,上下文窗口里的工具描述和中间结果会迅速爆炸。
1.2 单智能体的三重天花板
| 维度 | 问题 | 表现 |
|---|---|---|
| 上下文窗口 | 工具描述 + 中间结果挤占 token | 超过 5~7 个工具后推理质量明显下降 |
| 专业深度 | 通才 Agent 样样松 | 财务、代码、风控混在一个角色里,难以做深 |
| 可靠性 | 单点失败 | 一处错误导致整条链路推倒重来,缺少独立审查 |
LangGraph 社区的经验值是:单 Agent 超过 5~7 个不同职责后,继续堆功能会换来明显的质量衰减。优码云内部基准也给过一个数据:同一份任务集,单智能体完成率约 67%,拆成 4 个专职智能体后完成率提升到 94%。
1.3 企业的解法:分层 + 专业化 + 治理
既然一个 Agent 装不下所有能力,那就把能力拆开:
- 规划:只做「想明白要干嘛」,不碰执行细节;
- 执行:只做「把动作完成」,不替系统做全局判断;
- 质检/风控:只做「审查结果对不对、能不能放」,不合格就回退。
这种分层最大的好处不是性能,而是可治理:每一层都能独立升级、独立回滚、独立审计。当业务变了,你只需要替换某一层里的一个 Agent,而不是重写整条链路。
二、三层多智能体架构总览
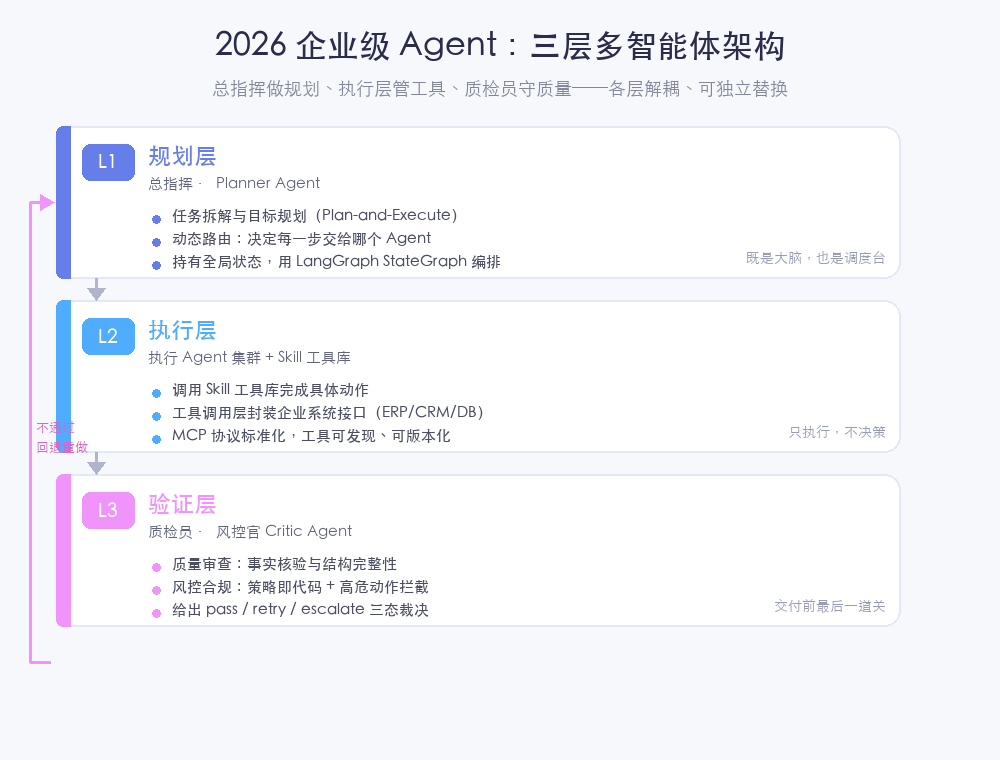
上图把三层结构说得很清楚:
| 层级 | 角色 | 核心职责 | 对应 Agent | 关键产出 |
|---|---|---|---|---|
| 规划层 | 总指挥 | 目标拆解、任务规划、动态路由 | Planner Agent | 结构化的执行计划 |
| 执行层 | 执行团队 | 调用工具、操作企业系统、返回结果 | Executor Agent 集群 + Skill 工具库 | 工具执行结果 |
| 验证层 | 质检员/风控官 | 质量审查、事实核验、合规拦截、三态裁决 | Critic Agent | pass / retry / escalate |
三层之间通过共享状态(Shared State)通信。这个状态里通常包含:
task:原始任务;plan:规划层输出的步骤列表;results:执行层写回的中间结果;tools_used:执行过程中调用了哪些工具;verdict/confidence:验证层给出的裁决与置信度;feedback:验证层不通过时给出的修改意见。
三、规划层:LangGraph 搭架构做规划
3.1 StateGraph 与共享状态
LangGraph 的核心是把 Agent 流程建模为状态机。节点是 Agent 或工具函数,边是状态流转规则。每个节点只读取状态、更新状态,不直接调用其他节点,这使得整个图可观测、可恢复、可审计。
一个典型的三态 State 可以定义成:
1 | from typing import TypedDict, List, Optional |
3.2 Plan-and-Execute
规划层的核心模式叫 Plan-and-Execute:先一次性(或滚动)生成执行计划,再交给执行层逐步执行。与单步 ReAct 不同,Plan-and-Execute 更适合高风险、可审计的企业场景——因为计划本身可以先被审批、存档、复现。
3.3 结构化输出 PlannerOutput
生产环境里不要信任模型自由输出的 JSON。LangChain/LangGraph 支持用 Pydantic 定义输出契约,通过 with_structured_output 强制模型返回结构化数据:
1 | from pydantic import BaseModel |
这样做的好处是:消除解析类 Bug。在 Agent 之间传递 raw string 很容易出错;传递 Pydantic 对象则可以在编译期就约束字段类型。
3.4 总指挥如何动态路由
总指挥不是写死的 if-else。它是一个 LLM 节点,读取当前状态后,用结构化输出决定「下一步交给谁」。这可以是:
- 并行派发多个执行 Agent;
- 根据执行结果决定跳回规划、继续执行还是送质检;
- 识别出高风险动作时,直接触发人工复核。
四、执行层:Skill 工具库 + 工具调用层
执行层的任务是:总指挥说要做啥,我就把它干完。但具体怎么干,由工具层负责。
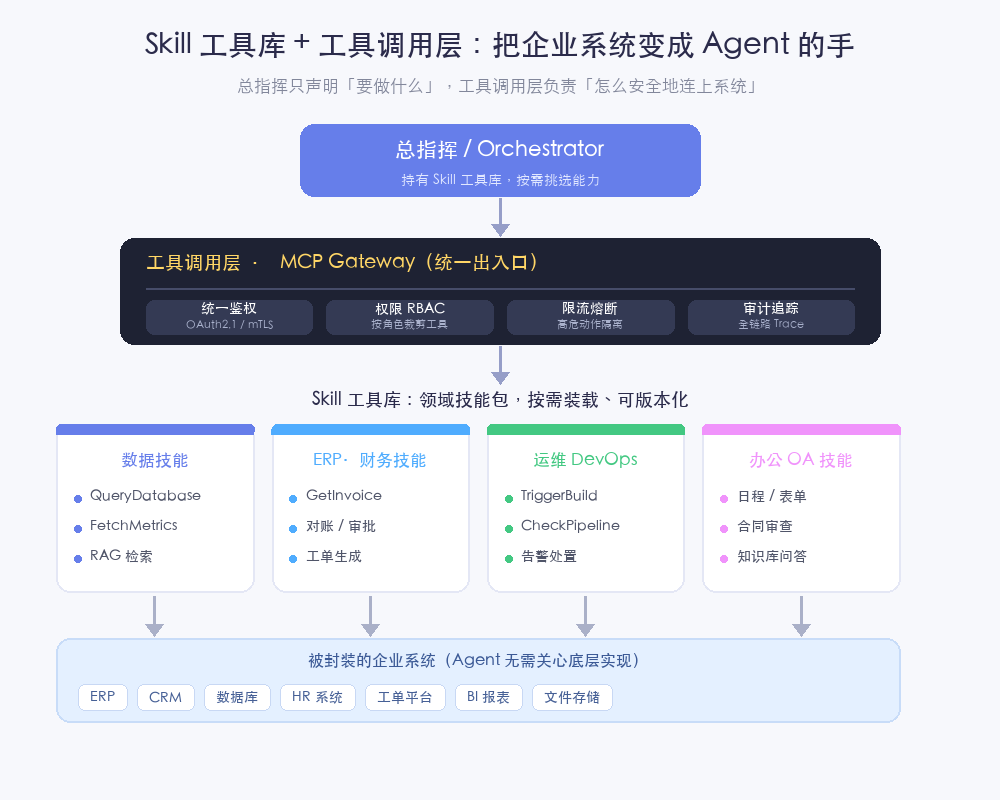
4.1 Skill 与 MCP 的关系
2026 年企业级 Agent 的工具层正在分化成两层:
- Skill(技能):面向业务动作的高阶能力,比如「查客户账单」「生成对账报告」「提交审批工单」。一个 Skill 可能内部调用多个 MCP 工具或企业 API。
- MCP(Model Context Protocol):标准的协议层,负责让 Agent 能无差别地发现和调用外部系统。
用一句话概括:MCP 是连接层,Skill 是业务能力层;Skill 坐在 MCP 之上,组合多个 MCP 工具完成一个业务动作。
4.2 MCP Gateway 的四个职责
企业不能把 ERP、CRM、数据库的接口直接暴露给 Agent。必须在中间加一层 MCP Gateway,统一负责:
| 职责 | 解决什么问题 | 典型机制 |
|---|---|---|
| 统一鉴权 | 防止越权调用 | OAuth2.1 / mTLS / 身份传播 |
| 权限 RBAC | 按角色裁剪可见工具 | 普通员工看不到「删除客户」工具 |
| 限流熔断 | 防止高频/高危动作拖垮系统 | 单笔金额超限拦截、批量操作限速 |
| 审计追踪 | 事后可追溯 | OpenTelemetry Trace、调用日志 |
4.3 把企业系统封装为工具
传统企业系统的接口五花八门:REST、SOAP、数据库、消息队列、文件存储。MCP 的价值在于把这些异构接口统一封装成「工具描述 + 调用协议」。
一个财务 Skill 可以长这样:
1 | class FinanceSkillPack: |
4.4 工具发现与版本治理
当企业里有几十个 Skill、上百个 MCP Server 时,「能不能被 Agent 发现」比「能不能用」更重要。2026 年的方向是建立统一的 Skill Catalog / MCP Registry:
- 工具注册、版本化、灰度发布;
- Agent 启动时自动拉取可用工具目录;
- 安全团队按 Action Plane 审计每一次调用;
- API 更新时只改 MCP Server,消费端无感知。
五、验证层:质检员/风控官
5.1 Critic Agent 的三态裁决
质检员(Critic Agent)是企业 Agent 的「安全闸口」。它不替执行者干活,而是审查执行结果,并给出三态裁决:
| 裁决 | 含义 | 后续动作 |
|---|---|---|
| pass | 结果符合要求,可以交付 | 进入归档或返回给用户 |
| retry | 结果有缺陷,但有修改空间 | 带着 feedback 回退到执行层/规划层重做 |
| escalate | 置信度低或触及高危规则 | 转人工复核,不走自动路径 |
这个裁决同样应该用结构化输出约束:
1 | class CriticVerdict(BaseModel): |
5.2 策略即代码
不要把风控规则只写在 Prompt 里。Prompt 会被绕过、会漂移、会忘记。生产级实践是把规则写成可执行代码:
1 | POLICY_RULES = [ |
这类规则在工具调用前和执行完成后各执行一次,确保「策略是代码、Prompt 只是补充说明」。
5.3 人工检查点
最高效的治理不是人类一直盯着,而是只在关键节点让人类介入。常见的触发条件包括:
- 金额超过阈值;
- 涉及敏感数据;
- 走到陌生工作流分支;
- 质检置信度低或结果冲突;
- 要对外发邮件、发短信、改数据库、做不可逆操作。
LangGraph 的 interrupt_before 天然适合插这种检查点。
5.4 Error Recovery Triangle
生产 Agent 必须承认错误是常态。BrainUpgrade 的实践中总结了 Catch → Route → Recover/Escalate 的三角模式:
- Catch:每个可能失败的节点把错误写进
state["last_error"],而不是抛异常; - Route:条件边检查
last_error,决定走成功路径还是错误处理路径; - Recover 或 Escalate:重试计数 + 指数退避,超过阈值就降级或转人工。
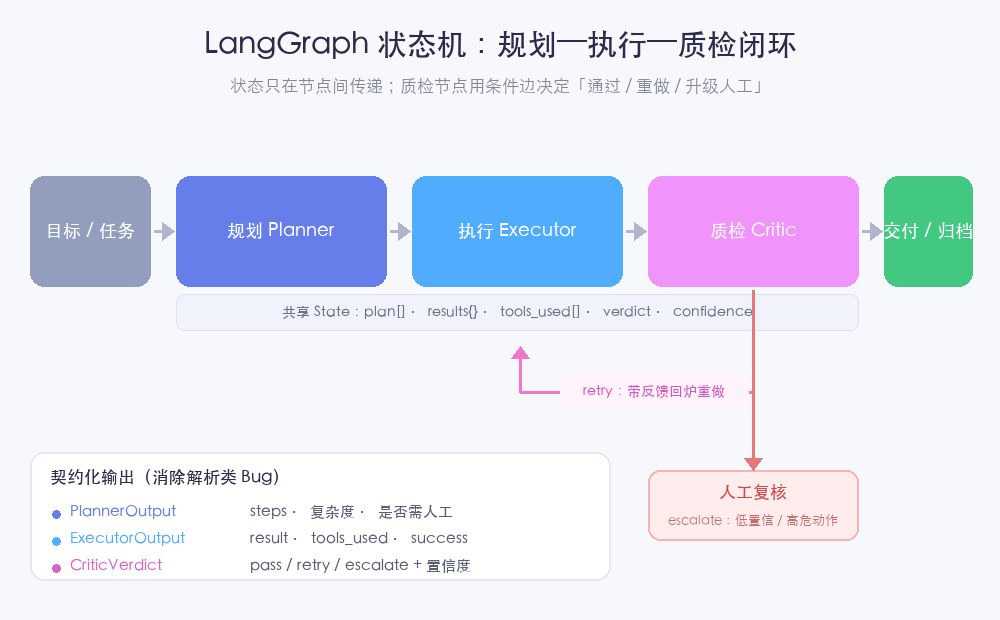
上图把 LangGraph 的闭环画清楚了:目标 → 规划 → 执行 → 质检 → 交付;质检不通过则 retry 回执行层,无法置信则 escalate 到人工复核。
六、代码实战:用 LangGraph 搭一个最小三层多智能体
下面这段代码演示了最核心的骨架。它不能直接跑完整业务,但能帮你理解三层之间怎么协同。
1 | from typing import TypedDict, List, Optional, Literal |
这段代码的关键点:
- 状态显式传递,节点之间不直接依赖;
- 每个节点的输出用 Pydantic 约束,避免解析 Bug;
- 错误处理和重试路径被画成图中的边,而不是藏在 try/except 里;
- 质检节点是条件分叉点,决定走 retry、escalate 还是结束。
七、传统行业落地案例
三层架构在金融、制造、能源、医疗等传统行业已经有明确的落地映射。
| 行业 | 场景 | 落地形态 | 公开收益 |
|---|---|---|---|
| 金融 | 信贷尽调 | 规划层拆尽调步骤,执行层调用财报/舆情/工商工具,质检层审查报告 | 宇信科技:72 小时 → 3 小时,替代 80% 手工操作 |
| 金融 | 智能外呼 | 规划层设计话术与合规路径,执行层调用语音/CRM 工具,质检层监控合规 | 中原银行:日均触达 10 万客户,转化率 +30% |
| 制造 | 财务对账 | 规划层生成对账流程,执行层登录 NC/DMS 系统,质检层核对一致性 | 赛力斯:80 小时 → 10 小时,自动化率 95% |
| 制造 | 热轧生产审核 | 规划层拆审核项,执行层接入生产数据,质检层校验规则 | 首钢:审核效率 +80% |
| 能源 | 供热运行优化 | 规划层制定负荷预测与调度方案,执行层控制阀门/机组,质检层校验安全约束 | 北京热力:年节能 3%~4%,省约 3 亿元 |
| 医疗 | VTE 风险评估 | 规划层触发评估流程,执行层读取病历数据,质检层复核高风险项 | 中科大附一院:VTE 评估率 5% → 93%,服务 56.3 万人 |
这些案例的共性是:复杂任务被拆成可独立验证的子任务,每个子任务有明确的负责人(Agent)和验收标准(质检规则)。
八、坑与挑战
再成熟的架构也有坑。传统企业落地三层多智能体时,最常见的几个坎:
1. 状态管理比想象中难
共享 State 是 LangGraph 的灵魂,但也是最大的复杂度来源。字段命名不规范、节点更新冲突、跨节点类型不一致,都会导致难以排查的 Bug。建议用 Pydantic 模型严格定义 State,而不是裸 TypedDict。
2. 工具描述与权限要并重
模型只能「看见」你允许它看见的工具。如果一次性把所有工具塞进 Prompt,噪音会压垮推理;如果权限没控制好,Agent 可能调用不该调用的工具。正确做法是:按角色和会话上下文动态裁剪工具列表。
3. 质检标准不易量化
「结果好不好」很难自动判断。Critic Agent 需要明确的评分标准:事实是否可溯源、格式是否符合模板、数值是否在合理区间、是否触发敏感词。标准不清晰,质检就是摆设。
4. 人工复核不是多余,而是成本
把所有不确定结果都抛给人工,会重新制造瓶颈。好的设计是:只在置信度低、金额大、不可逆、高风险四类情况下触发人工。其余情况用 retry 自动处理。
5. 调试困难
多 Agent 之间的调用链很长,传统日志不够看。生产环境必须接入 LangSmith / OpenTelemetry,把每一次规划、执行、质检都变成可观测的 Trace。
九、趋势预测
基于 2026 年的技术和产业信号,多智能体在企业级落地会沿着三条主线演进:
1. MCP 成为企业系统的事实标准接口
就像 HTTP 统一了 Web、SQL 统一了数据库,MCP 正在统一 AI 工具层。未来企业内部成百上千个系统都会以 MCP Server 的形式暴露,Agent 通过统一协议发现调用,工程团队不再写适配器。
2. Agent 资产化管理
Prompt、Skill、MCP Server、Agent 本身都会被注册、版本化、灰度发布。谁可见、谁可调用、谁可下载,全部纳入 RBAC 和审计。治理会从「写在 Prompt 里」变成「资产化管理」。
3. 人机边界从「全自动」走向「选择性人工」
企业不会追求 100% 自动化,而是追求高效率 + 高安全的自动化。人类角色从「每个动作都审批」变成「只在关键节点做 selective governor」。质检员 Agent 的设计会越来越重要。
4. 多智能体从可选变成复杂任务默认
当任务涉及多个专业领域、多个企业系统、多个风险点时,单智能体将越来越不够用。三层多智能体架构会成为企业级 Agent 的默认参考架构。
十、总结
传统行业做企业级 Agent,最大的误区是「先堆模型能力,再补治理」。正确的顺序应该是:先把架构拆清楚,再把工具管好,最后用质检员把住质量关。
三层多智能体架构提供了这样一条清晰路径:
- 规划层(总指挥)用 LangGraph 把任务拆成可执行计划;
- 执行层用 Skill 工具库和 MCP 工具调用层安全地连接企业系统;
- 验证层(质检员/风控官)用结构化裁决和策略即代码守住风险边界。
这套架构不是为了炫技,而是为了让 Agent 在传统行业里真正「能干活、敢干活、可被审计」。
行动建议:
- 如果你的任务涉及 3 个以上独立系统或 5 个以上工具,直接考虑多智能体;
- 先用 LangGraph 搭一个最小三层图,把 Planner、Executor、Critic 跑通;
- 把企业系统封装成 MCP Server,不要直接让 Agent 调内部 API;
- 从第一天就定义 CriticVerdict 的验收标准,并接入 LangSmith 做可观测。
本文为个人技术笔记,案例与数据整理自公开报道与社区实践(截至 2026-10-13),属于量级参考,落地请以自有业务复测为准。如有疑问,欢迎在留言板交流。
 微信
 支付宝
欢迎来到李苟蛋的个人博客,对本站的文章和技术问题有疑问或建议,欢迎留言,或者关注我的公众号:狗蛋的智栈