Agent 越跑越笨,问题不在模型:Context Engineering 策略解析
序言
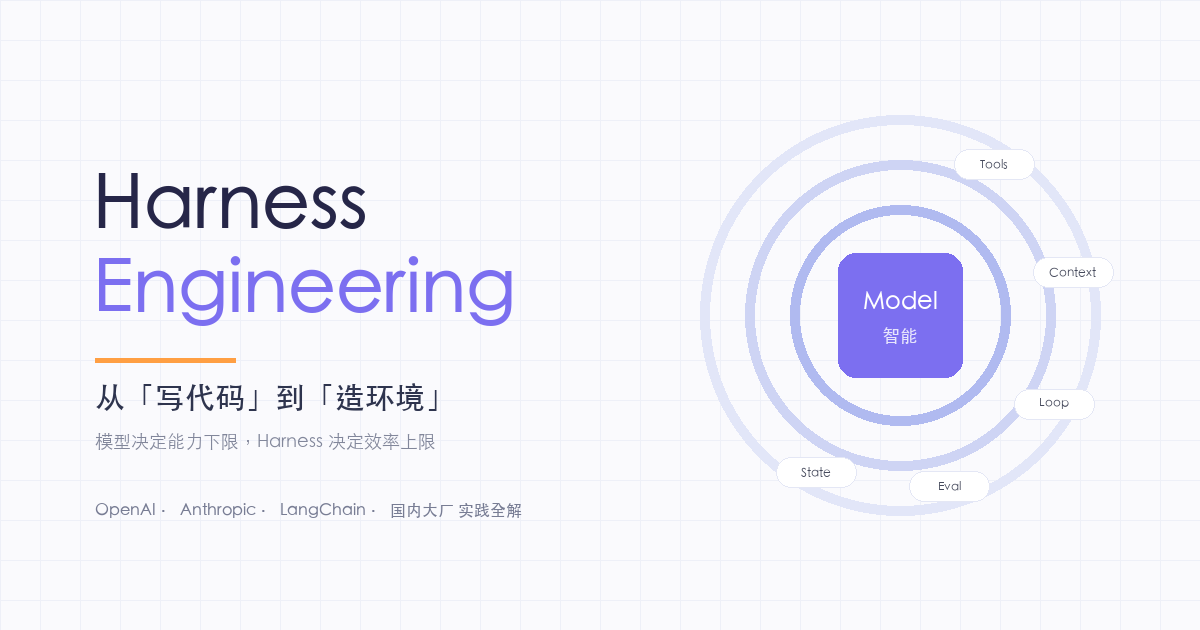
上一篇写 Harness Engineering 的时候,我在三代范式的图里把 Context Engineering 画成了中间那一层——比 Prompt 大、比 Harness 小。当时一笔带过,但读者朋友应该能感觉到:这个中间层其实是整个体系里最承重的一层。
所以这篇把它单独拎出来讲透。
2025 年年中,两篇标题针锋相对的文章几乎同时出现:LangChain 的《Context Engineering》给出了四策略框架,Cognition(Devin 的开发公司)的《Don’t Build Multi-Agents》则直接喊出「别建多 Agent」。表面上看是一篇讲方法、一篇泼冷水,实际上它们讲的是同一件事——在有限的上下文窗口里,模型每一步到底该看到什么。把这两篇放在一起读,正好凑齐了 Context Engineering 的地图和红线。
先把结论放在前面:Context Engineering 关注的不是怎么训练模型,而是怎么精心设计给模型的输入——不改变模型的结构,只改变模型看到什么。
一、先分清三个词:Context、Context Window、Token
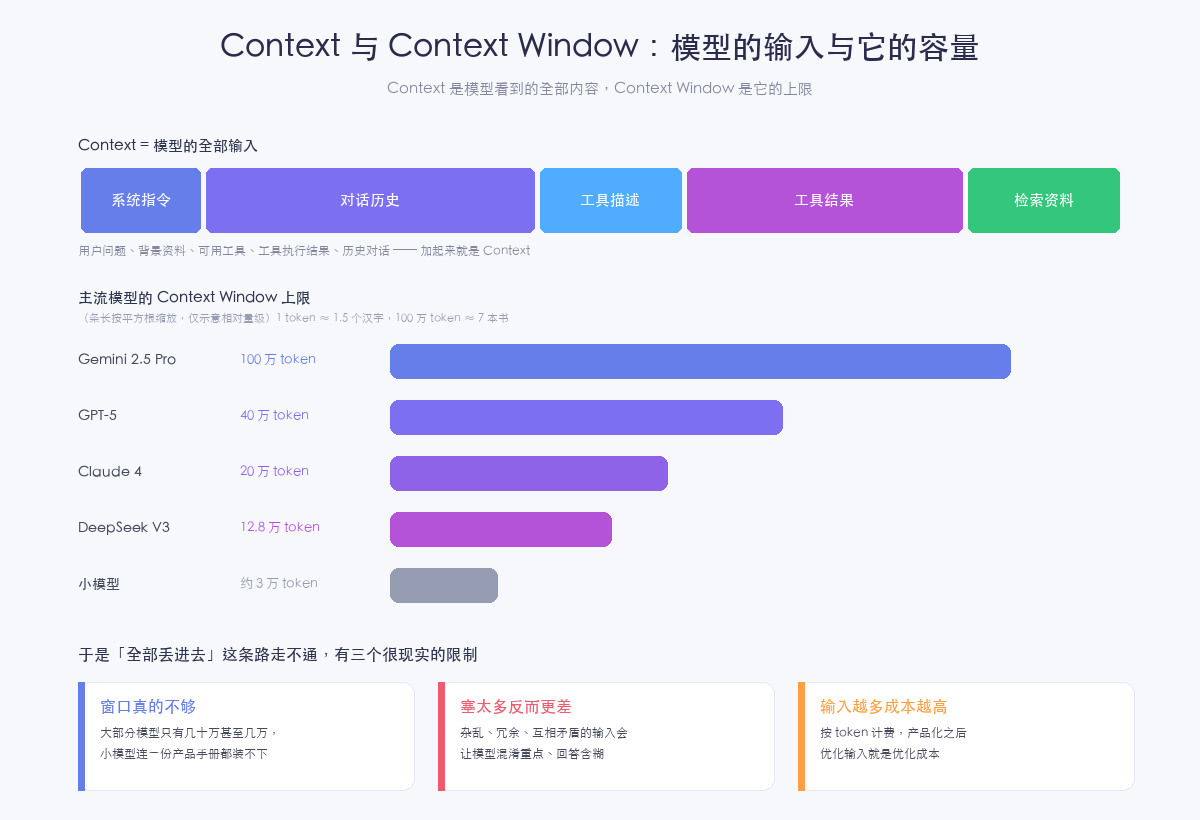
大模型从外面看就是一个函数:给输入,给输出。但它的输入有大小限制,这个限制叫上下文窗口(Context Window)。
这里面的 Context 指的是模型的全部输入:用户问题、背景资料、可用工具列表、工具执行结果、历史对话,全都算。而 Context Window 就是这个输入最多能装多少 token——token 可以理解为文本被拆分的最小单位,一个 token 大约相当于 1.5 个汉字或 0.75 个单词。
说到这里很多人会冒出一个想法:现在窗口这么大,Gemini 2.5 Pro 都 100 万 token 了,接近 7 本书的长度——那我干脆把所有资料全丢进去,让模型自己理解,不行吗?
不行。三个很现实的限制:
第一,窗口其实没那么大。 100 万是天花板,不是常态:
| 模型 | Context Window |
|---|---|
| Gemini 2.5 Pro | 100 万 |
| GPT-5 | 40 万 |
| Claude 4 | 20 万 |
| DeepSeek V3 | 12.8 万 |
| 小模型 | 几万(连一份产品手册都装不下) |
为了省成本,很多生产系统用的恰恰是小模型。
第二,塞太多反而更差。 即使装得下,不加筛选的输入会杂乱、冗余、互相矛盾,模型会混淆重点,回答含糊其辞。与其把所有信息都塞进去,不如确保模型看到的是准确、有结构、重点突出的内容。
第三,输入越多成本越高。 调用成本按 token 计费。产品化、规模化之后,优化输入就是优化成本——这不是技术洁癖,是财务问题。
二、定义:为什么这个词 2025 年才火
Context 这个概念一直都在,但 Context Engineering 直到 2025 年才被单独拎出来命名。Andrej Karpathy 给了目前最被广泛引用的表述:
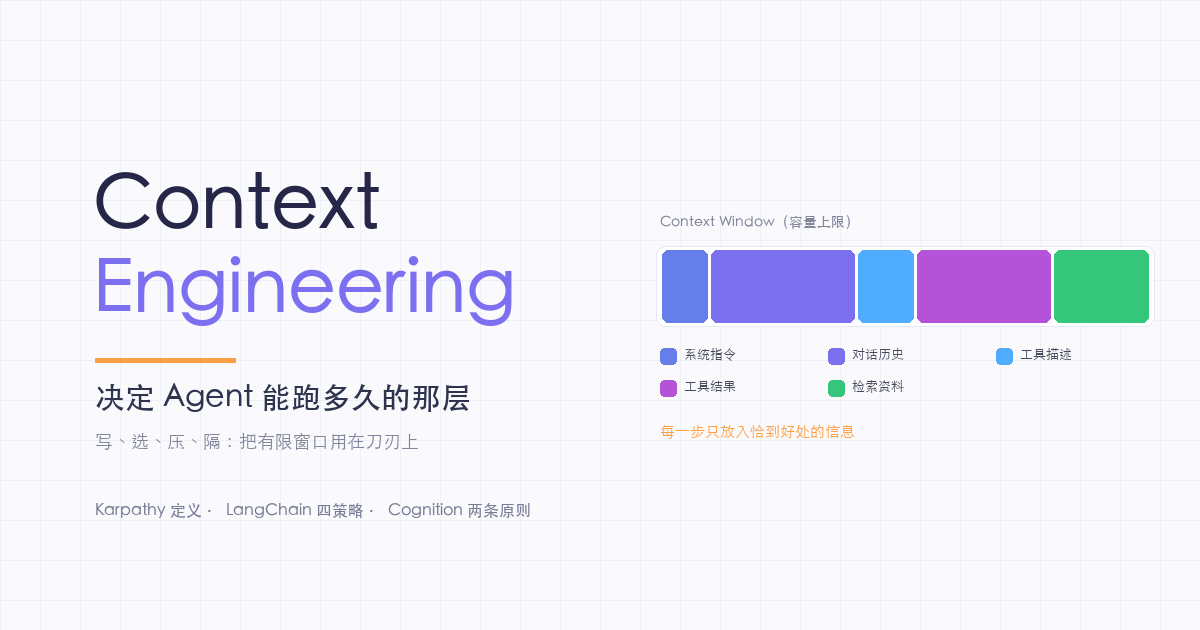
「Context engineering 是一种精细的艺术与科学:为下一步,往上下文窗口里填入恰到好处的信息。」
他还给了一个特别好用的类比:LLM 像 CPU,上下文窗口像 RAM。就像操作系统要决定哪些数据进入内存一样,Context Engineering 扮演的就是这个调度角色。
Cognition 的表述更直白,也更适合当工位标语:
「上下文工程,实际上就是构建 AI Agent 的工程师的第一号工作。」
为什么是现在?两个原因。
一是模型够强了。 一两年前,模型回答不好,你分不清是模型笨还是你没说明白;现在的模型,只要给到足够清晰、足够完整的信息,大多数时候都能给出好答案。模型不满意时,瓶颈从模型能力转移到了信息供给——这正是 Context Engineering 要解决的问题。
二是 Agent 兴起了。 Agent 会交替进行模型调用和工具调用,用工具反馈决定下一步。用多少次工具,就有多少份工具结果堆在上下文里。Anthropic 的观察是:Agent 的对话经常横跨数百轮。跑得越久,堆得越多,管理上下文的效果直接决定 Agent 的执行效果。
三、长上下文的四种失效模式
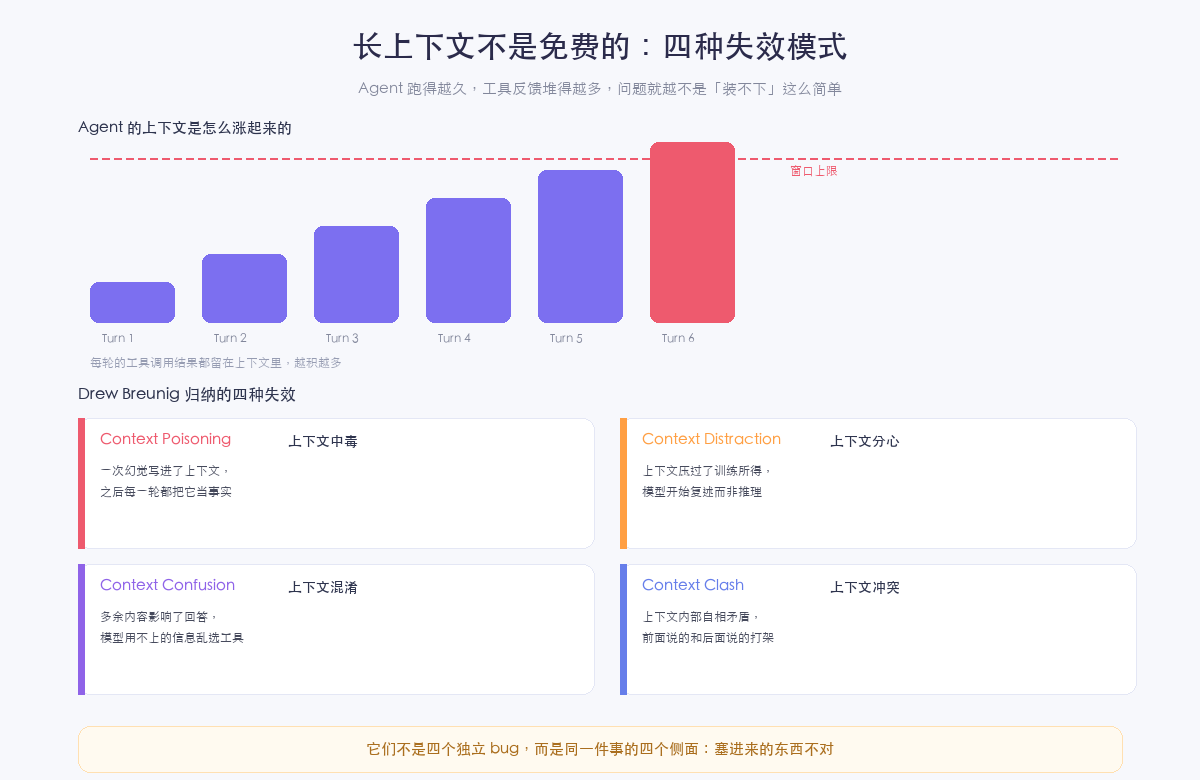
在讲怎么管之前,先看看放任不管会发生什么。Drew Breunig 归纳了长上下文的四种失效方式,值得逐个认识:
- Context Poisoning(中毒):一次幻觉写进了上下文,之后每一轮都把它当事实。错的不但是这次的回答,还会污染后面所有的回答。
- Context Distraction(分心):上下文压过了训练所得,模型开始复述上下文里的内容,而不是推理。给得越多,反而越笨。
- Context Confusion(混淆):多余的内容影响了回答,比如一堆用不上的工具描述让模型乱选工具。
- Context Clash(冲突):上下文内部自相矛盾,前面说的和后面说的打架,模型不知道该信哪个。
这四种失效有个共同点:都不是「窗口装不下」这种硬错误,而是软性的质量塌方——你不会看到报错,只会看到回答莫名其妙地变差。这也是为什么上下文管理必须主动做,而不是等出问题再补救。
四、四大策略:Write、Select、Compress、Isolate
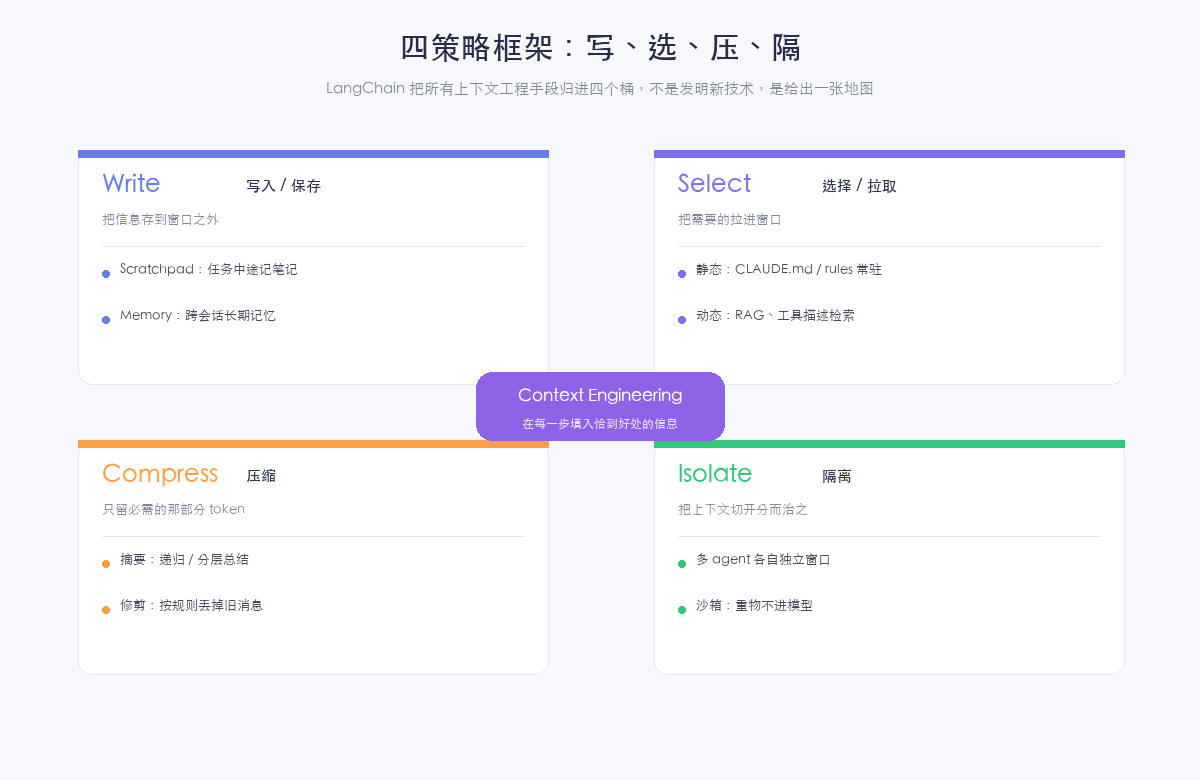
LangChain 把所有上下文工程的手段归进四个桶。这套分类的价值不在于发明了新技术,而在于给了一张地图——你遇到的每个具体问题,都能在这四个桶里找到位置。
4.1 Write:把信息存到窗口之外
写入上下文,意思是把它保存在窗口之外,需要时再用。两个典型形态:
Scratchpad(草稿板):agent 在任务执行中随时记笔记。最生动的例子来自 Anthropic 的多 agent 研究系统——LeadResearcher 接到任务后,第一件事是把计划存进 Memory,原文的理由很实在:「如果上下文窗口超过 200,000 token 会被截断,所以必须先把计划保住。」
Memory(记忆):scratchpad 解决单个会话内的问题,memory 让 agent 跨会话记住事情。学术源头是 Reflexion(每轮结束后自我反思、复用自产记忆)和 Generative Agents(定期从过往反馈中合成记忆),产品化的代表就是 ChatGPT 的记忆功能——你随口提过自己是做什么的,几个月后它还记得。
4.2 Select:把需要的拉进窗口
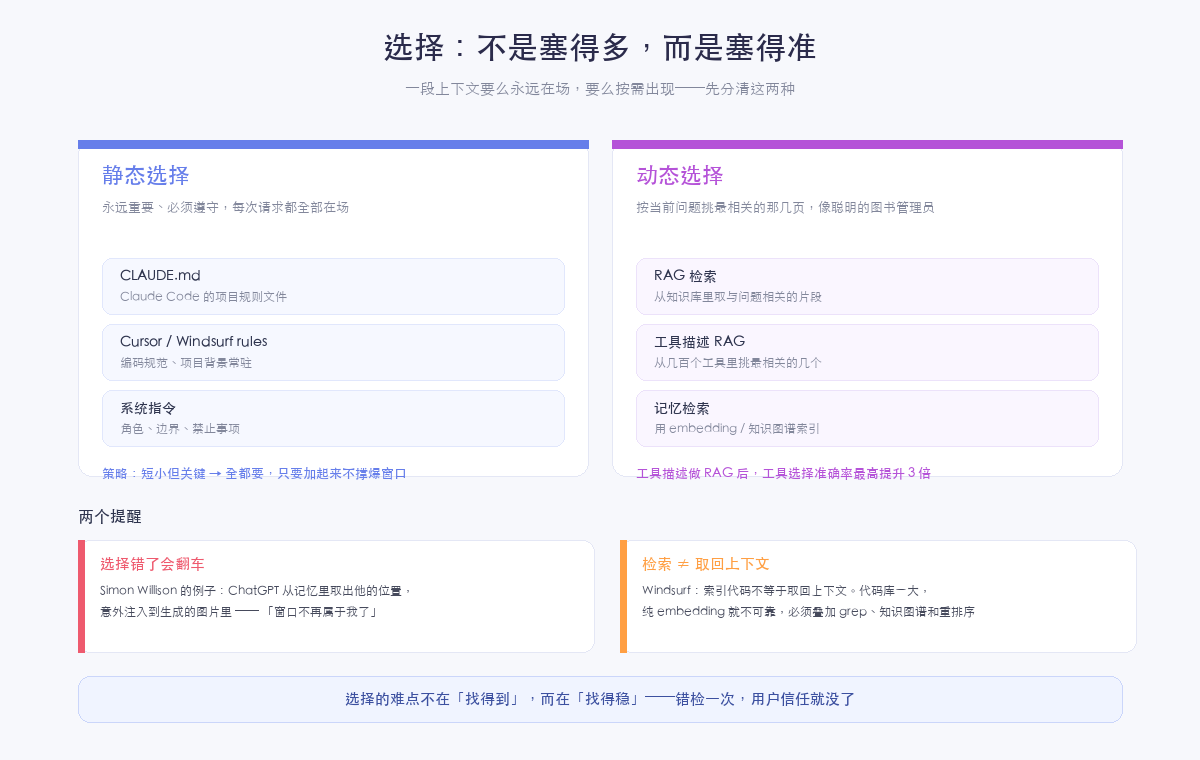
存下来只是第一步,怎么在需要时精准取回才是核心。我把选择策略分成两类:
静态选择——那些永远重要、必须遵守的信息,每次请求全部在场。Cursor 的 rules 文件、Claude Code 的 CLAUDE.md 都是这一类。对这种短小但关键的信息,最有效的策略就是「全都要」,只要加起来不撑爆窗口。
动态选择——按当前问题挑最相关的内容放进去。最有名的实现是 RAG;容易被忽视的是工具也是检索对象:从几百个工具里为当前问题挑出最相关的三五个,效果远好于全量列出。论文数据很直观:对工具描述做 RAG 后,工具选择准确率最高提升 3 倍。
两个提醒值得贴在显示器边上。
其一,选择错了会翻车。Simon Willison 讲过一个例子:ChatGPT 从记忆里取出了他的位置信息,意外注入到生成的图片里。他的感受是「这个上下文窗口不再属于我了」。动态选择是概率性的,错检一次,用户的信任就掉一截。
其二,检索不等于取回上下文。Windsurf 的 Varun 说得非常透彻:
「索引代码 ≠ 上下文检索……代码库一大,embedding 检索就变得不可靠,必须叠加 grep / 文件搜索、知识图谱检索和重排序。」
这句话对做代码 agent 的团队是当头棒喝:别把「建了向量库」当成「做好了检索」。
4.3 Compress:只留必需的 token
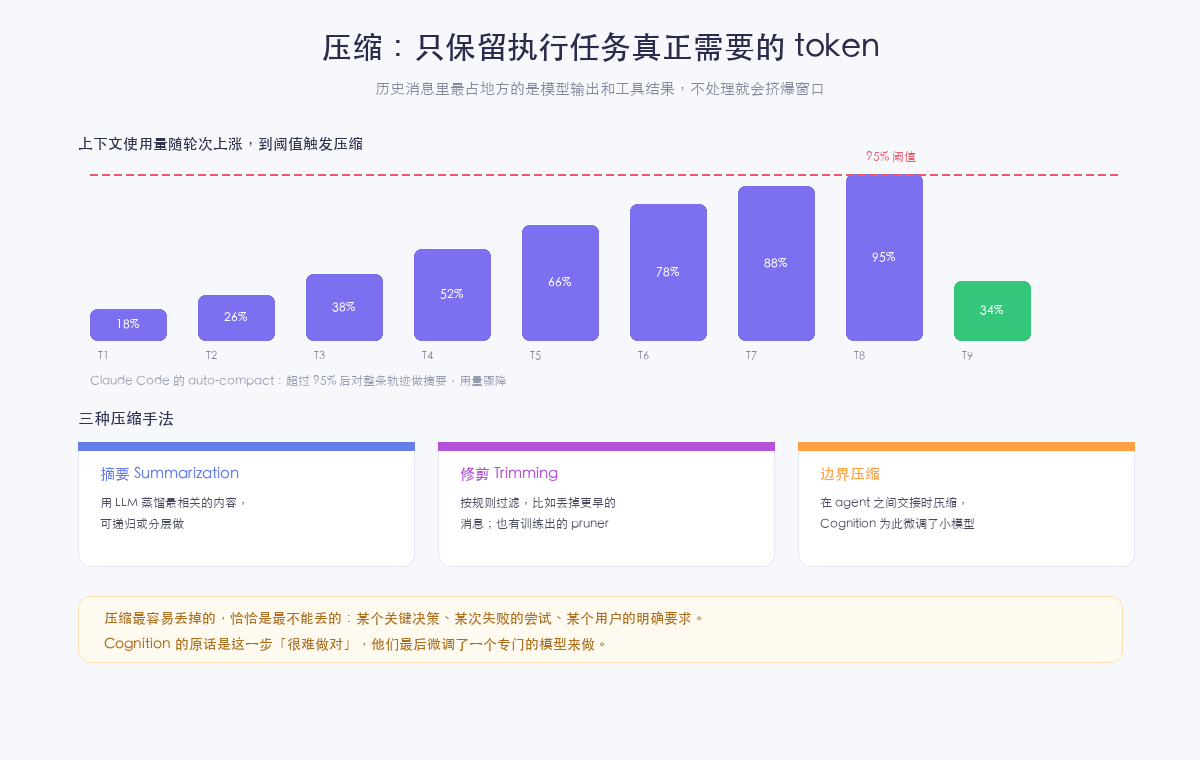
历史消息里最占地方的是模型输出和工具结果,不处理就会挤爆窗口。两种手法:
摘要(Summarization):用 LLM 把历史蒸馏成摘要。可以递归做、分层做,也可以在特定位置做——比如对 token 特别重的搜索工具结果做后处理,或在 agent 之间交接时压缩。最有名的产品实现是 Claude Code 的 auto-compact:上下文用量超过 95% 时自动触发,对整条交互轨迹做总结,然后丢掉原文。你甚至可以在 CLAUDE.md 里指定压缩时重点保留什么(比如测试输出和代码改动)。
修剪(Trimming):不经过 LLM,按规则直接过滤,比如丢掉更早的消息;也有训练出来的专用 pruner(如 Provence)。
但这里有一个所有文章都会轻描淡写、实际做起来最疼的点:压缩最容易丢掉的,恰恰是最不能丢的东西——某个关键决策、某次失败的尝试、某个用户的明确要求。Cognition 的原话是这一步「hard to get right」,他们最后微调了一个专门的模型来做压缩。如果你的场景对「决策不丢」有硬要求,这层投入躲不掉。
4.4 Isolate:把上下文切开
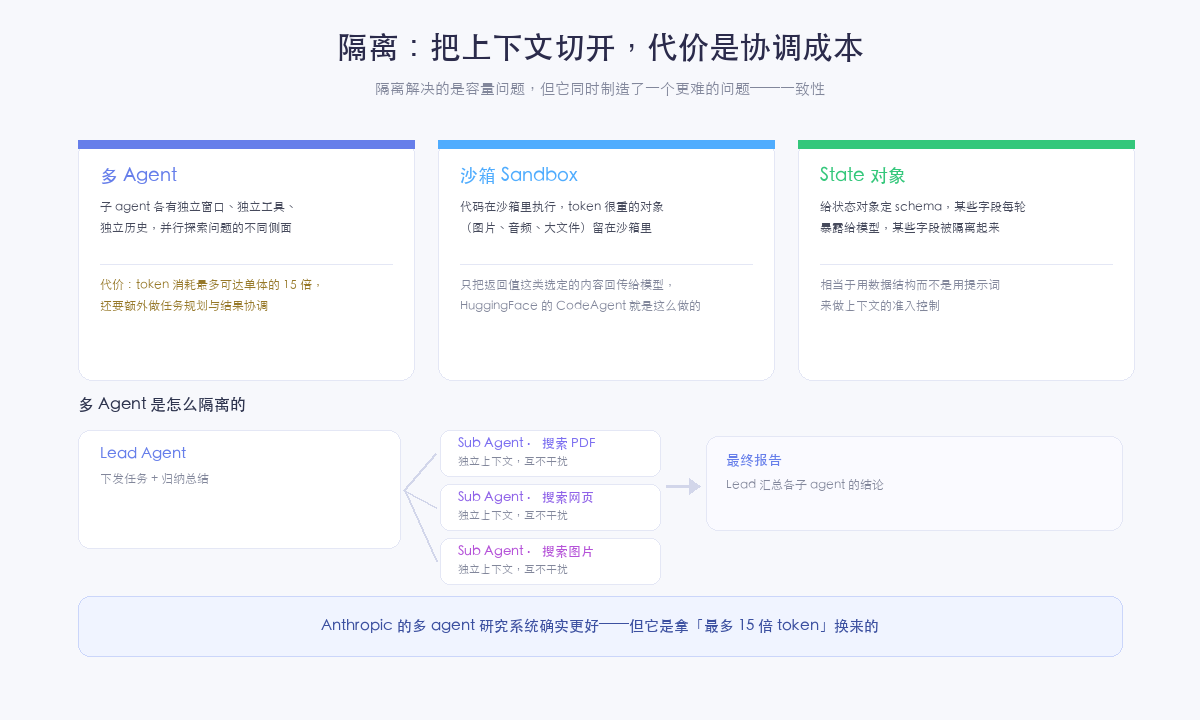
隔离的意思是把上下文拆开、分而治之,三种形态:
多 Agent:每个子 agent 有自己独立的窗口、独立的工具、独立的历史。Anthropic 的多 agent 研究系统是教科书案例:Lead Agent 下发任务、归纳总结,子 agent 并行去搜 PDF、搜网页、搜图片,彼此互不干扰。代价也很实在:token 消耗最多可达单 agent 的 15 倍,还要额外投入任务规划与结果协调。
沙箱:代码在沙箱里执行,token 很重的对象(图片、音频、大文件)留在沙箱里,只把返回值这类选定的内容回传给模型。HuggingFace 的 CodeAgent 就是这个思路——「要存图片?没问题,赋值给一个变量,后面接着用」。
State 对象:给运行时状态定 schema,某些字段每轮暴露给模型,某些字段隔离起来按需取用。相当于用数据结构、而不是用提示词,来做上下文的准入控制。
记住一句话:隔离解决的是容量问题,但它同时制造了一个更难的问题——一致性。 这就引出了下一节。
五、Cognition 的当头棒喝:别急着上多 Agent
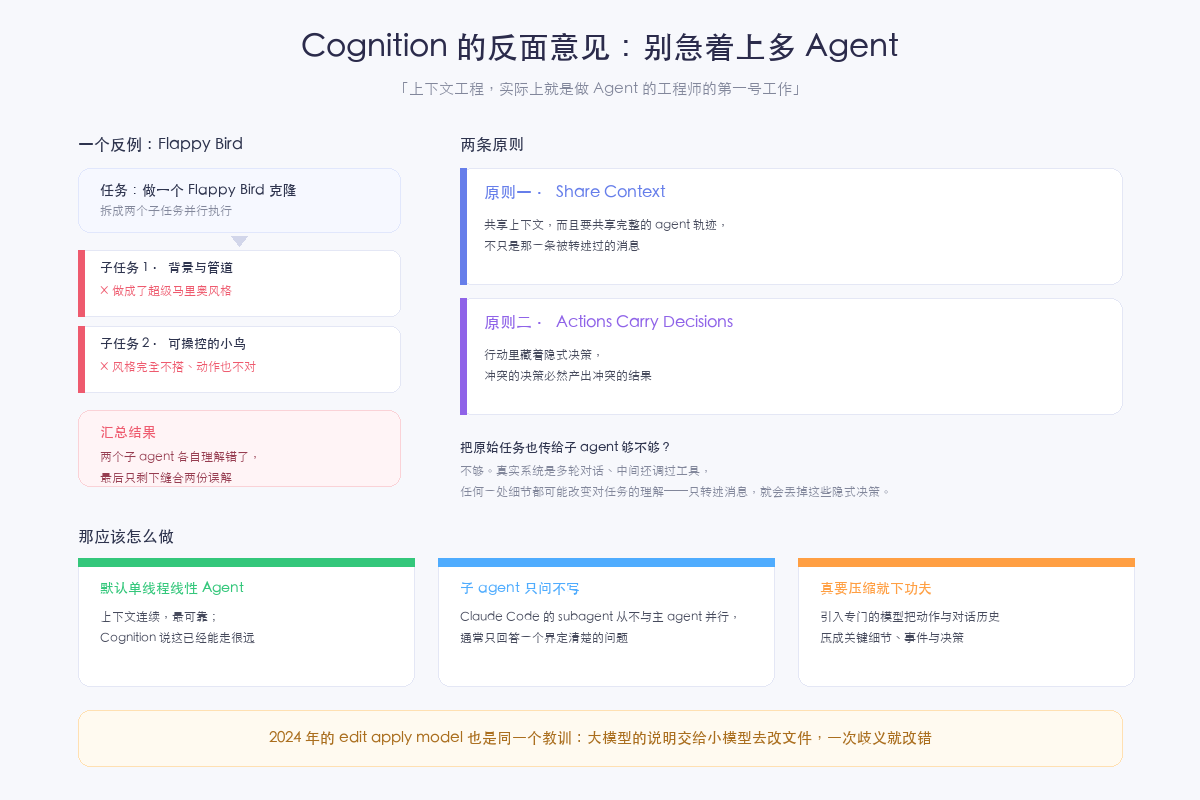
如果只看 LangChain 的四策略,「隔离」看起来是理所当然的进阶方向。但 Cognition 在《Don’t Build Multi-Agents》里给出了完全不同的判断,论证质量很高,值得完整过一遍。
先看反例。 假设任务「做一个 Flappy Bird 克隆」被拆成两个子任务并行:子任务 1 负责「移动的背景、绿色管道和碰撞体积」,子任务 2 负责「一只可以上下移动的鸟」。结果子任务 1 理解偏了,做出一张超级马里奥风格的背景;子任务 2 的鸟风格完全不搭、动作也不对。最后负责汇总的 agent,面对的是缝合两份误解。
你可能会说:把原始任务也传给子 agent 不就行了?不够。真实生产系统是多轮对话,中间还调过工具,任何一处细节都可能改变对任务的理解。于是 Cognition 给出两条原则:
原则一:共享上下文,而且要共享完整的 agent 轨迹,不只是单条消息。
原则二:行动里藏着隐式决策,冲突的决策必然产出冲突的结果。
他认为这两条原则如此关键、如此不值得违反,以至于默认应该排除掉一切不满足它们的架构。
再看三个现实印证。
其一,Claude Code 的 subagent 从不并行,而且通常只被用来回答一个界定清楚的问题,不写代码。为什么?因为 subagent 缺少主 agent 的上下文,干不了更复杂的事;并行跑多个又可能给出冲突的结果。收益是子 agent 的探索过程不会留在主 agent 的历史里,上下文能撑得更久——这是一个刻意保守的设计。
其二,2024 年流行的 edit apply model:让大模型输出改动的 markdown 说明,再交给小模型重写整个文件。问题在于小模型会误解说明,最轻微的歧义就会改错代码。如今编辑决策和执行更常由单个模型一次完成。这是「把上下文切开传一手」的教训。
其三,关于让多个 agent「互相讨论达成一致」——人类工程师遇到 merge conflict 会去沟通,但高效传递重要知识这件事本身需要不低的智能,今天的 agent 做不到比单 agent 更可靠。
那 LangChain 和 Cognition 矛盾吗? 我读下来的判断是:不矛盾,而且互补。LangChain 给的是地图——隔离确实是应对超长任务的手段之一;Cognition 给的是红线——隔离有真实的一致性代价,别把它当架构默认项。Anthropic 的多 agent 系统效果确实好,但那是拿 15 倍 token 和精细的 prompt 工程换来的,而且它的场景(研究检索)天然容错率高。如果任务要求严格一致(比如写代码),Cognition 是对的;如果任务可以分区并行(比如多路调研),LangChain 的隔离策略才划算。
还有一个隐藏共识:两家都认为单线程线性 agent 是默认起点。Cognition 说「这个简单架构能带你走得很远」,在窗口真正溢出之前,先做压缩、做好压缩,而不是先拆架构。
六、落地顺序:五步,别跳步
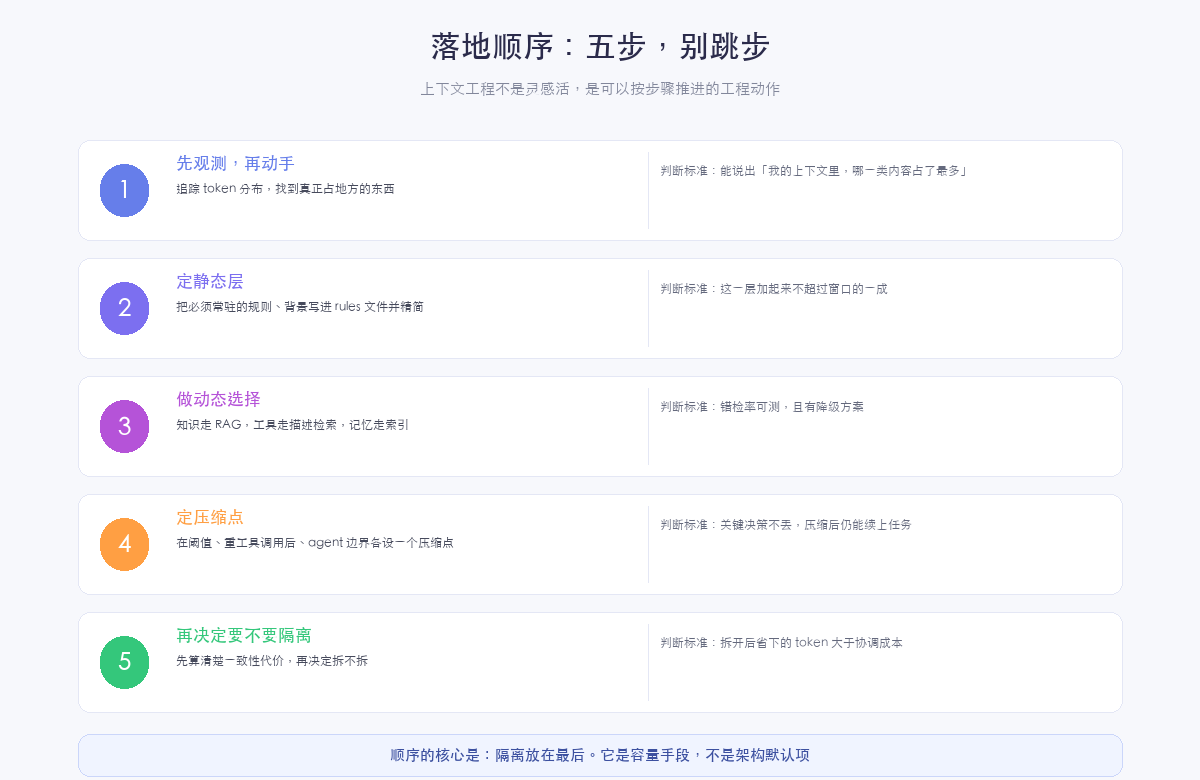
结合两家的观点和我自己的实践,给一个可以按步执行的顺序:
第一步:先观测,再动手。 用 LangSmith 这类工具追踪 token 分布,搞清楚上下文里到底什么占地方——是工具结果还是历史消息。判断标准:能说出「我的上下文里,哪一类内容占了最多」。
第二步:定静态层。 把必须常驻的规则、项目背景写进 rules 文件,并狠心精简。判断标准:这一层加起来不超过窗口的一成。
第三步:做动态选择。 知识走 RAG,工具走描述检索,记忆走索引。判断标准:错检率可测,且有降级方案——错检一次的代价你想清楚了。
第四步:定压缩点。 在 95% 阈值、重工具调用之后、agent 交接边界各设一个压缩点,明确「压缩时必须保留什么」。判断标准:关键决策不丢,压缩后任务能续上。
第五步:再决定要不要隔离。 先算一致性代价,再决定拆不拆。判断标准:拆开后省下的 token 大于协调成本——大多数团队算完这笔账,会把多 Agent 往后排。
顺序的核心是:隔离放在最后。它是容量手段,不是架构默认项。
七、在更大的版图里
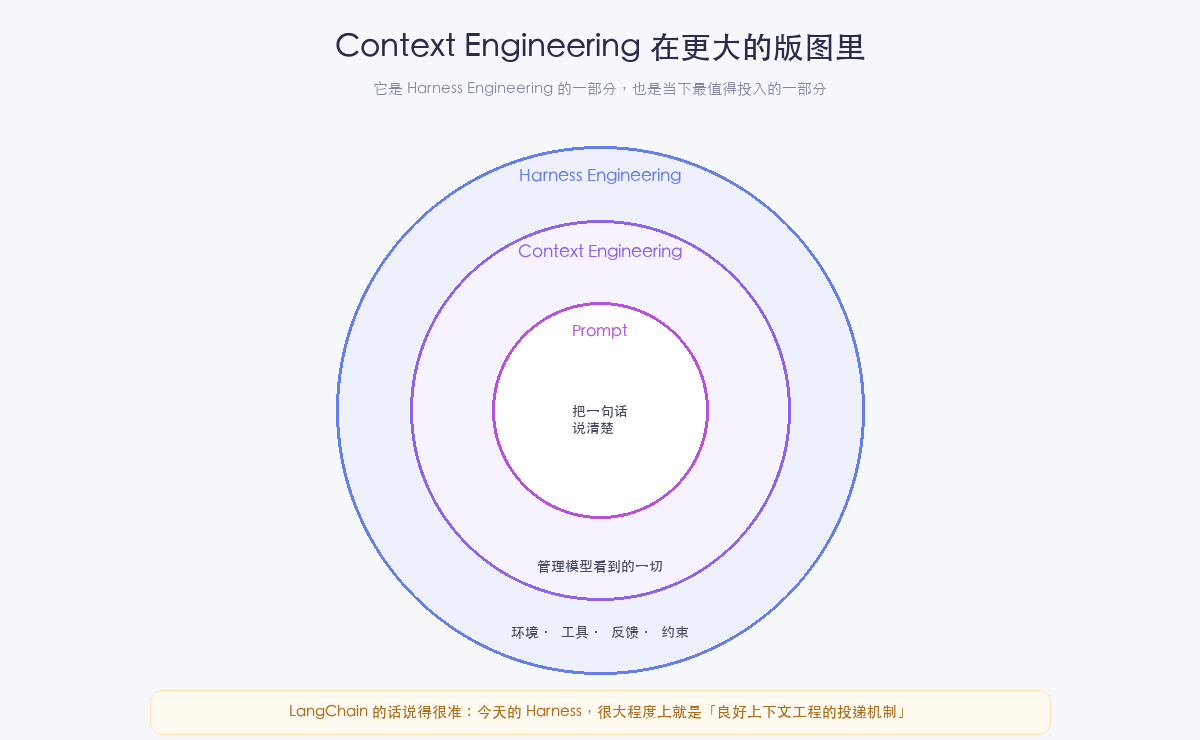
最后回到三代范式的关系。Prompt Engineering 把一句话说清楚;Context Engineering 管理模型看到的一切——保存、选择、压缩、隔离,全是围绕「模型看到什么」做文章;Harness Engineering 则更外一层,把环境、工具、反馈、约束整个造出来。
LangChain 有句话说得很准:
「今天的 Harness,很大程度上就是良好上下文工程的投递机制。」
也就是说,上一篇讲的那些 harness 机制——AGENTS.md 做索引、进度文件、压缩触发、子 agent 隔离——拆开看,几乎每一件都是本文四策略中的某一招。Context Engineering 不是被 Harness 取代了,而是被 Harness 装配了。
八、结语
Karpathy 把 LLM 比作新型操作系统的 CPU,把上下文窗口比作 RAM。这个类比最好的地方在于它指出了工程的重心:CPU 再快,内存调度一团糟,机器照样卡死。
模型能力还在快速进步,但只要上下文窗口是稀缺资源、只要 Agent 要跑几百轮,Context Engineering 就是那个绕不开的第一号工作。它不性感——没有参数量、没有 benchmark 冠军——但它是把模型能力兑换成生产力的那道阀门。
先观测,再分层,能压缩不硬塞,要隔离先算账。
参考
 微信
 支付宝
欢迎来到李苟蛋的个人博客,对本站的文章和技术问题有疑问或建议,欢迎留言,或者关注我的公众号:狗蛋的智栈