云原生 AI 网关选型与落地:Higress、APISIX、Kong、Envoy AI Gateway 横评
序言
2026 年,几乎每家企业的 AI 应用都撞上了同一堵墙。
不是模型不够好,也不是 Agent 不够聪明——是流量失控。
一个典型的中型研发团队,半年之内会变成这样:业务代码里散落着七八个不同厂商的 API Key,有的写在配置文件里、有的硬编码在测试脚本里、有的干脆是某个已经离职的同学留下的;财务月底拿着账单问”这 40 万里哪部分是客服场景烧的”,没人答得上来;一个实习生写的循环调用,下午把某个模型的日配额打满了,客服系统跟着一起挂;合规部门要求”不能把用户身份证号发给外部模型”,但没有任何一个地方能统一拦住它。
这些问题的共同点是:它们都不在业务代码里,所以也没法在业务代码里解决。
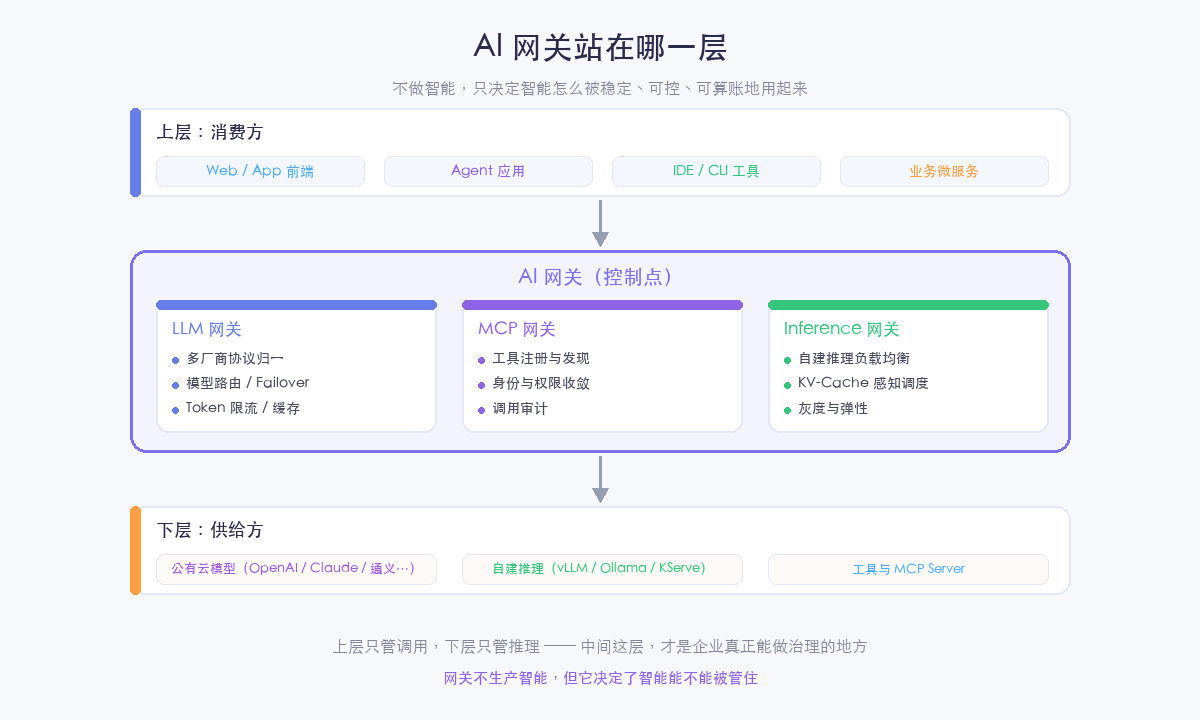
这就是 AI 网关要干的事。它不生产智能,但它决定了智能能不能被稳定、可控、可算账地用起来。
这篇文章想解决三个具体问题:
- 市面上到底有哪些成熟的开源 AI 网关? 谁研发的、什么语言写的、底层架构是什么、什么时候起步、许可怎么算、适合什么样的公司。
- Higress / Apache APISIX / Kong / Envoy AI Gateway 这四套主力方案,架构上到底差在哪? 不要只背功能清单,要看内核。
- 如果选 Higress,本地怎么 5 分钟跑起来?企业真正落地又要经历什么? 附带一份 Demo 和一份踩坑清单。
一、先分清两件事:AI 网关是什么,不是什么
在讨论选型之前,必须先分清一件事,因为它经常被混为一谈。
「调用大模型」和「治理大模型流量」,是两个完全不同的问题。
前者是业务代码的事:拼 messages、调接口、解析流式响应。这件事任何一个 SDK 都能做,而且做得挺好。
后者是基础设施的事,包含至少六类互相纠缠的诉求:
- 统一协议:OpenAI、Anthropic、Gemini、Bedrock、通义、DeepSeek、豆包……每家的请求体结构、认证方式、流式格式都不一样。业务代码不应该为每一个厂商写一套适配。
- 凭证收口:厂商密钥不应该出现在任何业务进程里。业务只持有一个内部虚拟 Key,真实密钥由网关注入。
- 成本归因:AI 的计费单位是 token,不是请求数。不统计 token,就没法把成本摊到业务方,也没法做预算。
- 配额与熔断:按团队、按应用、按模型、按时间窗口限制 token 消耗,超额就拒绝——而不是等账单出来再复盘。
- 安全与合规:Prompt 注入检测、有害内容过滤、PII 脱敏、完整审计留痕。输入侧要拦,输出侧同样要拦。
- 可观测:输入 / 输出 token 数、首 token 延迟、端到端耗时、模型维度与调用方维度的分布。这是排查”为什么今天这么慢”的唯一抓手。
AI 网关不是 Agent 框架,也不负责告诉 Agent 该怎么推理。 它的价值只在 AI 流量跨越了供应商、团队、安全、成本或运维边界的时候才显现——也就是,当原型变成业务真正依赖的东西的时候。
所以有一条反直觉但很实用的结论:如果你的团队只有两三个人、只调一家模型,环境变量加一个薄封装就够了,专门维护一套网关反而是负债。 网关的收益是随规模非线性增长的——多一个中间层,就多一个单点、多一跳延迟、多一份运维负担。等到多模型、多团队、多业务线同时出现,它才从”可选项”变成”必需项”。
二、网关的四次身份转变
AI 网关不是凭空出现的新物种,它是”网关”这个角色第四次改换身份的结果。
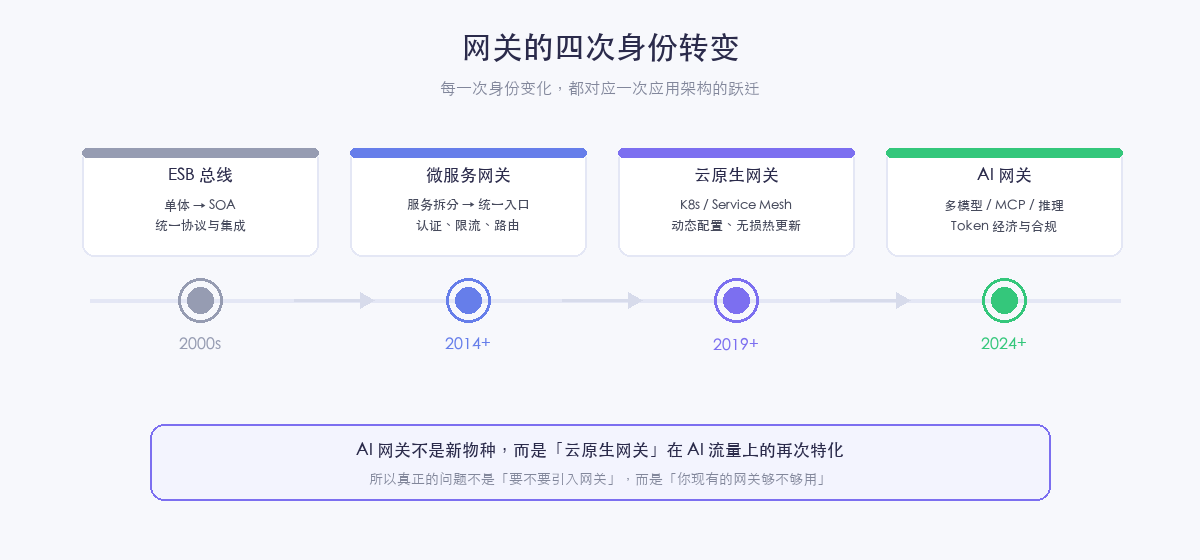
- 2000s · ESB 总线:从单体走向 SOA,网关的职责是统一协议和集成。
- 2014+ · 微服务网关:服务被拆开之后需要一个统一入口,认证、限流、路由成了标配。
- 2019+ · 云原生网关:K8s 和 Service Mesh 成为基础设施底座,网关开始强调动态配置、毫秒级生效、无损热更新。
- 2024+ · AI 网关:多模型、MCP 工具、自建推理成为新的流量形态,Token 经济和合规治理成了新职责。
Higress 的诞生正好卡在第三次转变上。它最初由阿里巴巴研发,要解决的是 Tengine 配置 reload 影响长连接、以及 gRPC / Dubbo 服务负载均衡能力不足的问题,2022 年开源。而如今阿里云云原生 API 网关、MSE 云原生网关、专有云飞天企业版 API 网关等产品线都采用了 Higress 的统一架构——它已经从”一个开源项目”变成了”一套产品底座”。
理解这条演进线的好处是:你不需要问”要不要引入网关”,而是要问”我现有的网关够不够用”。 如果公司已经在用 Kong 或 APISIX 管微服务流量,那么加 AI 能力可能只是”开几个插件”;如果一片空白,那就要正面回答下面这套选型问题。
三、开源 AI 网关全景地图
市面上的项目可以按”出身”分成三条路线,理解这个分类比逐个对比功能更重要。
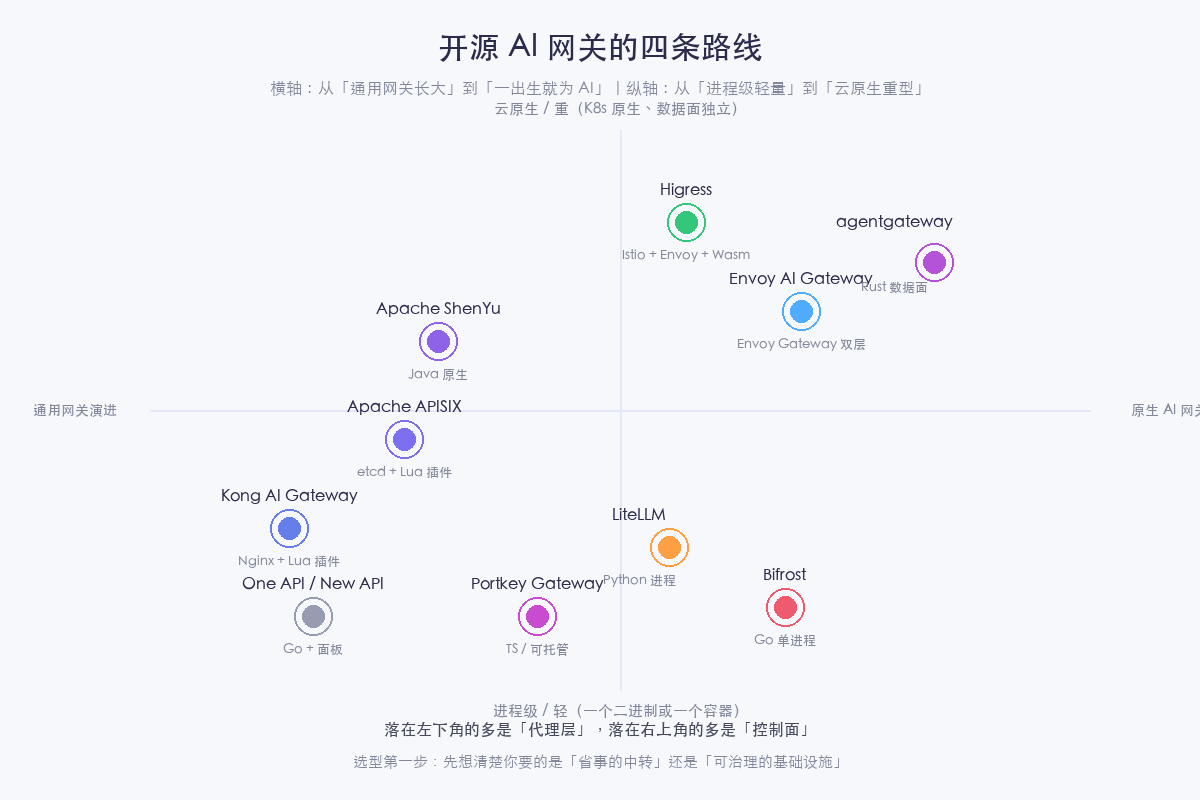
横轴是”通用网关长大”到”一出生就为 AI”,纵轴是”进程级轻量”到”云原生重型”。
- 落在左下的多是「代理层」:一个进程、一个容器就能跑,上手快,解决的是”多厂商路由 + 预算”。
- 落在右上的多是「控制面」:K8s 原生、数据面独立、与现有网关或 Mesh 复用,解决的是”可治理的基础设施”。
选型的第一步,是先想清楚你要的到底是”省事的中转”,还是”可治理的基础设施”。 这两条路的答案完全不同。
下面对所有值得知道的项目做一次全景盘点。
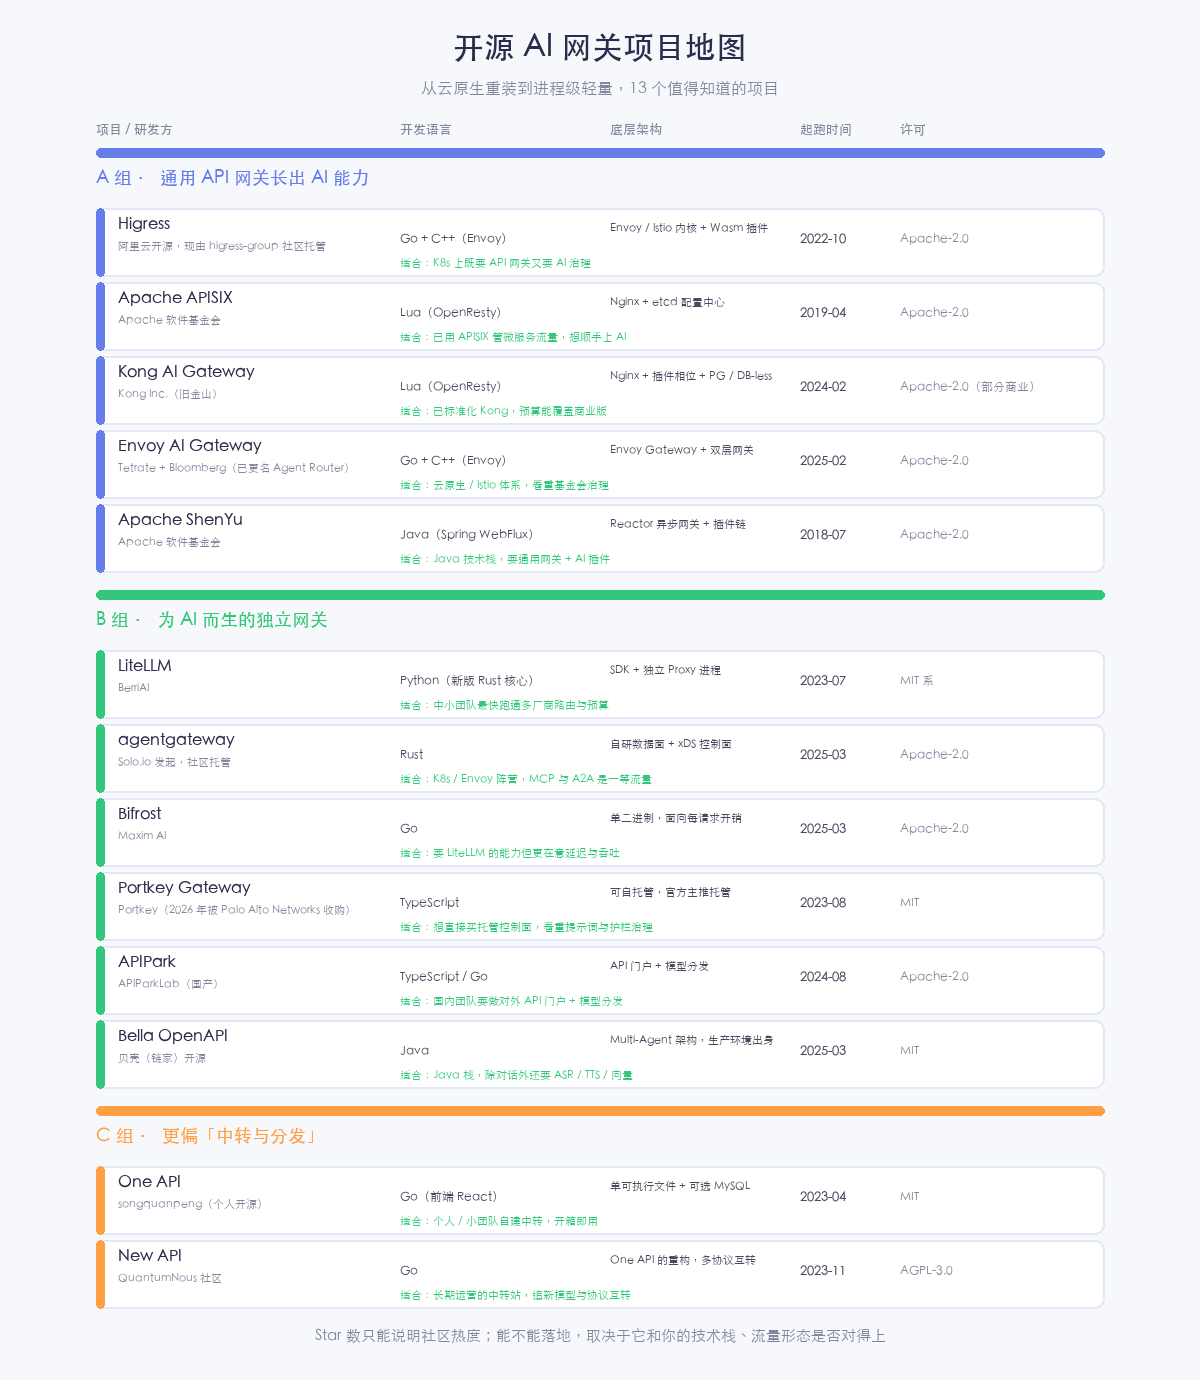
A 组 · 通用 API 网关长出 AI 能力
| 项目 | 研发方 | 语言 | 底层架构 | 起步 | 许可 | 适合什么样的公司 |
|---|---|---|---|---|---|---|
| Higress | 阿里云开源,现由 higress-group 社区托管 | Go + C++ | Istio / Envoy 内核 + Wasm 插件 | 2022-10 | Apache-2.0 | K8s 上既要 API 网关又要 AI 治理,希望 AI 能力全开源的团队 |
| Apache APISIX | Apache 软件基金会 | Lua(OpenResty) | Nginx + etcd 配置中心 | 2019-04 | Apache-2.0 | 已经在用 APISIX 管微服务流量,想顺手上 AI 的中大型企业 |
| Kong AI Gateway | Kong Inc.(旧金山,前身 Mashape,2009 年创立) | Lua(OpenResty) | Nginx + 插件相位 + PostgreSQL / DB-less | 2024-02(AI 插件) | Apache-2.0(高级能力在商业版) | 已标准化 Kong 管 API、且预算能覆盖商业版的平台团队 |
| Envoy AI Gateway | Tetrate + Bloomberg 联合发起,2026-09 更名为 Agent Router,归入 Agentic AI Foundation | Go + C++ | Envoy Gateway + 双层网关 | 2025-02 | Apache-2.0 | 云原生 / Istio 体系内的团队,看重基金会治理与自建推理调度 |
| Apache ShenYu | Apache 软件基金会 | Java(Spring WebFlux) | Reactor 异步网关 + 插件链 | 2018-07 | Apache-2.0 | Java 技术栈,要”通用网关 + AI 插件”的中大型企业 |
B 组 · 为 AI 而生的独立网关
| 项目 | 研发方 | 语言 | 底层架构 | 起步 | 许可 | 适合什么样的公司 |
|---|---|---|---|---|---|---|
| LiteLLM | BerriAI | Python(新版引入 Rust 核心) | SDK + 独立 Proxy 进程 | 2023-07 | MIT 系 | 中小团队,最快跑通多厂商路由、预算与降级 |
| agentgateway | Solo.io 发起,社区托管 | Rust | 自研数据面 + xDS 控制面 | 2025-03 | Apache-2.0 | K8s / Envoy 阵营,把 MCP 与 A2A 当一等流量的团队 |
| Bifrost | Maxim AI | Go | 单二进制,面向每请求开销优化 | 2025-03 | Apache-2.0 | 要 LiteLLM 的能力、但更在意延迟与吞吐的生产环境 |
| Portkey Gateway | Portkey(2026-04 宣布被 Palo Alto Networks 收购) | TypeScript | 可自托管,官方主推托管控制面 | 2023-08 | MIT | 不想自运维、看重提示词治理与守卫的产品团队 |
| APIPark | APIParkLab(国产) | TypeScript / Go | API 门户 + 模型分发 | 2024-08 | Apache-2.0 | 国内团队要做对外 API 门户 + 模型分发的场景 |
| Bella OpenAPI | 贝壳(链家)开源 | Java | 生产环境出身的纯 AI 网关 | 2025-03 | MIT | Java 栈,除对话外还要 ASR / TTS / 向量能力 |
C 组 · 更偏「中转与分发」
| 项目 | 研发方 | 语言 | 底层架构 | 起步 | 许可 | 适合什么样的公司 |
|---|---|---|---|---|---|---|
| One API | songquanpeng(个人开源) | Go 后端 + React 前端 | 单可执行文件 + 可选 MySQL | 2023-04 | MIT | 个人或小团队自建中转,追求开箱即用 |
| New API | QuantumNous 社区 | Go | One API 的重构,强调多协议互转 | 2023-11 | AGPL-3.0 | 需要长期运营的中转站,要追新模型与协议互转(商业化前先看许可证) |
三个值得注意的治理变化
盘点这几个项目,会看到三件比功能更重要的事:
- Envoy AI Gateway 已经更名,并且换了娘家。 它 2025-02-25 发布 v0.1.0,2026-06-23 达到 v1.0 GA;2026 年 9 月离开 CNCF 子项目结构,加入 Linux Foundation 旗下的 Agentic AI Foundation,更名 Agent Router。代码、维护者、Apache-2.0 许可和 API 都没有变(
aigw、AIGatewayRoute、aigateway.envoyproxy.io全部保留)。如果你在做技术选型,”Envoy AI Gateway”和”Agent Router”指的是同一个项目。 - Higress 的仓库地址已经迁移。 从
alibaba/higress迁到了higress-group/higress,治理上从”某公司的项目”变成了”社区托管”。这对企业的长期风险评估是加分项。 - 有两条商业化信号需要纳入考量。 Portkey 在 2026-04-30 宣布被 Palo Alto Networks 收购,长期可能并入 Prisma AIRS;Kong 在 2025-09 收购了计量公司 OpenMeter。押注一个项目的独立路线图之前,先看看它背后的资本动作。
四、四套主力方案,架构上差在哪
功能清单谁都能列。真正决定长期成本的是内核:数据面是什么、控制面用什么写、扩展机制怎么设计。
4.1 Higress:Istio + Envoy + Wasm
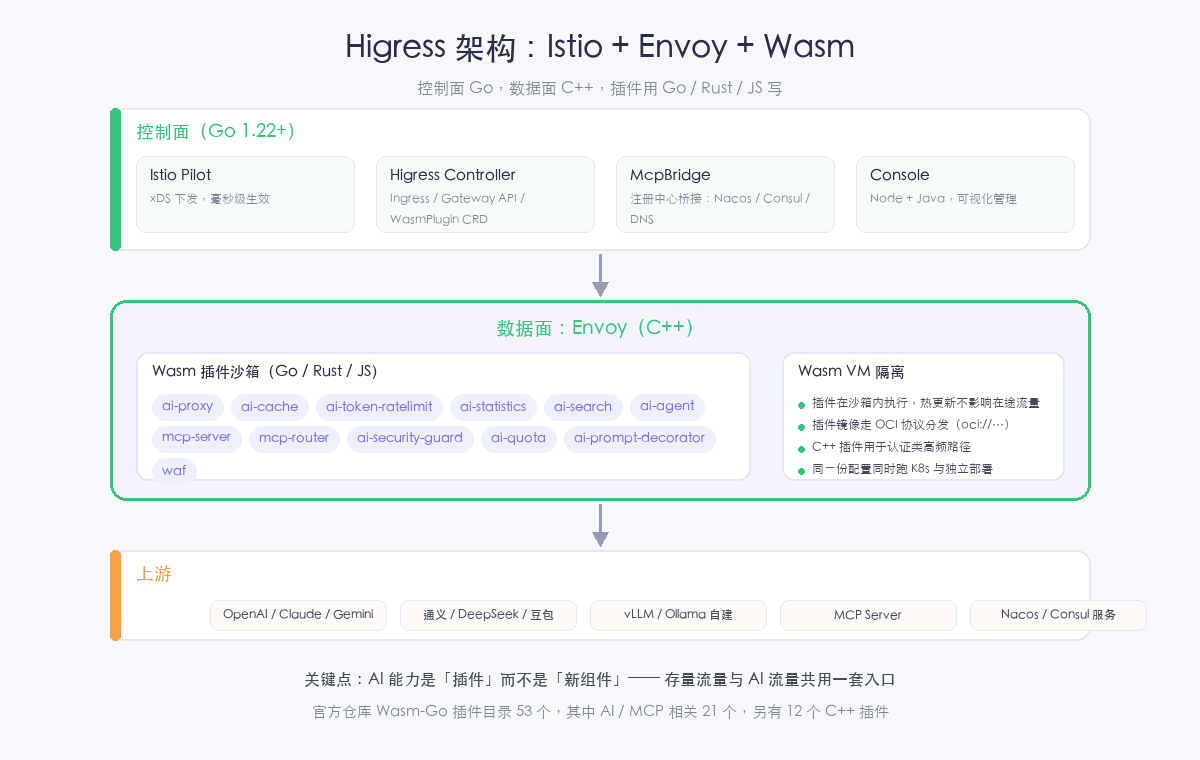
Higress 的结构可以概括成三层:
- 控制面用 Go 写:
Istio Pilot负责 xDS 下发,Higress Controller消费 Ingress / Gateway API /WasmPlugin等 CRD,McpBridge把 Nacos、Consul、Eureka、ZooKeeper、DNS 等注册中心桥接进来,另有一个基于 Node + Java 的 Console 做可视化管理。 - 数据面是原生 Envoy(C++):这意味着配置变更是 xDS 增量下发,毫秒级生效且对在途流量无损——这一点是它和基于 Nginx reload 的方案最本质的区别。
- 扩展靠 Wasm 插件沙箱:插件可以用 Go、Rust 或 JS 写,编译成 Wasm 后在沙箱里执行,热更新不影响在途请求,插件镜像通过 OCI 协议分发(配置里写
oci://地址即可)。
官方仓库的插件目录里,Wasm-Go 插件有 53 个目录,其中 AI / MCP 相关的有 21 个:
1 | ai-proxy ai-cache ai-token-ratelimit |
另外还有 12 个 C++ 插件(model-mapper、model-router、jwt_auth、key_auth、waf 等),主要覆盖认证类高频路径。
优点:
- 数据面能力和云原生生态直接复用(Istio / Envoy / Gateway API),不是自研代理。
- AI 能力以插件形式提供,存量 API 流量和 AI 流量共用一套入口,运维只有一份心智负担。
- 也是目前少数把 MCP Server 托管做成一等公民的方案(
mcp-server/mcp-router插件)。 - 部署方式覆盖从 5 分钟本地 Docker 到标准 K8s Helm,几乎没有断层。
缺点:
- 整个体系建立在 Istio / Envoy 概念之上,不熟悉 Service Mesh 的团队有一个明确的学习曲线(xDS、VirtualService、WasmPlugin CRD)。
- 想深度定制插件要写 Go 或 Rust 并编译 Wasm,比改一段 Lua 重。
- 独立部署(非 K8s)模式下控制台够用,但多环境配置同步仍要自己设计。
4.2 Apache APISIX:etcd 驱动的插件链
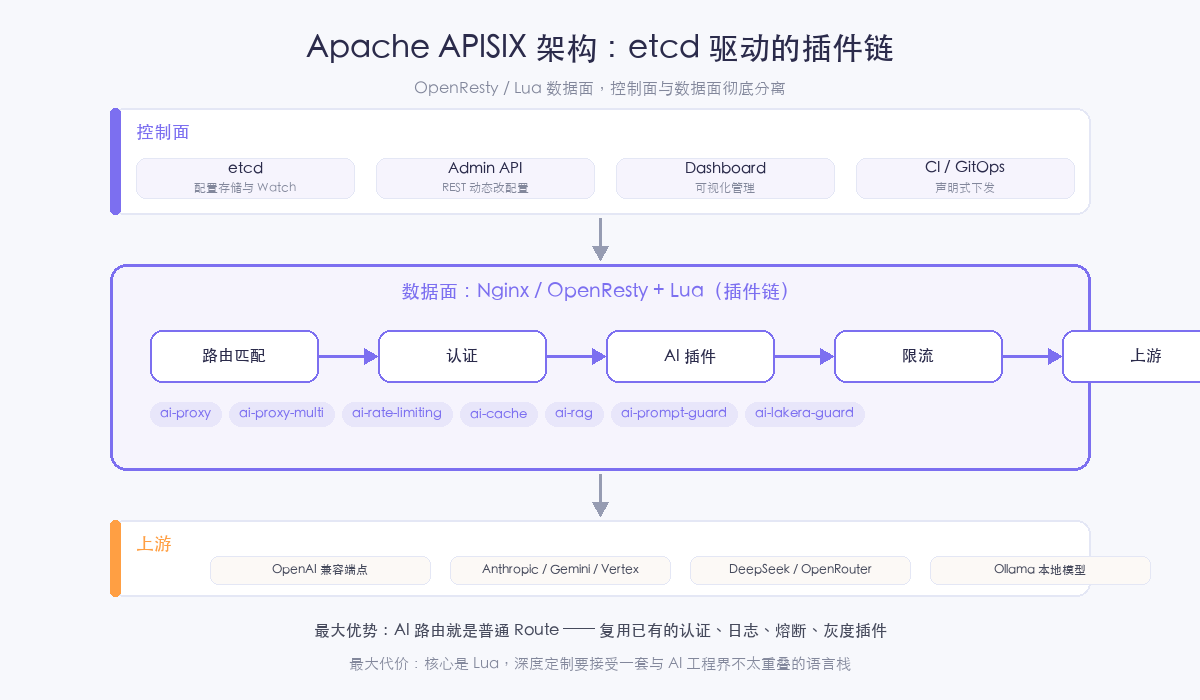
APISIX 的架构非常”干净”:控制面与数据面彻底分离,配置统一存在 etcd。数据面是 Nginx / OpenResty,所有能力都是 Lua 插件,挂在请求生命周期的固定阶段上。
它的 AI 能力同样是插件:ai-proxy(单模型/厂商代理)、ai-proxy-multi(多实例负载均衡与语义路由)、ai-rate-limiting(按 provider 上报的 token 计数限流)、ai-cache(Redis 支撑的精确 + 可选语义缓存)、ai-rag、ai-prompt-guard、ai-lakera-guard。
优点:
- AI 路由就是普通 Route。已有的认证、日志、熔断、灰度、可观测插件全部可以直接复用,这对已经上了 APISIX 的企业是极低成本。
- 插件生态极其成熟(100+ 网关插件),etcd 带来的动态配置体验在业内是第一梯队的。
- Apache 顶级项目、Apache-2.0 许可,治理和法务风险最低。
缺点:
- 核心是 Lua,而 Lua 在 AI 工程界几乎是空白地带——想做深度定制,得接受一套和 Python / Go 生态不太重叠的语言栈。
- AI 侧偏”代理与限流”:
ai-cache、ai-proxy-multi也提供了语义缓存与语义路由,但不解决自建推理的调度问题(没有 Endpoint Picker 这类 KV-Cache 感知能力)。 - AI 插件矩阵的厚度不如 Higress,MCP 治理也主要留给应用层。
4.3 Kong AI Gateway:OpenResty + 插件相位
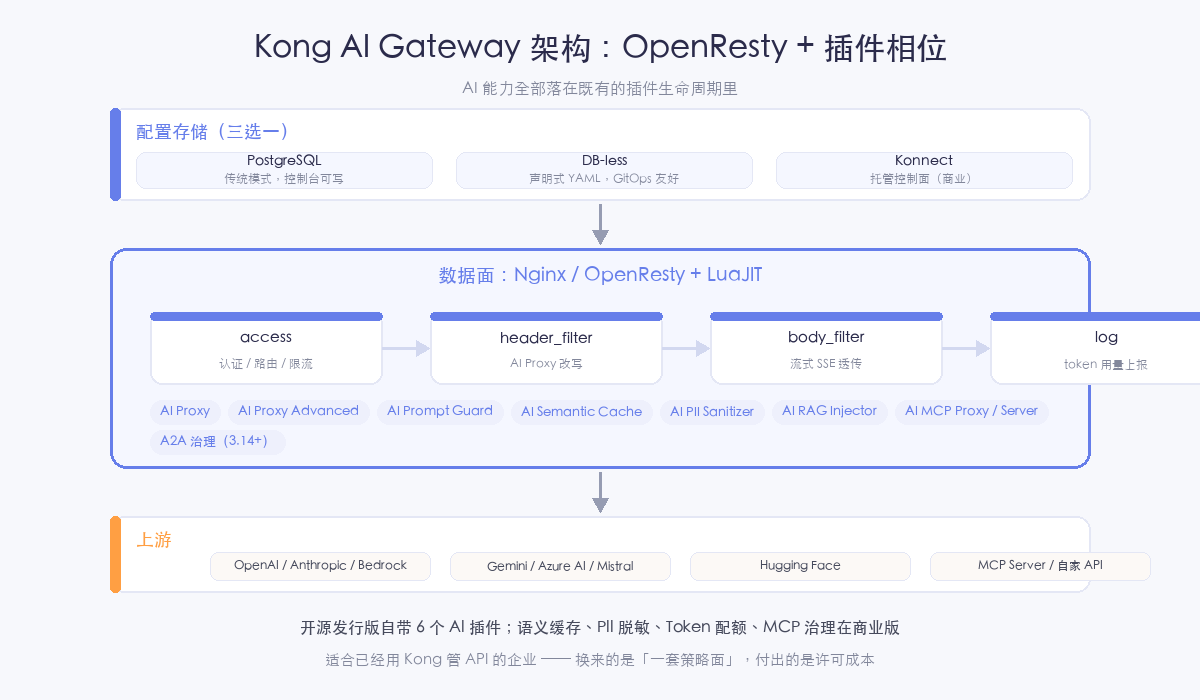
Kong 的路线是”把 AI 能力塞进既有的插件生命周期“,而不是另起一个运行时。
技术上,Kong 基于 OpenResty(Nginx + LuaJIT),核心逻辑、插件框架、路由引擎、管理接口都用 Lua 实现,跑在 Nginx worker 进程里。插件按相位(access / header_filter / body_filter / log)挂载。配置存储三选一:PostgreSQL(传统模式)、DB-less(声明式 YAML,GitOps 友好)、Konnect(托管控制面)。
时间线值得单独记一下:
- 2024-02,Kong Gateway 3.6 一次性开源了 6 个 AI 插件,Kong AI Gateway 正式亮相。
- 2024-05,3.7 GA,加入语义缓存、语义路由、Semantic Prompt Guard,以及 Gemini / Bedrock 支持。
- 2025-04,3.10 加入 AI RAG Injector 与 AI PII Sanitizer(支持 12 种语言、20 多类敏感数据)。
- 2026-04,3.14 推出 Agent Gateway,把 LLM、MCP、A2A(Agent2Agent)三类流量收进同一个控制面,并加入按模型的限流与精确 token 配额。
- 2026-09-01,AI Gateway 2.0 GA,从”插件套件”升级为独立 AI 原生运行时。
优点:
- 如果公司已经用 Kong 管 API,AI 能力几乎”零迁移成本”,一套策略面覆盖 API + LLM + MCP + A2A。
- 商业版能力非常完整:Token 级配额、语义缓存、PII 脱敏、MCP 工具治理、可视化与 SSO。
- 企业级工程成熟度最高(44k+ Star 的存量用户基础、K8s Operator、Konnect 托管)。
缺点:
- 免费与付费的切分点是选型的关键风险。开源版自带 6 个 AI 插件,覆盖代理、prompt 防护、请求响应改写;但”大家真正想要的那部分”——token 级限流、语义缓存、规模化 PII 脱敏、管理 GUI、MCP 与 A2A 治理——都在 Konnect 商业版。
- 计费方式对 Agent 场景不太友好:一个 agentic 工作流里,一次用户提问可能触发 20+ 次内部 API 调用,每个模型端点都算一个独立计费服务,请求量消耗远超同等规模的人工调用。
- 深度定制仍要写 Lua。
4.4 Envoy AI Gateway / Agent Router:双层网关
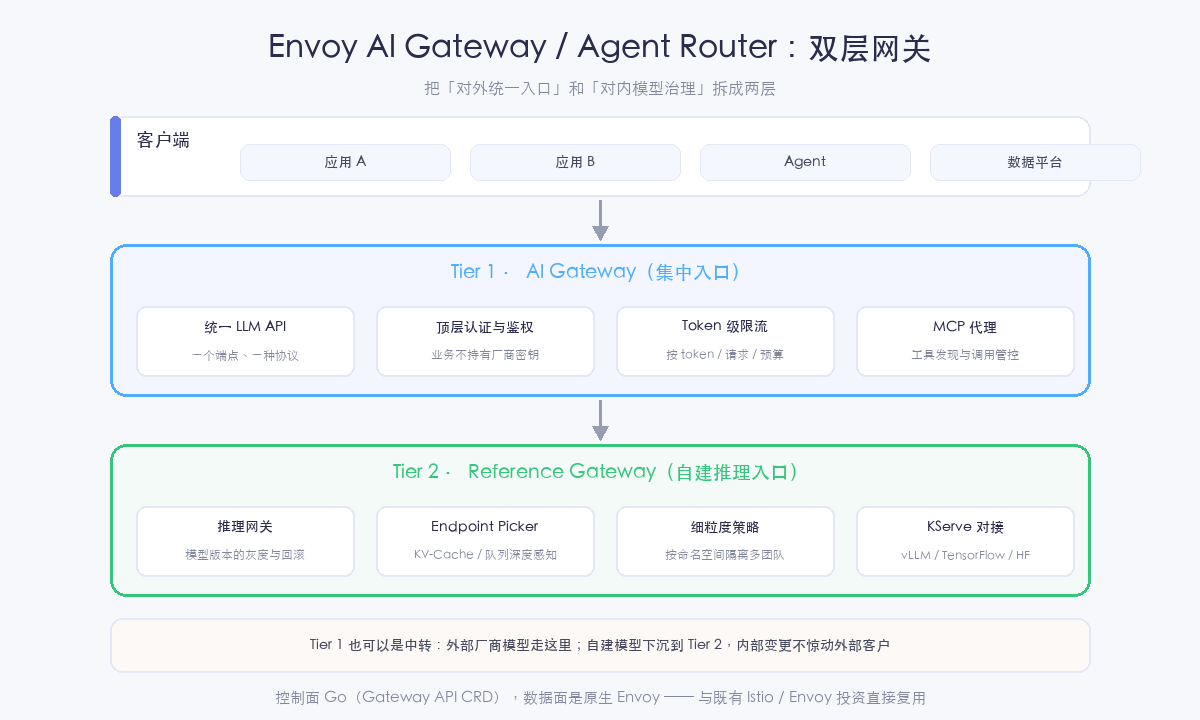
这是四者里架构最”教科书”的一个,核心设计就是双层网关(Two-Tier Gateway):
- Tier 1 · AI Gateway(集中入口):为所有客户端提供统一 LLM API,处理顶层认证、全局路由、Token 级限流,并且可以充当 MCP 代理。业务团队只需要知道一个端点,不需要关心后端是第三方还是自建。
- Tier 2 · Reference Gateway(自建推理入口):部署在模型服务集群里,负责内部路由、负载均衡,以及针对自建模型的细粒度策略。配合 Endpoint Picker 集成,可以按实时 AI 指标(KV-Cache 利用率、队列深度)做推理路由。自建侧通常对接 KServe(vLLM / PyTorch / TensorFlow / HuggingFace)。
这样拆的价值很清楚:Tier 1 面向客户,要稳;Tier 2 面向模型,要能频繁变更。 模型上线、灰度、回滚都在 Tier 2 内部完成,不会惊动外部调用方。
优点:
- 控制面是 Go(基于 Envoy Gateway 和 Kubernetes Gateway API CRD),数据面是经过无数生产环境验证的原生 Envoy——和既有 Istio / Envoy 投资直接复用。
- 双层结构把”对外入口”和”对内模型治理”解耦,这是所有同类方案里最干净的边界划分。
- 治理上归入 Linux Foundation 旗下的 Agentic AI Foundation,云原生血统最正。
- Token 级限流、跨后端 failover、集中凭证管理、OpenInference 分布式追踪都是原生能力。
缺点:
- 前置条件最重:本质上要求你已经或准备在 K8s + Gateway API 体系里工作,纯虚拟机环境用起来会很别扭。
- 项目相对年轻(2025-02 首发),生态和文档成熟度不如 Kong / APISIX,功能与文档偶有错位。
- 更名 Agent Router 之后社区还在磨合期,检索资料时要多加一个关键词。
五、正面对比:同一批能力,看谁原生、谁靠插件、谁在商业版
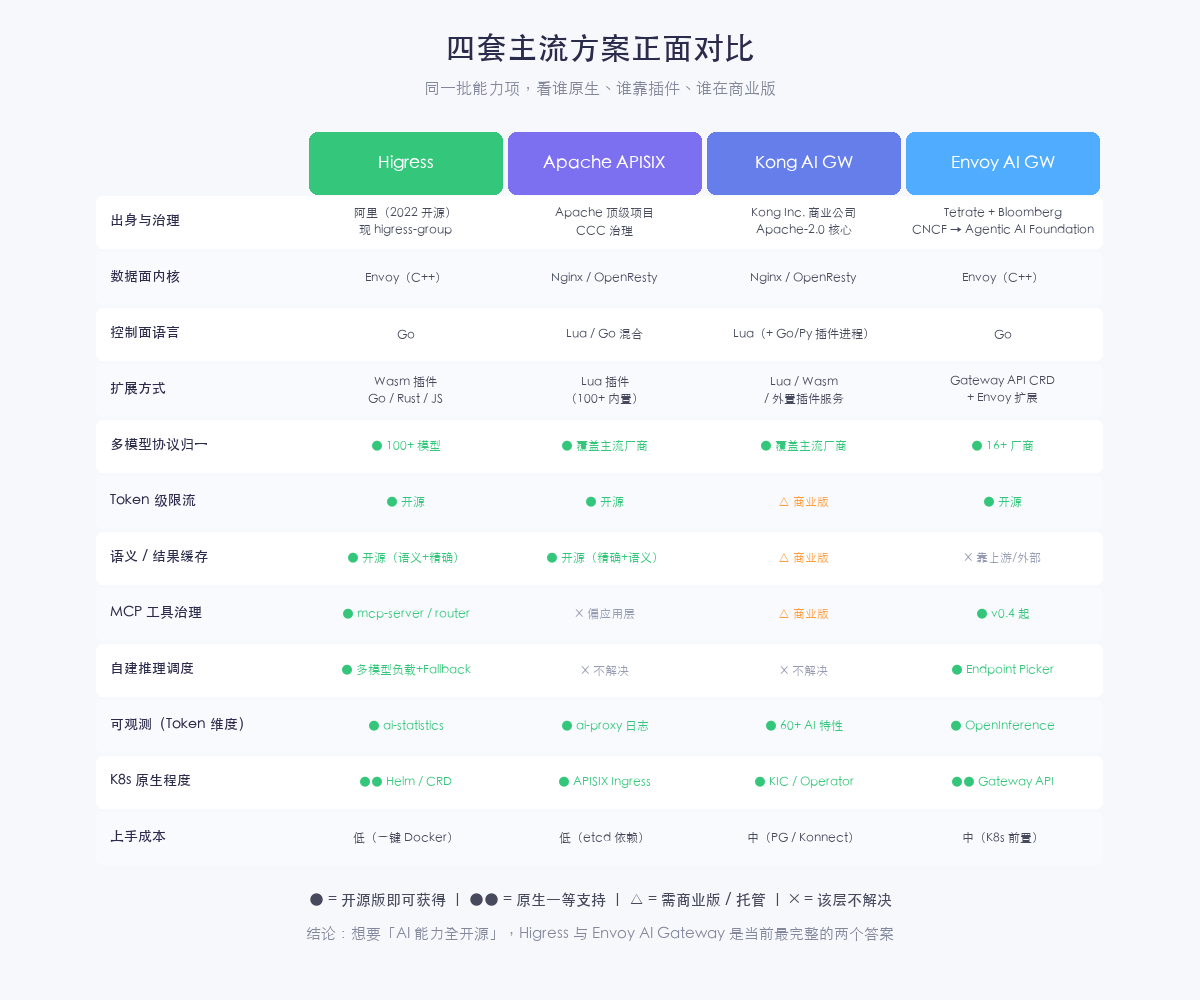
| 能力项 | Higress | Apache APISIX | Kong AI Gateway | Envoy AI Gateway / Agent Router |
|---|---|---|---|---|
| 出身与治理 | 阿里云开源,现社区托管 | Apache 顶级项目 | Kong Inc.,商业公司主导 | Tetrate + Bloomberg,基金会治理 |
| 数据面内核 | Envoy(C++) | Nginx / OpenResty | Nginx / OpenResty | Envoy(C++) |
| 控制面语言 | Go | Lua / Go 混合 | Lua(可外挂 Go / Python 插件进程) | Go |
| 扩展机制 | Wasm(Go / Rust / JS) | Lua 插件 | Lua / Wasm / 外置插件服务 | Gateway API CRD + Envoy 扩展 |
| 多模型协议归一 | 100+ 模型 | 主流厂商 + OpenAI 兼容 | 主流厂商 | 16+ 厂商 |
| Token 级限流 | 开源可得 | 开源可得 | 商业版 | 开源可得 |
| 语义 / 结果缓存 | 开源可得(语义 + 精确) | 开源可得(精确 + 语义) | 商业版 | 依赖上游或外部组件 |
| MCP 工具治理 | mcp-server / mcp-router |
偏应用层职责 | 商业版 | v0.4.0 起原生 |
| 自建推理调度 | 多模型负载 + Fallback | 不解决 | 不解决 | Endpoint Picker(KV-Cache 感知) |
| Token 维度可观测 | ai-statistics |
ai-proxy 日志 |
60+ AI 特性 | OpenInference 追踪 |
| K8s 原生程度 | 高(Helm / CRD) | 中(APISIX Ingress) | 高(KIC / Operator) | 最高(Gateway API) |
| 上手成本 | 低(一键 Docker) | 低(需 etcd) | 中(PG / Konnect) | 中(K8s 前置) |
但这份表最容易带来的误导是:看”支持什么”,不如看”哪一层解决的”。 以 MCP 治理为例,Higress 和 Agent Router 是从网关层原生解决,Kong 靠商业版实体,APISIX 则把这件事留给应用层——这三者在架构上根本不是同一件事,填进同一张表里也就失去了可比性。
再说一句关于基准测试的公道话:厂商自己跑的对比数据(Kong 对比 Portkey 和 LiteLLM、Solo 对比 Envoy + ext_proc)只能当作方向性参考,不能当结论。 每一份都是由被偏袒的那一方、在工作负载形状最有利的情况下跑出来的。看数据之前,先看谁付的钱。
六、一个 AI 请求穿过网关的全过程
理解了架构,再看一次真实链路,很多配置项就自然明白了。
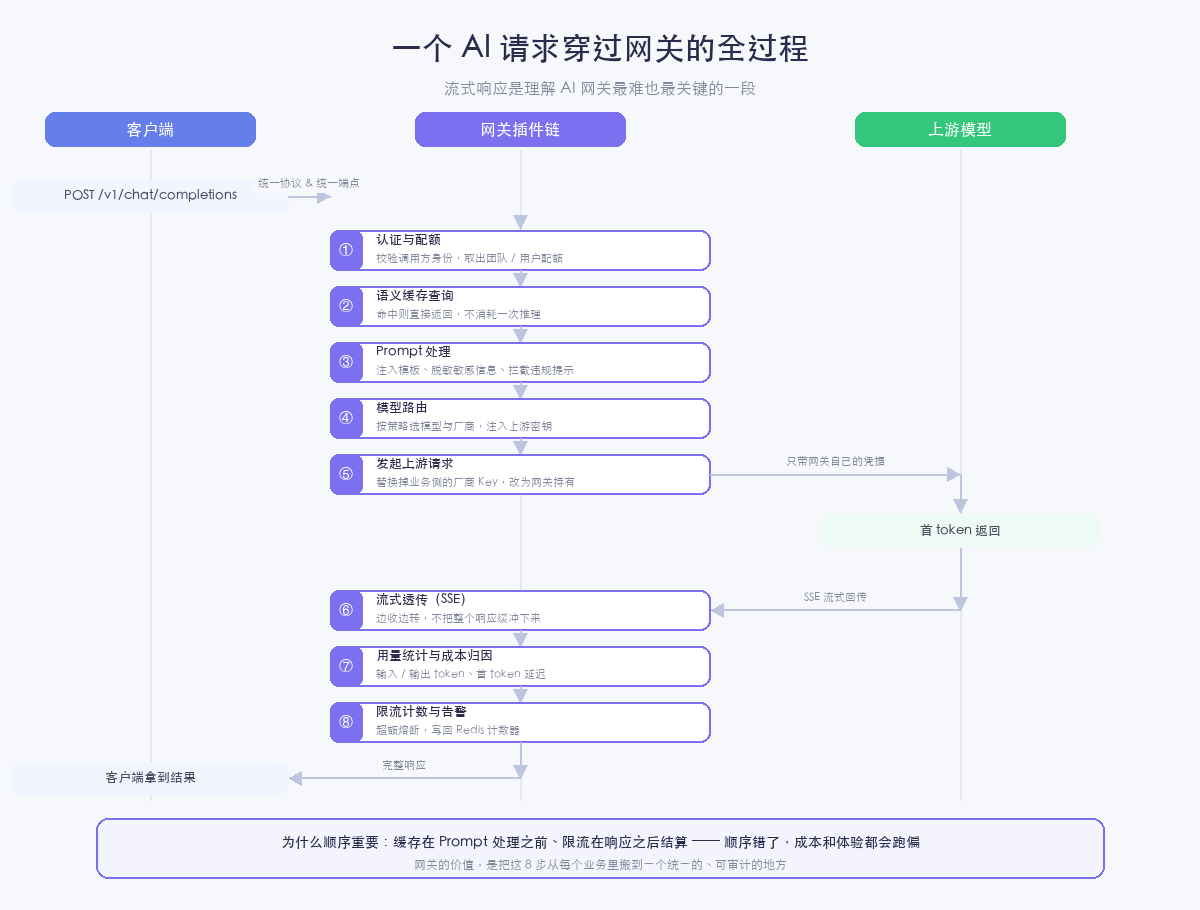
- 认证与配额:校验调用方身份,取出团队 / 用户维度的配额。这一步解决的是”谁在调用”。
- 语义缓存查询:命中则直接返回,不消耗一次推理。注意它排在 Prompt 处理之前——先判断”这个问题是不是被问过”。
- Prompt 处理:注入模板、脱敏敏感信息、拦截违规提示。
- 模型路由:按策略选择模型与厂商,把业务侧的厂商 Key 换成网关自己持有的密钥。
- 发起上游请求:此时业务进程里已经不存在任何真实密钥。
- 流式透传(SSE):边收边转,不把整个响应缓冲下来。这一步是 AI 网关最容易做错的地方——如果网关默认整包收完再发,首 token 延迟会直接翻倍。
- 用量统计与成本归因:输入 / 输出 token 数、首 token 延迟、端到端耗时。
- 限流计数与告警:写回 Redis 计数器,超额熔断。
为什么顺序重要? 缓存在 Prompt 处理之前、限流在响应之后结算——顺序错了,成本和体验都会跑偏。很多团队上线后觉得”网关没什么用”,回过头查配置才发现,是插件的执行顺序把收益抵消掉了。
七、动手:本地 5 分钟跑通 Higress AI 网关
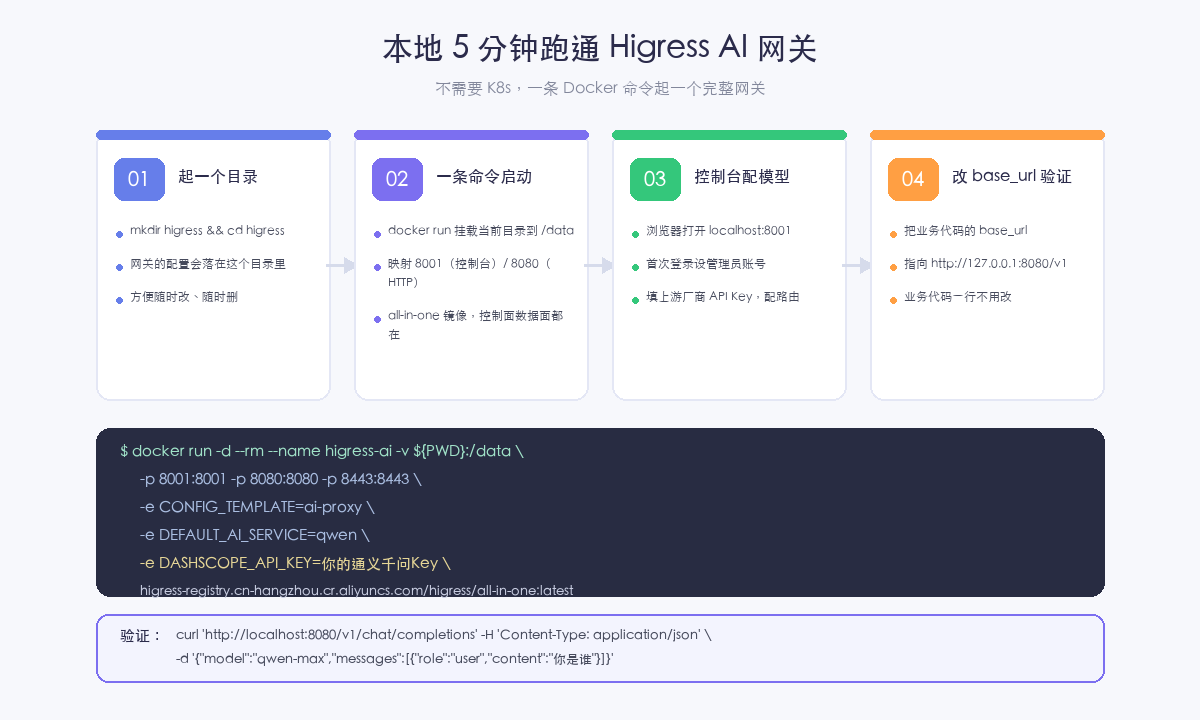
理论讲完,跑一遍最有说服力。下面这套流程不需要 K8s,一台装了 Docker 的笔记本就能完成。
7.1 前置准备
- Docker(或兼容运行时)
- 一个上游模型 API Key,本文以通义千问(DashScope)为例
7.2 方式 A:一键脚本(推荐第一次体验)
1 | curl -sS https://higress.cn/ai-gateway/install.sh | bash |
脚本会交互式地让你填 DashScope 或其他厂商的 API Key(也可以一路回车跳过,之后在控制台补)。需要注意:启动过程中 AI 网关需要访问外网资源,请确认运行环境有正常的互联网出口。
7.3 方式 B:一条 docker run(更可控)
1 | # 创建独立工作目录,配置会写进来 |
三个端口的分工:
| 端口 | 用途 |
|---|---|
| 8001 | Higress 控制台入口 |
| 8080 | 网关 HTTP 协议入口(业务流量走这里) |
| 8443 | 网关 HTTPS 协议入口 |
官方镜像使用了自己的镜像仓库,不受某些地区 Docker Hub 访问限制的影响。
如果不想用 Docker,也可以用本地文件模式直接跑一个最小化部署;或者把配置存储接到 Nacos:
1 | curl -fsSL https://higress.io/standalone/get-higress.sh | bash -s -- -a -c nacos://192.168.0.1:8848 \ |
注意把 IP 换成 Nacos 的真实地址——如果 Nacos 就部署在本机,**不要用 localhost 或 127.0.0.1**,因为脚本是在容器上下文里解析这个地址的。
7.4 控制台初始化
浏览器打开 http://localhost:8001/,首次访问需要设置管理员账号和密码。登录之后主要做四件事:
- 服务来源(Service Sources):把上游模型服务、注册中心加进来。
- LLM Provider 管理:配置各厂商的 API Key。目前集成了一批常用供应商,包括阿里云、DeepSeek、Azure OpenAI、OpenAI、豆包等。
- 域名管理(Domain):给 AI 路由分配一个访问域名。
- 路由管理(Route):创建路由并挂上 AI 插件。
7.5 配多模型代理与 Fallback
假设我们同时接入了通义千问和 DeepSeek,希望 DeepSeek 作为主路由,失败时自动降级到 qwen-turbo:
- 在 LLM Provider 管理 里分别配好两家的 API Key。
- 在 AI Route Config 里给 DeepSeek 路由配置 fallback:当请求目标服务失败(限流、访问异常等)时,回落到阿里云的
qwen-turbo模型。
这一步的意义在于:模型侧的故障不再需要业务方感知。业务拿到的永远是一个 OpenAI 兼容端点。
7.6 验证:改一行 base_url
最漂亮的地方在这里——**业务代码一行逻辑都不用改,只改 base_url**:
1 | from openai import OpenAI |
或者直接用 curl 验证:
1 | curl 'http://localhost:8080/v1/chat/completions' \ |
一个实用的小技巧:模型映射表是可以用正则的。比如想把所有 gpt-* 请求整体映射到 qwen-*,配置里写 "~gpt(.*)": "qwen-$1" 就够了。ai-proxy 的 modelMapping 支持三种写法:前缀匹配(gpt-3-*)、通配兜底(键为 *)、以及 ~ 前缀的正则匹配(目标名里可以用捕获组)。目标写成空字符串 "" 则表示保留原模型名。
7.7 加上真正产生价值的三类插件
跑通链路只是开始。下面三个插件决定了网关能带来多少实际收益。
① ai-statistics:把 Token 花在哪儿看清楚
这是最该第一个打开的插件。它默认识别 OpenAI 协议格式,开箱就提供:
- 指标:输入 token、输出 token、首个 token 的响应时间(流式请求)、请求总耗时,并支持在网关 / 路由 / 服务 / 模型四个维度上观测;
- 日志:
input_token、output_token、model、llm_service_duration、llm_first_token_duration等字段。
注意插件执行顺序是有讲究的:ai-proxy 优先级 100,ai-statistics 优先级 200,ai-token-ratelimit 优先级 600。改配置时如果发现统计不对,先看优先级。
② ai-token-ratelimit:AI 的成本是 token,不是请求数
插件基于 Redis,支持三种限流模式:
- 规则级全局限流:按
rule_name+global_threshold给一组规则设全局 token 阈值; - Key 级动态限流:按 URL 参数、请求头、客户端 IP、Consumer 名称或 Cookie 分组限流;
- 混合限流:两者同时配置,所有命中的规则叠加生效,任一触发即拒绝。
关键配置项:rule_name、rule_items(最多 10 条)、rejected_code(默认 429)、rejected_msg、redis。
③ ai-cache:把重复问法的钱省下来
支持语义化缓存(向量数据库)和字符串匹配缓存(KV 存储)两种模式。三条组合路径:
- 只配
cache:仅启用字符串匹配缓存; - 配
vector (+ embedding):启用语义化缓存; - 配
vector (+ embedding) + cache:语义化缓存 + 用 KV 存储加速 LLM 响应读取。
两个细节值得记住:cacheKeyStrategy 默认是 lastQuestion(用最后一个问题生成缓存键),也可以改成 allQuestions 或 disabled;如果业务需要绕过缓存,请求头带 x-higress-skip-ai-cache: on 即可。
语义缓存的阈值不要随便设。太松会返回错误答案,太严则命中率接近为零。稳妥做法是先上线精确缓存,拿到真实查询分布之后再调语义阈值。
7.8 如果要在 K8s 里用:WasmPlugin CRD
独立部署用控制台点点点很方便,但生产环境通常走声明式。下面以代理 Groq 服务为例,这是官方给出的完整配置骨架:
1 | apiVersion: extensions.higress.io/v1alpha1 |
注意 url 字段走的是 OCI 协议(oci://...),这是 Higress 分发 Wasm 插件的方式——插件版本和网关版本可以独立演进,不用重新构建镜像。
7.9 体验 MCP 网关
Higress 把 MCP 能力做成了两个插件:
- **
mcp-server**:把已有的 REST API 直接暴露成 MCP 工具,Agent 侧不用为每个内部系统写适配; - **
mcp-router**:在网关层做工具路由与统一入口。
配合 ai-agent 插件,就可以在网关上完成”模型 + 工具”的编排,而工具调用的权限、审计、限流全部收口在网关这一层。这是我认为 Higress 相比其他三个方案最值得一提的差异化能力。
7.10 常见问题排查
| 现象 | 大概率原因 | 处理 |
|---|---|---|
| 控制台 8001 打不开 | 端口被占用或容器没起来 | docker logs higress-ai;换端口需下载脚本改 DEFAULT_CONSOLE_PORT |
| 请求返回 401 / 403 | API Key 没生效或模型名未映射 | 控制台确认 Provider Key;检查 modelMapping |
| 首个 token 迟迟不来 | 流式被缓冲 / 超时设得太短 | 确认网关透传 SSE;把上游超时从默认 2 分钟按场景调整 |
| 报告模型不支持 | 模型名没做映射 | 配 modelMapping,或改用 ~ 正则批量映射 |
| 网关跑在容器里连不上本机服务 | 容器网络视角不同 | 用 host.docker.internal 或改用宿主机真实 IP,别用 127.0.0.1 |
| 想彻底清掉 | 容器带 --rm |
docker rm -f higress-ai,工作目录里的配置按需保留或删除 |
八、企业落地:五个阶段,顺序不能乱
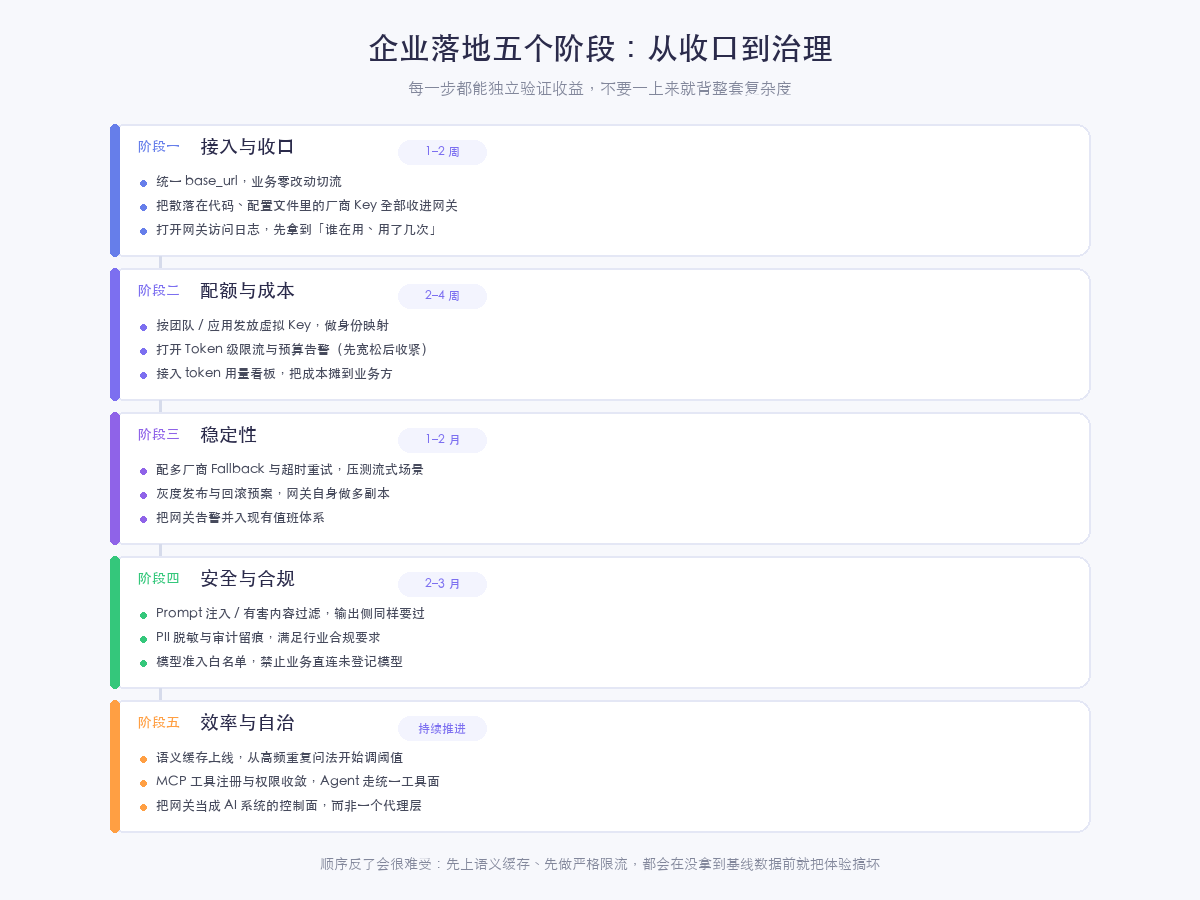
很多人把网关当成一个”装上去就有效果”的组件,结果上线两周就推不动了。真实落地更像一条有先后依赖的路径。
阶段一 · 接入与收口(1–2 周)
统一 base_url,业务零改动切流;把散落在代码和配置文件里的厂商 Key 全部收回网关;先打开访问日志,拿到”谁在用、用了几次”的基线数据。
阶段二 · 配额与成本(2–4 周)
按团队 / 应用发放虚拟 Key 做身份映射;打开 Token 级限流与预算告警(先宽松后收紧);接入 token 用量看板,把成本摊到业务方。这一步做完,财务第一次能自己回答问题。
阶段三 · 稳定性(1–2 月)
配多厂商 Fallback 与超时重试,压测重点放在流式场景;做灰度发布与回滚预案;网关自身必须多副本,并入现有值班告警体系。
阶段四 · 安全与合规(2–3 月)
Prompt 注入与有害内容过滤,输入侧和输出侧都要过;PII 脱敏与审计留痕;建立模型准入白名单,禁止业务直连未登记模型。
阶段五 · 效率与自治(持续推进)
语义缓存上线(从高频重复问法开始调阈值);MCP 工具注册与权限收敛,Agent 统一走工具面;最终把网关当成 AI 系统的控制面,而不是一个代理层。
这个顺序的好处是每一步都能独立验证收益。反过来做会很难受:先上语义缓存、先做严格限流,都会在还没拿到基线数据之前,就把用户体验搞坏了。
九、注意事项:最容易踩的八个坑
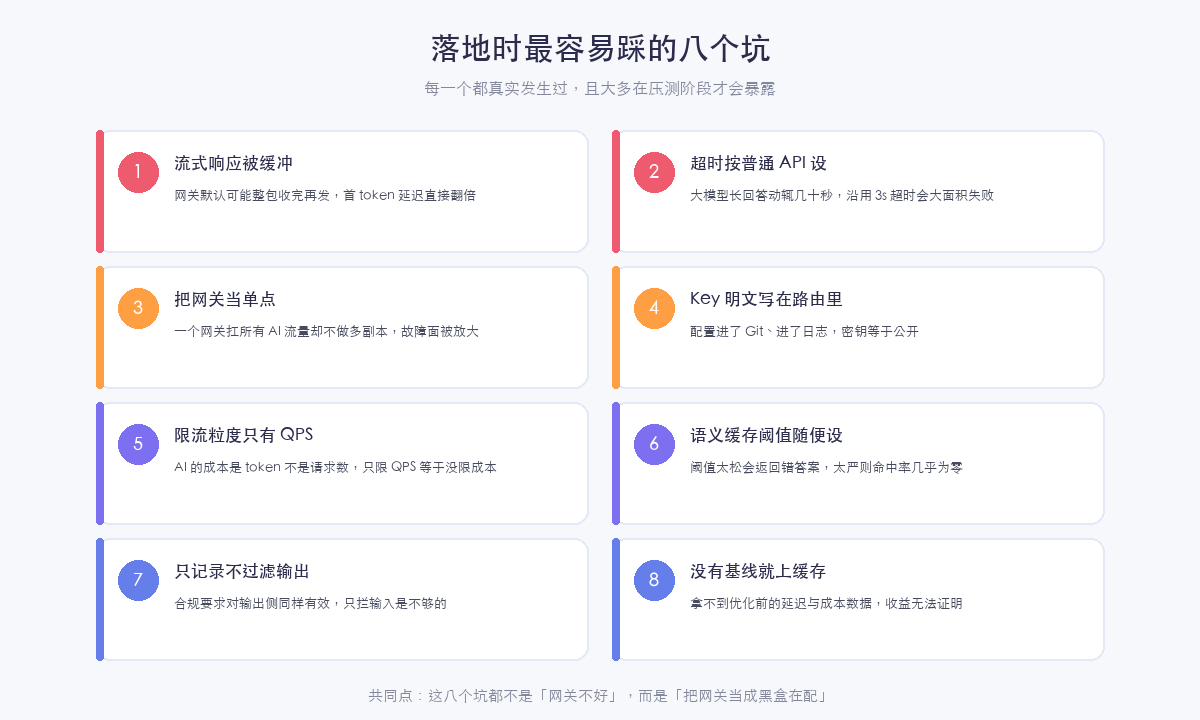
- 流式响应被缓冲。 网关默认可能整包收完再发,首 token 延迟直接翻倍。选型时一定要实测流式,不要只看功能列表。
- 超时按普通 API 设。 大模型长回答动辄几十秒,沿用 3 秒超时会大面积失败。Higress 的
ai-proxy默认超时是 120000ms(2 分钟),这个默认值是有道理的。 - 把网关当单点。 一个网关扛所有 AI 流量却不做多副本,故障面反而被放大——引入网关是为了降低风险,不要反过来。
- Key 明文写在路由里。 配置进了 Git、进了日志,密钥等于公开。APISIX 支持引用 Secret 资源;Kong 建议配 KMS 或 Secret Manager;Higress 至少要用 Kubernetes Secret 或独立的环境变量注入。
- 限流粒度只有 QPS。 AI 的成本是 token 不是请求数,只限 QPS 等于没限成本。一个 agentic 工作流一次提问可能触发 20+ 次内部调用,请求数完全无法反映真实消耗。
- 语义缓存阈值随便设。 阈值太松会返回错答案,太严则命中率几乎为零。先从精确缓存做起。
- 只记录不过滤输出。 合规要求对输出侧同样有效,只拦输入是不够的——尤其当模型有可能复述上下文里的敏感信息时。
- 没有基线就上缓存。 拿不到优化前的延迟与成本数据,收益无法证明,最后只能靠”感觉好像快了”来说服老板。
这八个坑的共同点是:它们都不是”网关不好”,而是”把网关当成黑盒在配”。
十、选型决策树:三问定方案
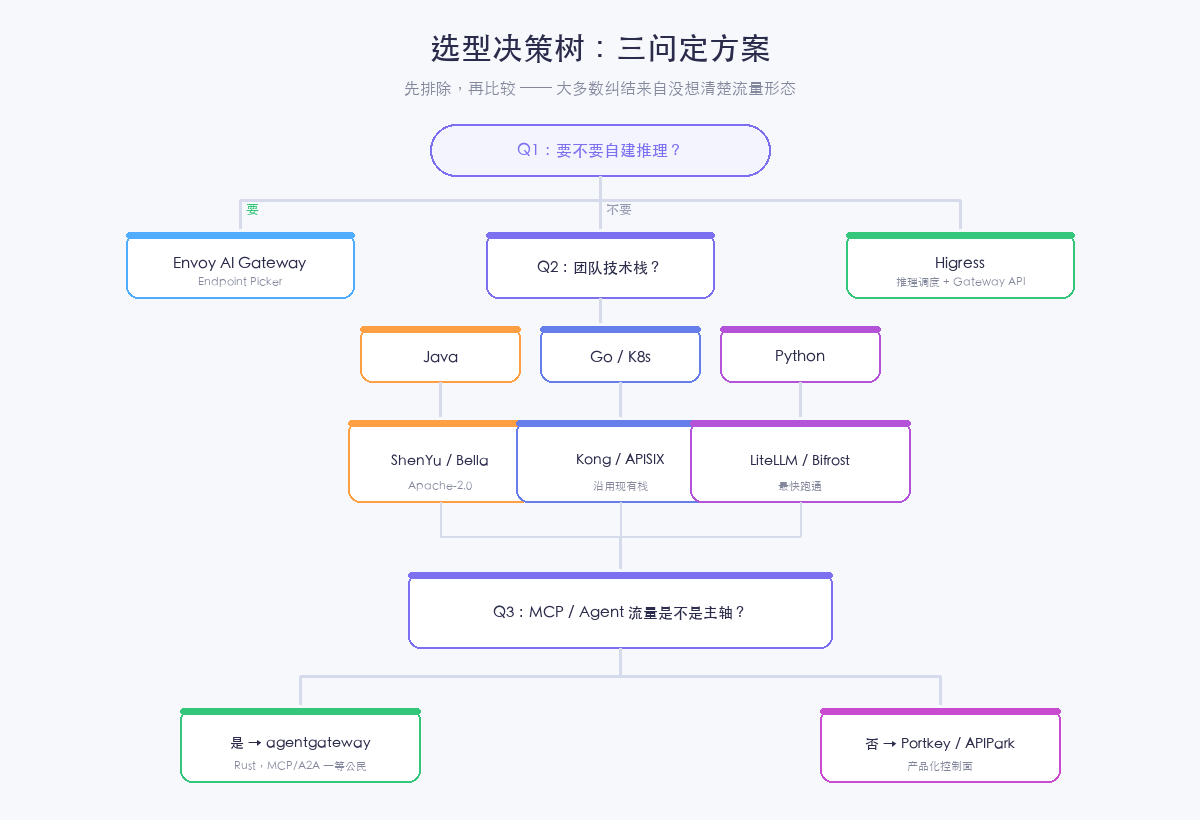
如果前面的内容太长,可以只看这一棵树的判断顺序。
Q1:要不要在网关这一层解决自建推理的调度?
- 要 → 你需要的其实是推理网关能力。Envoy AI Gateway / Agent Router(Endpoint Picker + KServe)或 Higress(多模型负载 + Fallback)是正解。
- 不要 → 进入 Q2。
Q2:团队的技术栈是什么?这决定了你愿意接受哪种”扩展语言”。
- Java →
Apache ShenYu(Apache-2.0,AI Proxy / MCP Server / AI Token Limiter 插件齐全)或Bella OpenAPI(贝壳开源,Java 栈,除对话外还覆盖 ASR / TTS / 向量)。 - Go / K8s 阵营 →
Kong(如果已经在用)或Apache APISIX(如果已经在用)。复用存量栈的价值远大于功能表上的几项差异。 - Python 为主、想最快跑通 →
LiteLLM(生态最大)或Bifrost(Go,每请求开销更低)。 - 不确定,但要求 AI 能力必须全开源 →
Higress。
Q3:MCP / Agent 流量是不是架构主轴?
- 是 →
agentgateway(Rust 自研数据面,把 MCP 与 A2A 当一等流量而非插件)或Higress(mcp-server/mcp-router)。 - 否,更看重产品化的控制面 →
Portkey(注意已被收购)或APIPark。
最后补一条上面这棵树没覆盖的判断:如果你已经标准化了某个网关,几乎总是应该先问”它能不能加 AI”,而不是”换哪家 AI 网关”。 因为引入第二套网关带来的策略分裂、运维成本和认知负担,往往比功能差那几项更贵。
写在最后
AI 网关这一层的本质,是把路由、预算、安全、观测四件事从每个业务里搬到同一个地方收口。
它不解决”模型够不够聪明”的问题,但它决定了这些聪明能不能被稳定、可控、可算账地交付出去。当 AI 从 Demo 走进生产、从一个人用变成一百个人用,这个层的价值就会开始指数上升。
工具会继续换代。Envoy AI Gateway 改名叫 Agent Router、Higress 迁移仓库、Portkey 被收购——都在一年之内发生。但那个判断标准不会变:
能让你的 AI 流量被管住、并且这套管法和你现有的技术栈对得上的方案,就是当下对你最好的方案。
数据口径说明:本文的项目语言、仓库地址、首个 / 最新版本与起跑时间均来自各项目 GitHub 仓库的公开元数据与 release 记录,抓取时间为 2026-10-15;Kong AI Gateway 的版本演进时间线、Envoy AI Gateway 的更名与治理变更来自项目官方文档与公告;Higress 的插件数量统计自 higress-group/higress 仓库当前 main 分支的插件目录。Star 数只反映社区关注度,不构成选型依据。
 微信
 支付宝
欢迎来到李苟蛋的个人博客,对本站的文章和技术问题有疑问或建议,欢迎留言,或者关注我的公众号:狗蛋的智栈