企业 Agent 开发框架选型:从「要不要做」到「六周跑通」,一文讲清
序言
这是 Agent 系列的第三篇。前两篇分别讲了 Harness Engineering(造环境)和 Context Engineering(管输入),讲的都是「怎么把 Agent 做好」。但过去半年被问得最多的问题其实更靠前:
「我们公司想上 Agent,该从哪儿开始?」
这个问题背后通常压着四件没答案的事:要不要做(哪些业务适合)、用什么做(框架怎么选)、怎么做(落地路径)、做完怎么算成功(验收)。市面上讲框架对比的文章很多,但从「要不要做」一路讲到「六周跑通」的很少,这篇补上。
先给全文的结论,赶时间的可以只带走这三句:
- 企业 Agent 的甜区只有一个:多步骤、可验证、失败代价可承受的业务流程。 不满足这三条的,先别做。
- 框架不是护城河。 2026 年框架层正在快速收敛,你真正该积累的是数据、评测集和流程理解——这些不会随框架换代而作废。
- 落地比选型难,但难的地方不在代码。 一个能跑的 Agent 只要 30 行,难的是把数据接干净、把验收标准定清楚。
一、企业为什么要做 Agent:从「答问题」到「办事」
先厘清概念。2023 年企业聊的是 Chatbot,2024 年聊的是 RAG 知识库,2026 年聊的是 Agent——这三代系统经常被混为一谈,但它们交出来的东西完全不同:
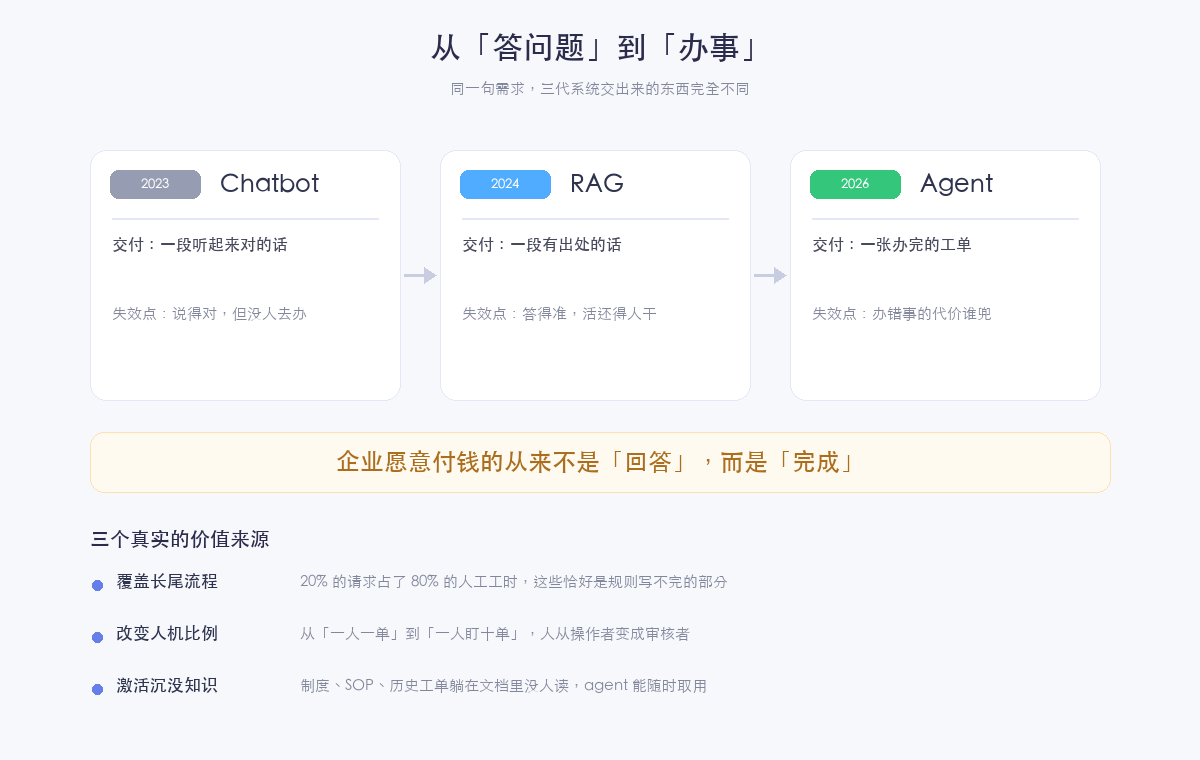
| 代际 | 用户拿到什么 | 失效方式 |
|---|---|---|
| Chatbot | 一段听起来对的话 | 说得头头是道,但没人去办 |
| RAG | 一段有出处的话 | 答得准,活还是得人干 |
| Agent | 一件办完的事(工单、报告、草稿) | 办错事,且代价真实 |
企业愿意付钱的从来不是「回答」,而是「完成」。 这是 Agent 和前两代的本质区别,也是它值得投入的原因。落到具体价值上,我看到三个真实的来源:
其一,覆盖长尾流程。 每个企业都有一类需求:请求量不小、单个不值得开发、规则又多到写不完——IT 服务台、HR 咨询、单据预审。传统做法要么堆人工,要么上一个巨贵的定制系统。这类「20% 的请求占 80% 人工工时」的长尾,恰好是大模型 + 工具调用的最佳射程。
其二,改变人机比例。 Agent 化之后,人的角色从「操作者」变成「审核者」:从一人处理一单,变成一人盯着十单的例外。这个比例变化才是 ROI 的真正来源——不是「省了几个人」,而是「同样的人能承接几倍的业务波动」。
其三,激活沉没知识。 制度文件、SOP、历史工单躺在网盘里没人读。Agent 把它们变成随时可调用的能力,这是几乎所有企业都已经有、却从未被用起来的资产。
但先泼一盆冷水:Agent 不是万能药,它有明确的适用边界。 这就是下一节。
二、哪些业务适合做 Agent,哪些不适合
我筛业务只用两个轴:失败代价(做错了损失多大、能不能挽回)和任务变异度(每次请求的差异有多大、规则能不能写全)。两个轴画出来,四个象限立刻分清:
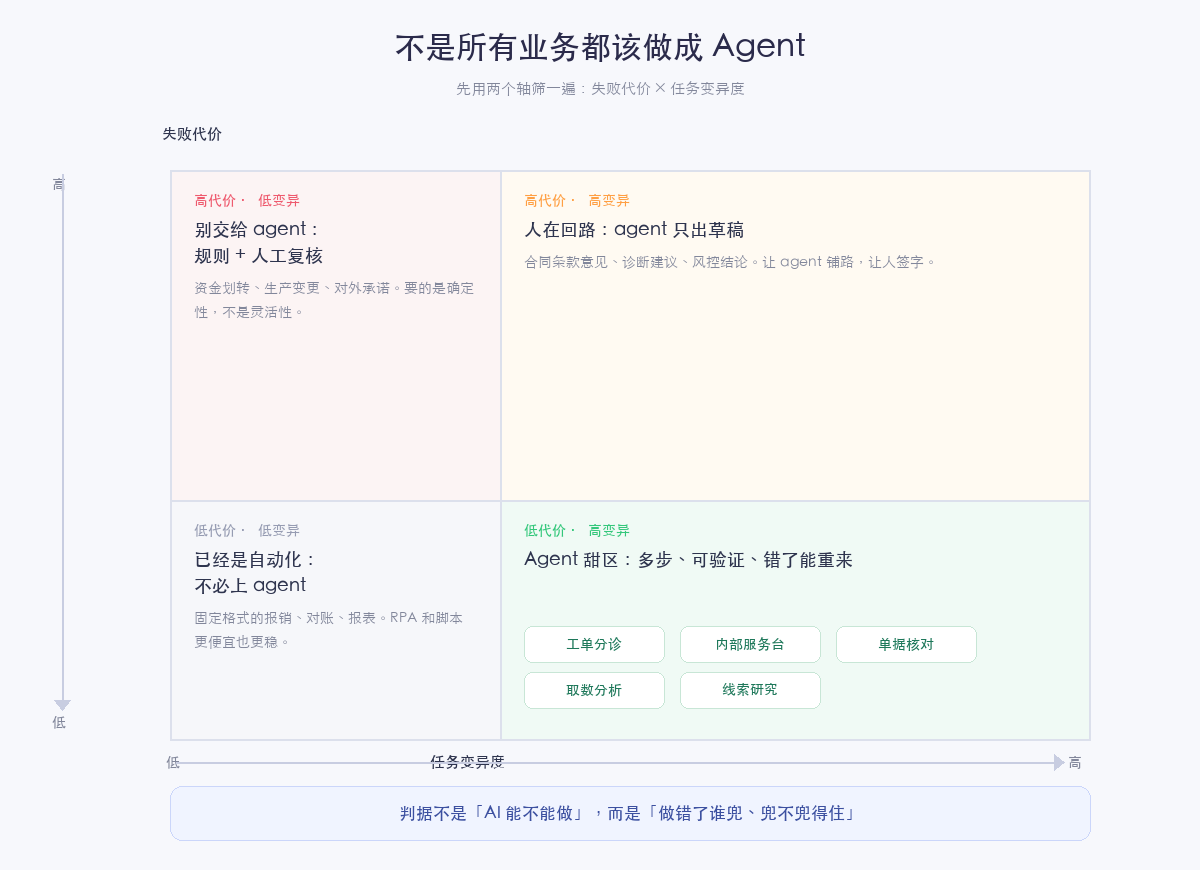
- 高代价 · 低变异 → 别交给 Agent。 资金划转、生产环境变更、对外法律承诺。这类事变异度低,意味着规则能写全——那就写规则、上传统自动化,加人工复核。要的是确定性,不是灵活性。
- 高代价 · 高变异 → 人在回路。 合同条款意见、诊断建议、风控初判。让 Agent 铺路出草稿,人签字拍板。这是目前企业 Agent 最主流、也最稳妥的形态。
- 低代价 · 低变异 → 不必上 Agent。 固定格式的报销、对账、报表。RPA 和脚本更便宜、更快、更稳,用 Agent 属于杀鸡用牛刀。
- 低代价 · 高变异 → Agent 甜区。 工单分诊、内部服务台、单据核对、取数分析、销售线索研究。多步骤、每步可验证、错了可以重来——这三条同时满足的业务,闭眼做。
一条更朴素的判据:不要问「AI 能不能做」,要问「做错了谁兜、兜不兜得住」。 前者决定可行性,后者决定该不该做。
三、开源 Agent 框架全景:五派格局
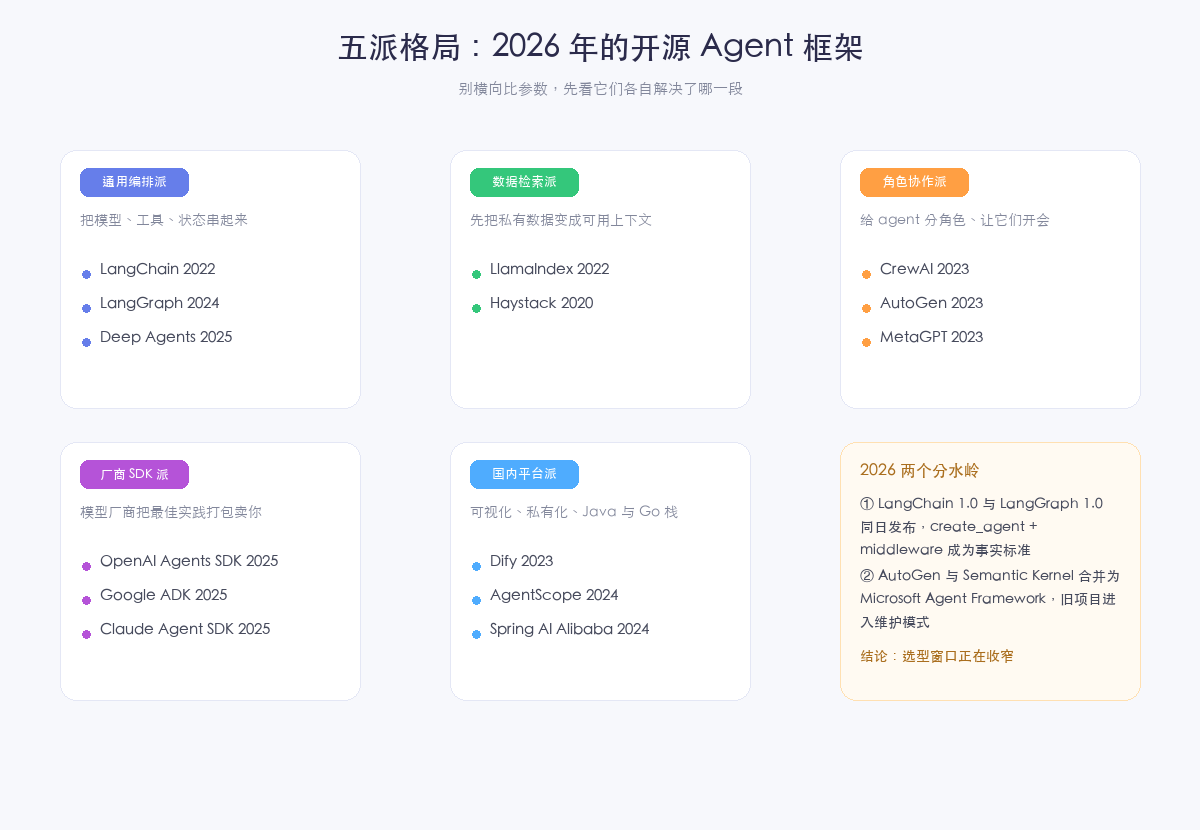
选型的第一步是看清地形。2026 年的开源 Agent 框架,与其按知名度排座次,不如按「它们各自解决了哪一段」分成五派:
| 框架 | 公司 / 团队 | 开源时间 | 仓库 | 一句话定位 |
|---|---|---|---|---|
| LangChain | LangChain | 2022-10 | langchain-ai/langchain | 通用 LLM 应用框架,生态最广 |
| LlamaIndex | LlamaIndex | 2022-11 | run-llama/llama_index | 数据优先,RAG / 文档处理最深 |
| Haystack | deepset | 2020-04 | deepset-ai/haystack | 老牌生产级 RAG 管线 |
| AutoGen | Microsoft Research | 2023-09 | microsoft/autogen | 多 Agent 对话(已并入 MAF,维护模式) |
| CrewAI | CrewAI Inc. | 2023-12 | crewAIInc/crewAI | 角色化多 Agent,上手最快 |
| MetaGPT | DeepWisdom 等 | 2023 | FoundationAgents/MetaGPT | 软件公司式拟人多 Agent |
| Dify | LangGenius(苏州) | 2023 | langgenius/dify | 可视化低代码 LLM 应用平台 |
| LangGraph | LangChain | 2024-01 | langchain-ai/langgraph | 状态图运行时,持久化执行 |
| AgentScope | 阿里通义实验室 | 2024-02 | agentscope-ai/agentscope | 多智能体框架,主打可观测可信 |
| Spring AI | VMware / Broadcom | 2024-02 | spring-projects/spring-ai | Java 生态的 AI 能力抽象层 |
| Spring AI Alibaba | 阿里 | 2024-09 | alibaba/spring-ai-alibaba | Java 企业级 Agent,集成 Nacos / Higress |
| OpenAI Agents SDK | OpenAI | 2025-03 | openai/openai-agents-python | 官方轻量 SDK,handoffs + guardrails |
| Google ADK | 2025-04 | google/adk-python | Gemini 全家桶,Vertex 一键部署 | |
| Deep Agents | LangChain | 2025-07 | langchain-ai/deepagents | 开箱即用的 Agent 线束 |
| Claude Agent SDK | Anthropic | 2025-09 | anthropics/claude-agent-sdk-python | Claude Code 核心开放为 SDK |
| Microsoft Agent Framework | Microsoft | 2026-04(GA) | microsoft/agent-framework | AutoGen + Semantic Kernel 的统一继任者 |
| Eino | 字节 CloudWeGo | 2024 | cloudwego/eino | Go 生态 Agent 编排 |
表之外,2026 年有两件事值得单独记:
一是 LangChain 1.0 与 LangGraph 1.0 在 2025 年 10 月同日发布。 create_agent 抽象 + middleware 钩子体系定型,随后一年里几乎所有主流框架都跟进了这个「agent 优先 + 中间件」的重写模式——它成了这个品类的事实标准。
二是微软把 AutoGen 和 Semantic Kernel 合并成 Microsoft Agent Framework,2026 年 4 月 GA。 AutoGen 名气最大(星数长期第一梯队),但已进入维护模式只修不进。这件事的信号意义大于技术意义:框架层进入整合期,押注单点框架的风险第一次变得真实。
另外提一句国内生态的鲜明特点:海外框架是代码优先、强调可组合;国内 Dify、Coze 这类平台是可视化优先、企业特性(权限、审计、内容合规钩子)从第一版就内置。这不是谁先进谁落后的差别,是采购路径的差别。
四、不同框架适合什么场景
4.1 先看 LangChain 家族:一条栈,不是一个选择题
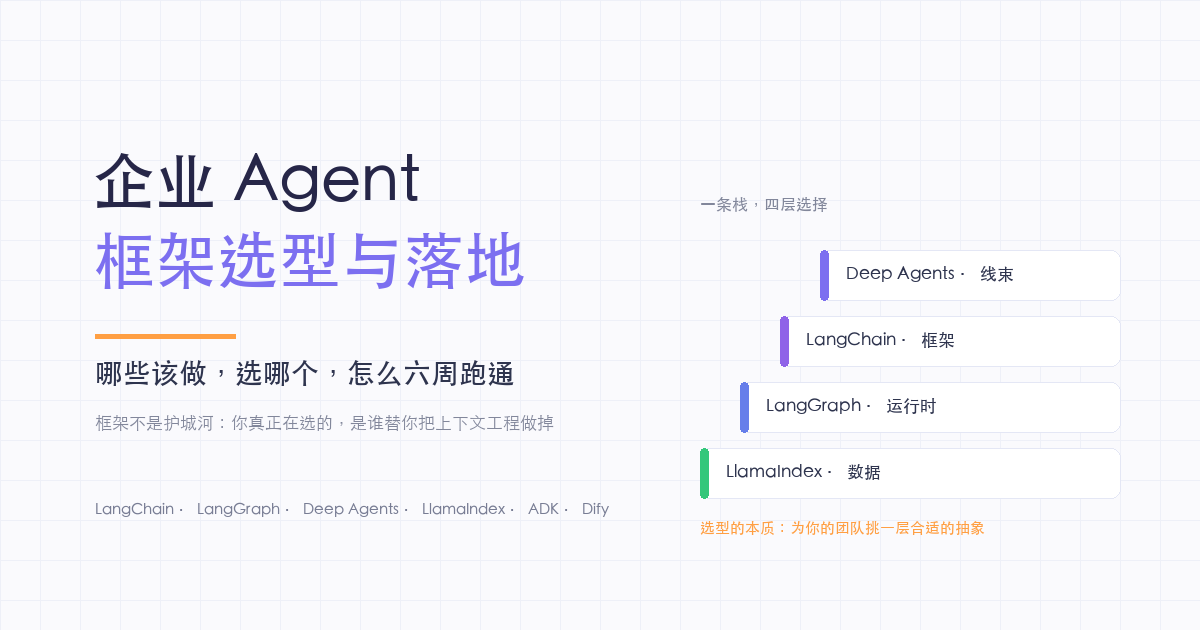
很多人把 LangChain、LangGraph、Deep Agents 当三个竞品来比,这是最大的误区。官方自己的定位是:LangGraph 是运行时,LangChain 是框架,Deep Agents 是线束(harness)——同一条抽象阶梯上的三层,运行时控制最多、抽象最少,线束反过来。
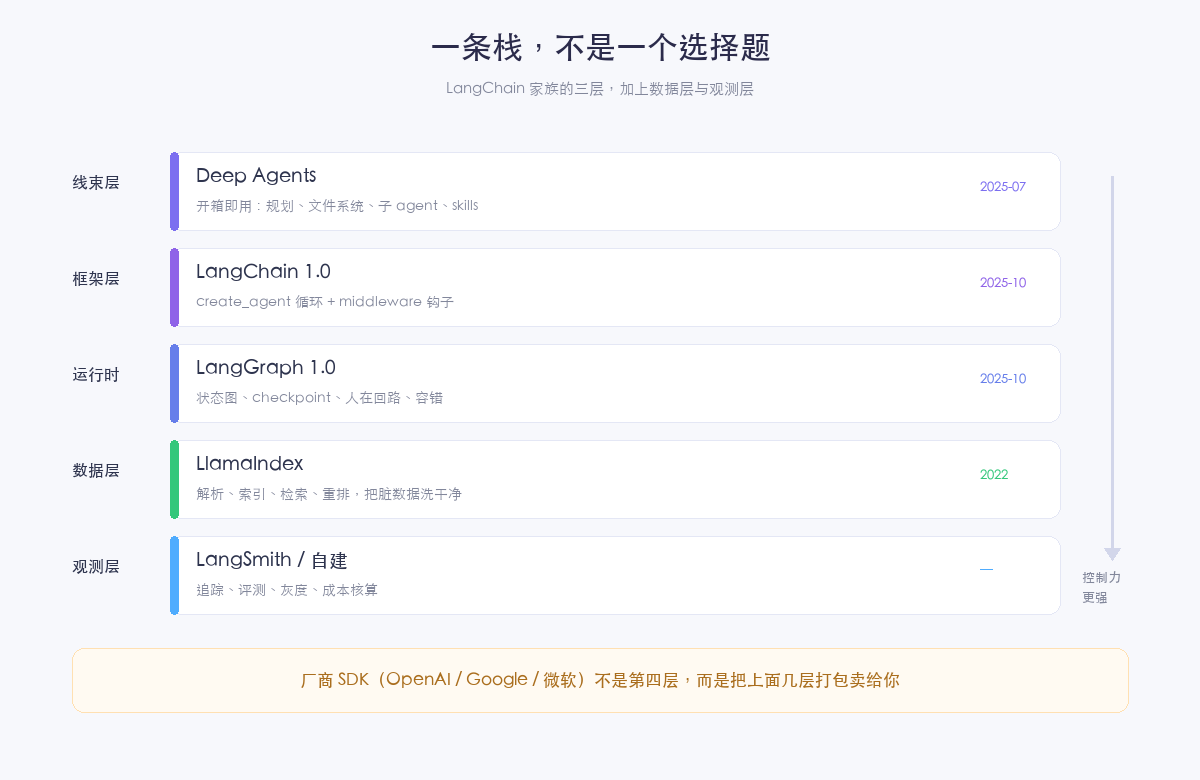
三个关键事实:
- 官方建议的路径是反直觉的:从最高层 Deep Agents 起步,只有当你要建模复杂工作流、或想完全掌控每一步时才往下掉。
- Deep Agents 本质上就是 LangChain 核心 agent 加一组 middleware(官方原话),所以三层完全可组合,上下移动不需要重写。
- Deep Agents 内置的文件系统、子 agent、skills、记忆,拆开看正是 Context Engineering 四策略(写、选、压、隔)的产品化——选框架的本质,是在选「谁替你把上下文工程做掉」。
4.2 场景到框架的映射
| 你的场景 | 首选 | 理由 |
|---|---|---|
| 制度 / 知识库问答,文档是主要矛盾 | LlamaIndex | 解析(复杂表格、图文混排)与检索深度无可替代 |
| 多步业务流程 + 工具编排 | LangChain + LangGraph | 生态集成最广,运行时可持久化、可回放 |
| 长时复杂任务(深度研究、编码式) | Deep Agents | 规划、文件系统、子 agent 开箱即用 |
| 快速 PoC、角色分工明确的协作 | CrewAI / Dify | 概念最少,半天出 demo |
| 已在 GCP / 用 Gemini,含语音视频 | Google ADK | 双向流式是独家能力,一条命令上 Vertex |
| .NET / Java 技术栈的企业 | Microsoft Agent Framework / Spring AI Alibaba | 语言栈匹配比框架先进性重要得多 |
| 单 agent、轻量、OpenAI 栈 | OpenAI Agents SDK | 三个核心概念,10 行起步 |
| 强合规审计(金融、医疗) | LangGraph 或 MAF | 显式状态图 / workflow + checkpoint,每步可举证 |
4.3 国内企业的三个特殊约束
硅谷博客里的「最佳实践」,到国内要过三道本地化滤镜:
- 数据出域是硬约束。 金融、政企、医疗场景,「模型和 Agent 都留在机房」不是加分项,是采购前置条件。这直接影响选型:云托管型(Vertex Agent Engine、LangSmith 云)要评估私有化替代;Dify、AgentScope、Spring AI Alibaba 的自托管路线因此吃香。
- Java / Go 存量栈庞大。 国内核心系统的技术栈现实决定了 Spring AI Alibaba 和 Eino 这类框架有真实需求——「让 Agent 长在现有微服务体系里」比「为 Agent 新起一套 Python 服务」在组织上容易推进得多。
- 成本极敏感。 同一模型不同脚手架,token 成本能差数倍。token 的单位经济学,是国内 Agent 立项评审的计分板。
五、上手:30 行代码跑通一个真的能用的 Agent
理论讲完,动手。选哪个框架做第一个 demo?我的标准是:装一个包、概念不超过三个、跑完就能给同事用。综合下来我选 LlamaIndex——不是因为它是「最好的框架」,而是因为它把「接数据」这个最难的环节封装得最好,而接数据恰恰是企业落地第一周的真正瓶颈。
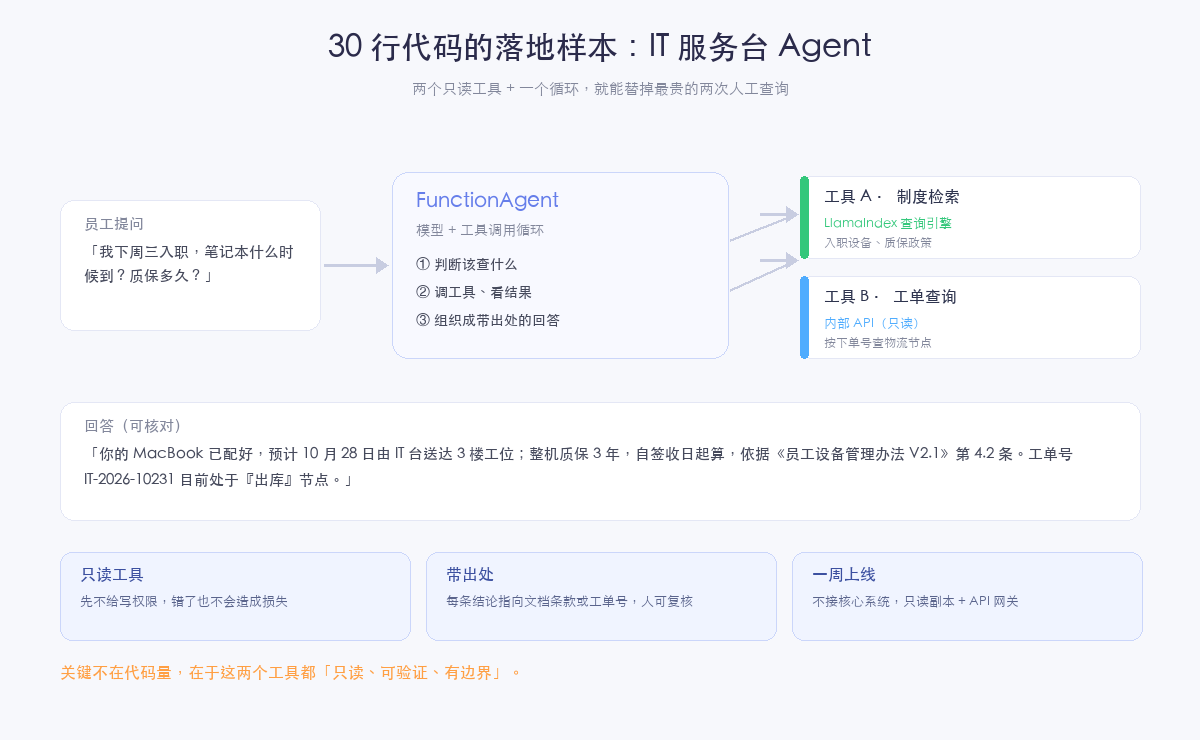
做一个真实场景:IT 服务台 Agent。员工问「我下周三入职,笔记本什么时候到?质保多久?」——这个问题要查两个地方:设备制度文档、工单系统。正好演示「RAG + 工具调用」的最小组合。
第一步,装依赖:
1 | pip install llama-index requests |
第二步,准备数据并定义两个只读工具:
1 | import os, requests |
第三步,组装 Agent 并运行:
1 | llm = OpenAILike( |
运行效果大致是:
你的 MacBook 已配好,预计 10 月 28 日由 IT 台送达 3 楼工位;整机质保 3 年,自签收日起算,依据《员工设备管理办法 V2.1》第 4.2 条。工单号 IT-2026-10231 目前处于「出库」节点。
三个设计决策值得注意:
- 两个工具都是只读的。 先不给写权限,Agent 幻觉了也不会造成损失——这是第一个上线的 Agent 该有的样子。
- system_prompt 里强制「给依据、不编造」。 这一行是这个 Agent 和普通 Chatbot 的分界线:每条结论可追溯到条款或工单号,员工敢信,客服敢认。
- 模型走 OpenAILike 接口,base_url 指向哪就在哪跑。 内网 vLLM、通义、DeepSeek 都能直接替换——数据不出域的约束在这个抽象层就解决了,不依赖框架承诺。
这个 demo 大约 30 行,一周内可以上线给一个几十人的团队用。它当然不完美,但它完成了最重要的事:让组织第一次拥有了一个可评测、可迭代的真实 Agent,而不是一份 PPT。
六、企业落地怎么做技术选型
有了体感之后,谈方法论。我的选型框架是「五维打分 + 三个硬约束 + 四个反模式」。
6.1 五维打分
| 维度 | 关键问题 | 权重参考 |
|---|---|---|
| 语言栈匹配 | 团队主力是 Python / Java / Go / TS?框架在哪个语言最成熟? | 最高,别高估团队的换语言意愿 |
| 部署与合规 | 能私有化吗?数据出域吗?审计留痕怎么做? | 金融政企一票否决项 |
| 可观测与评测 | 每一步 token 花在哪、错在哪一步,看得见吗? | 高——没有 trace 的 Agent 没法迭代 |
| 模型可替换性 | 换模型要改多少代码?支持 OpenAI 兼容接口吗? | 中高,模型迭代速度远快于框架 |
| 生态与集成 | 你要接的系统(IM、ERP、工单)有现成集成吗? | 中,集成可以自己写,但很费人 |
建议的做法:给候选框架各打一遍分,但打分人必须是一线写代码的人,不是架构评审会上举手的人。 抽象层好不好用,写两周就知道了。
6.2 三个硬约束(比框架更重要)
- 数据边界先于框架。 先画出「哪些数据允许进 prompt、哪些只允许出现在工具返回值里、哪些永远不进模型」,再选框架。很多企业是反过来做的,结果框架选完了发现数据治理跟不上,推倒重来。
- 成本模型先于规模。 上线前算清楚单次任务的 token 成本和人工对照成本。Agent 的成本和请求量不成正比——和轮数成正比,而轮数没有人替你盯着。
- 退出成本先于进入。 问一句「一年后想换掉它,要重写多少」:模型调用层用 OpenAI 兼容接口隔离、工具层用 MCP 隔离、编排层保持薄——这样框架就是可替换的零件,而不是地基。
6.3 四个常见反模式
- 为先进性选最难的层。 一上来就 LangGraph 画状态机,结果 80% 的节点是空转。抽象阶梯应该从最高层起步,被需求逼下来。
- 用选型替代架构设计。 「选了 LangGraph」不等于解决了状态管理、补偿、幂等这些工程问题,框架只提供机制,不提供你的设计。
- 开局就上多 Agent。 多 Agent 意味着上下文一致性代价和协调成本(Cognition 那篇《Don’t Build Multi-Agents》讲得很透),单 agent 能跑通的流程,先别拆。
- 没有评测集就上线。 哪怕只有 50 条真实问题 + 预期答案,也比「感觉回答得不错」强一百倍。评测集是 Agent 时代的单元测试。
七、如何快速落地:六周路线
选型定了之后,落地节奏比技术更影响成败。这是我实践下来最稳的六周路线:
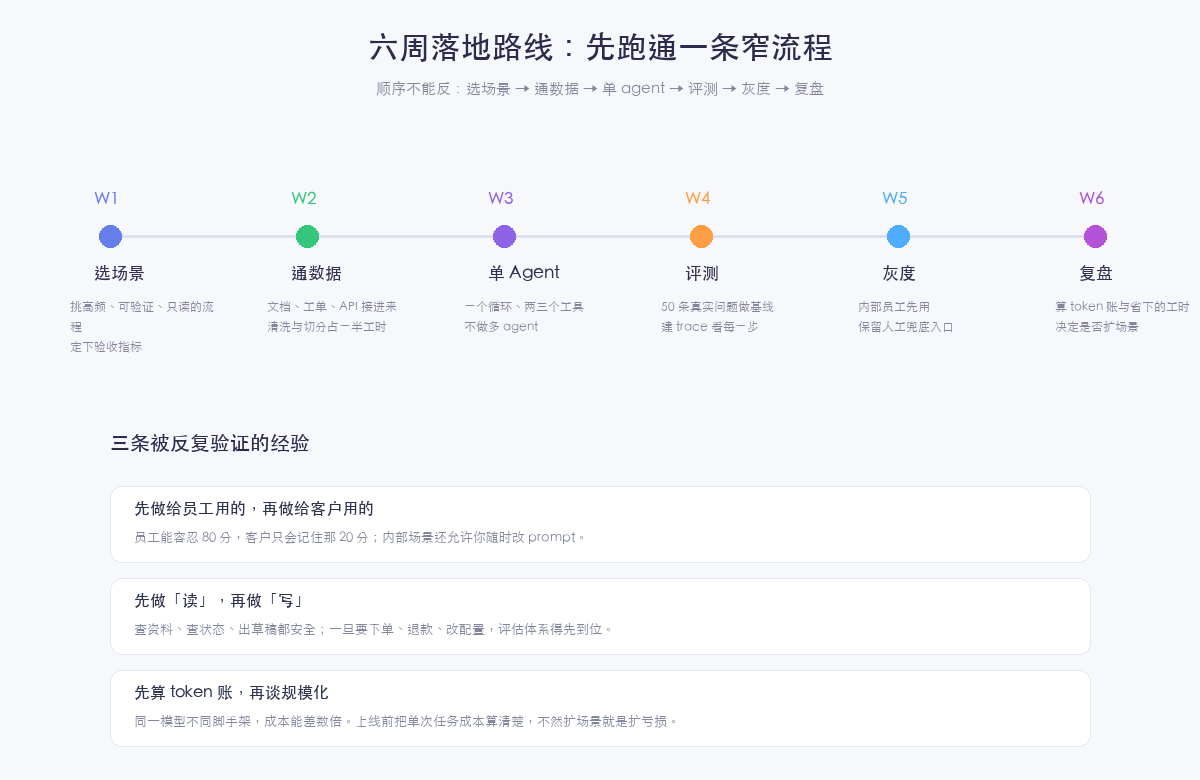
| 周次 | 主题 | 关键动作 | 交付物 |
|---|---|---|---|
| W1 | 选场景 | 按「失败代价 × 任务变异度」筛出一个只读、高频的窄流程,定验收指标 | 一句话场景 + 3 个可量化指标 |
| W2 | 通数据 | 制度文档、工单 API 接进来;清洗、切分、权限过滤 | 一个能被检索的干净数据层 |
| W3 | 单 Agent | 一个循环、两三个只读工具,参考第五节的 30 行 | 内部可演示的端到端 demo |
| W4 | 评测 | 50 条真实问题做基线;接 trace 看每一步的 token 与错误 | 评测报告 + 问题清单 |
| W5 | 灰度 | 内部一个团队先用;保留人工兜底入口 | 真实使用数据 + 修复迭代 |
| W6 | 复盘 | 算 token 账、算省下的工时,决定扩场景还是先修地基 | 扩大或调整的决策依据 |
顺序不能反,尤其是 W2:数据永远比想象中脏,占掉一半工时是常态不是意外。 三条被反复验证的经验:
- 先做给员工用的,再做给客户用的。 员工能容忍 80 分,客户只会记住那 20 分;内部场景还允许你随时改 prompt。
- 先做「读」,再做「写」。 查资料、查状态、出草稿都安全;一旦要下单、退款、改配置,评估与审批体系必须先到位。
- 先算 token 账,再谈规模化。 同一模型不同脚手架,成本能差数倍。上线前把单次任务成本算清楚,不然扩场景就是扩亏损。
八、我的几点思考
第一,框架不是护城河,对企业和对框架公司都是。 对企业:2026 年框架层的整合与重写(LangChain 1.0 推翻重来、AutoGen 并入 MAF)证明了今天的选型保质期可能只有一年。对企业真正增值的是三样东西——干净的数据、可评测的业务理解、以及那条被你验证过的流程。框架只是把这三样东西装配起来的施工机械。
第二,选型本质是在选「谁替你做上下文工程」。 这是这一系列文章落到选型上最深的体会:Deep Agents 卖的是一套默认的上下文管理最佳实践,LlamaIndex 卖的是「把脏文档变成好上下文」的管线,Dify 卖的是让非工程师也能配置上下文的界面。把框架的宣传语翻译成「它替我管住了哪些上下文问题」,选型会清晰得多。
第三,中小团队的自研冲动要警惕。 每年都有团队觉得「框架太重,不如自己写个循环」。写个 demo 级循环确实只要 100 行,但持久化、断点续跑、人在回路、流式、评测观测这些生产必需品加起来是几万行的工程。正确姿势是:用开源框架起步,把自研冲动花在工具层和评测集上——那才是复利所在。
第四,别让「选型会」取代「试验周」。 我见过的最贵的错误,是三个团队开了四周选型会、写了一份 40 页对比文档,最后选了一个谁都没跑过的框架。五维打分表加两个各跑两天的 spike,比任何文档都接近真相。
九、未来趋势
趋势一:协议收敛,框架贬值,运行时升值。 MCP 统一了工具接入,A2A 在打通跨框架协作。当工具和 Agent 都能通过协议互认,框架之间剩下 differences 的只有运行时质量(持久化、调度、观测)和默认实践的好坏。未来企业选型的重心会从「用谁的框架」滑向「跑在谁的运行时上」。
趋势二:harness 商品化。 Deep Agents、Claude Agent SDK、Microsoft Agent Framework,卖的都是同一件事:把头部 Agent 产品(Claude Code、Manus、Deep Research)验证过的线束模式打包成默认值。「造轮子」的价值区间正在从编排层转移到 harness 的默认质量上。
趋势三:评测集成为企业核心资产。 模型会换代、框架会重写,但「这个业务场景下什么算对」的标注数据只属于你自己。未来企业 Agent 团队的核心资产表里,评测集的地位会接近推荐系统时代的用户行为数据。
趋势四:Agent 进入运维期,AgentOps 成采购硬指标。 上线只是开始:token 成本漂移、工具接口变更、提示注入攻击、灰度发布、事故回放——这些会把 Agent 团队推向和微服务一样的运维成熟度要求。观测与治理能力会从「加分项」变成「投标门槛」。
趋势五:模型能力继续上移,吃掉编排层。 今天的显式工作流、任务拆解,明天可能变成模型的内建行为。框架设计的正确姿势是为拆而生——每一层都应该是可以被下一代模型替换掉的组件。这也呼应 Harness Engineering 那篇的结论:harness 的边界会随模型进步而移动,持续做减法的机制比一步到位的设计更值钱。
十、结语
回到开头的问题:「我们公司想上 Agent,该从哪儿开始?」
答案现在可以压缩成一段话:先用「失败代价 × 任务变异度」两个轴找出你的甜区;选型时记住框架只是一条栈,从最高层起步、被需求逼着下潜,Java 和 Go 团队另有正解;然后别恋战,30 行代码、两个只读工具,两周内让一个真实的窄流程先跑起来——企业 Agent 落地最大的风险从来不是选错框架,而是在选型会上把热情消耗完。
参考
- LangChain — Deep Agents vs LangChain vs LangGraph
- LangChain — The open source stack for building agents
- LangChain — The Anatomy of an Agent Harness
- LangChain — Context Engineering
- Cognition — Don’t Build Multi-Agents
- LlamaIndex — 不仅仅是一个 RAG 框架
- Microsoft Learn — Microsoft Agent Framework overview
- 系列前篇:Harness Engineering:当工程师的核心工作从写代码变成造环境
- 系列前篇:Agent 越跑越笨,问题不在模型:Context Engineering 策略解析
- B 站 —《LangChain 和 LlamaIndex 的定位差异是什么?》(BV1jhJX6hE9C,定位对比部分参考了这期视频的讲法)
 微信
 支付宝
欢迎来到李苟蛋的个人博客,对本站的文章和技术问题有疑问或建议,欢迎留言,或者关注我的公众号:狗蛋的智栈