从 namespace 到万节点调度:2026 年 Docker 与 Kubernetes 企业级落地全解
序言:为什么 2026 年还要再写一篇容器文章
容器技术诞生到今天已经十三年了。2013 年 Docker 开源,2014 年 Kubernetes 开源,到 2026 年,这两个项目都已经不再是”新技术”。
但有意思的是,会用容器的人变多了,真正理解容器的人并没有按比例增长。
我见过太多这样的团队:Dockerfile 是从网上抄的,docker run 跑起来就提交;上了 Kubernetes 之后,YAML 是 Helm Chart 生成的,扩容是照着文档配了个 HPA,然后发现节点越加越多、账单越来越贵、Pod 一重启就 OOM、升级一次集群要停服两小时。出了问题只会做三件事:重启 Pod、加节点、回滚。
这些问题的根因高度一致:把容器当成了轻量虚拟机,把 Kubernetes 当成了高级部署工具。
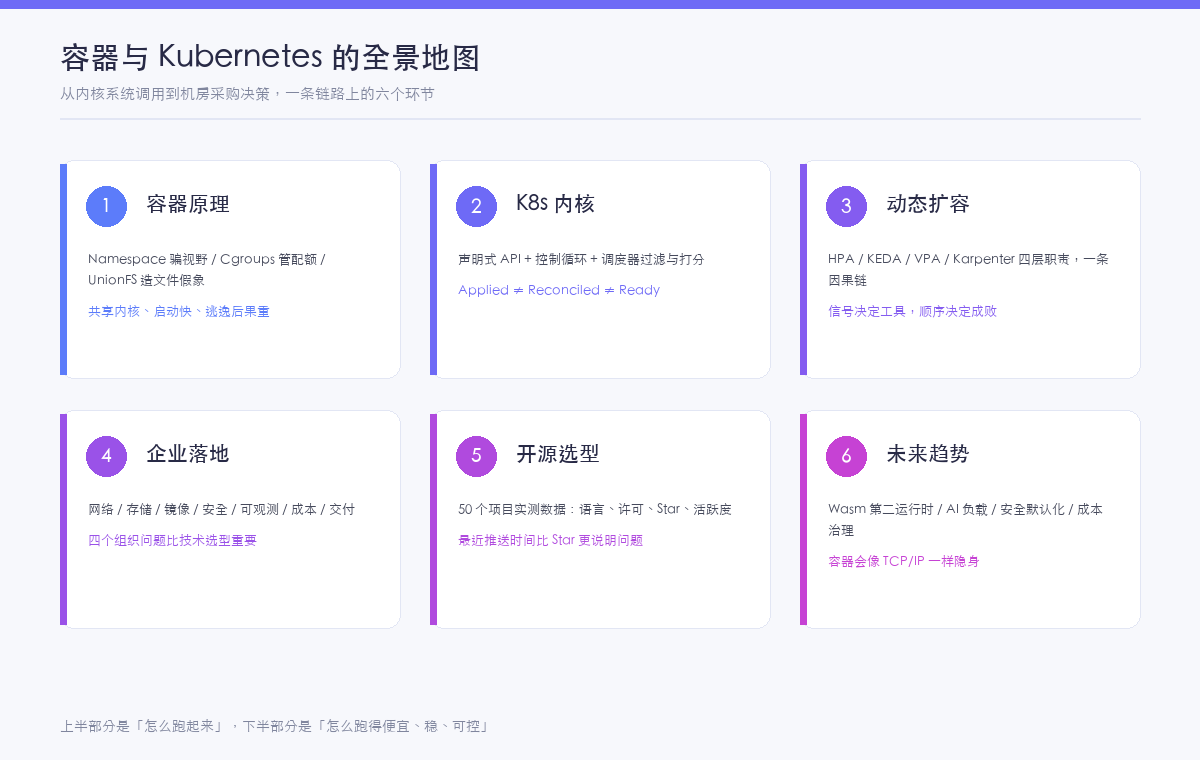
这篇文章想做的事情,是从最底层的系统调用开始,一路讲到机房里的服务器采购决策,把整条链路讲透。它不是一份速查手册,而是一份”为什么”的解释:
- 容器到底隔离了什么? 一个
docker run背后,内核执行了哪些系统调用,哪些东西被隔离了、哪些没有。 - Kubernetes 接管了什么? 声明式 API 到底在解决什么问题,代价是什么,调度器为什么是整个系统里最被低估的组件。
- 动态扩容怎么做才不翻车? HPA、VPA、KEDA、Cluster Autoscaler、Karpenter 五个工具的职责边界,以及 2026 年真实的集群利用率数据。
- 企业落地到底要建什么? 一套可以照抄的分层架构,八个必踩的坑,五阶段路线图。
- 有哪些开源项目值得二次开发? 50 个项目的真实数据,以及 9 个平台类项目的二次开发适配度与适用边界。
- 未来五年会往哪走? 六个判断,附判断依据。
先说结论,后面再解释:容器的难点从来不是”跑起来”,而是”跑得便宜、跑得稳、跑得可控”。 前一句是 Docker 解决的问题,后一句是 Kubernetes 和平台工程解决的问题,而且后者永远不会完结。
第一部分 · 容器:一个精心构造的错觉
一、容器不是虚拟机:一个被误读了十年的比喻
几乎所有讲容器的文章都用同一个比喻:**”容器是轻量级虚拟机”**。
这个比喻在教学上是有效的,但它误导了整整一代工程师。因为它是错的——而且错在最重要的地方。
虚拟机的隔离来自硬件。Hypervisor(KVM、Xen、Hyper-V)虚拟出一套完整的 CPU、内存、磁盘、网卡,Guest OS 有自己的内核,有自己独立的 init 进程,有自己独立的 /proc。当 Guest 里的进程发起系统调用时,它调用的是 Guest 自己的内核,这个内核再通过 VM Exit / VM Entry 与宿主机协调。两个虚拟机之间,是真真正正的、硬件级别的隔离。
容器没有这一层。
容器里的进程,和宿主机上的其他进程,跑在同一个内核里。容器里的 PID 1 和宿主机的 PID 1 是两个不同的编号,但它们背后的内核是同一个。容器里的 kill -9 和宿主机的 kill -9 走的是同一份内核代码。容器里看到的 /proc,是内核为了”骗”它而单独准备的一份视图,不是一份独立的存在。
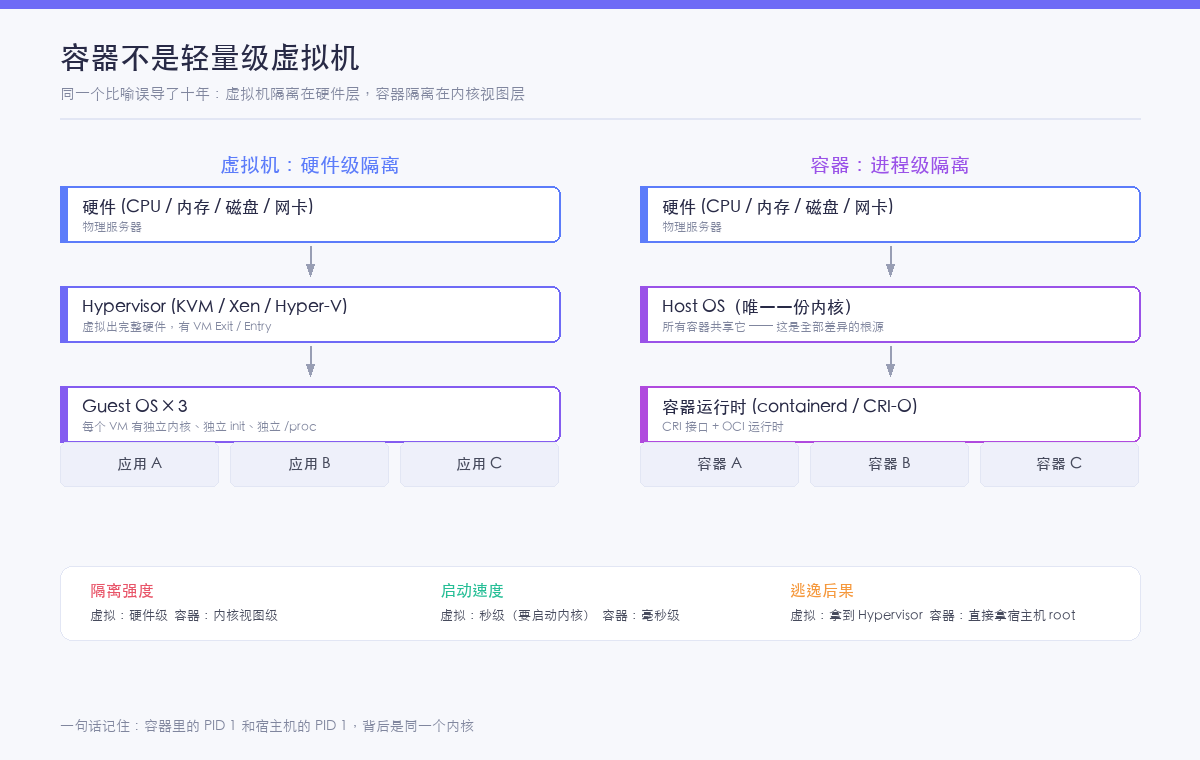
所以准确的说法是:
容器 = 一组被内核刻意限制了”视野”和”配额”的普通进程。
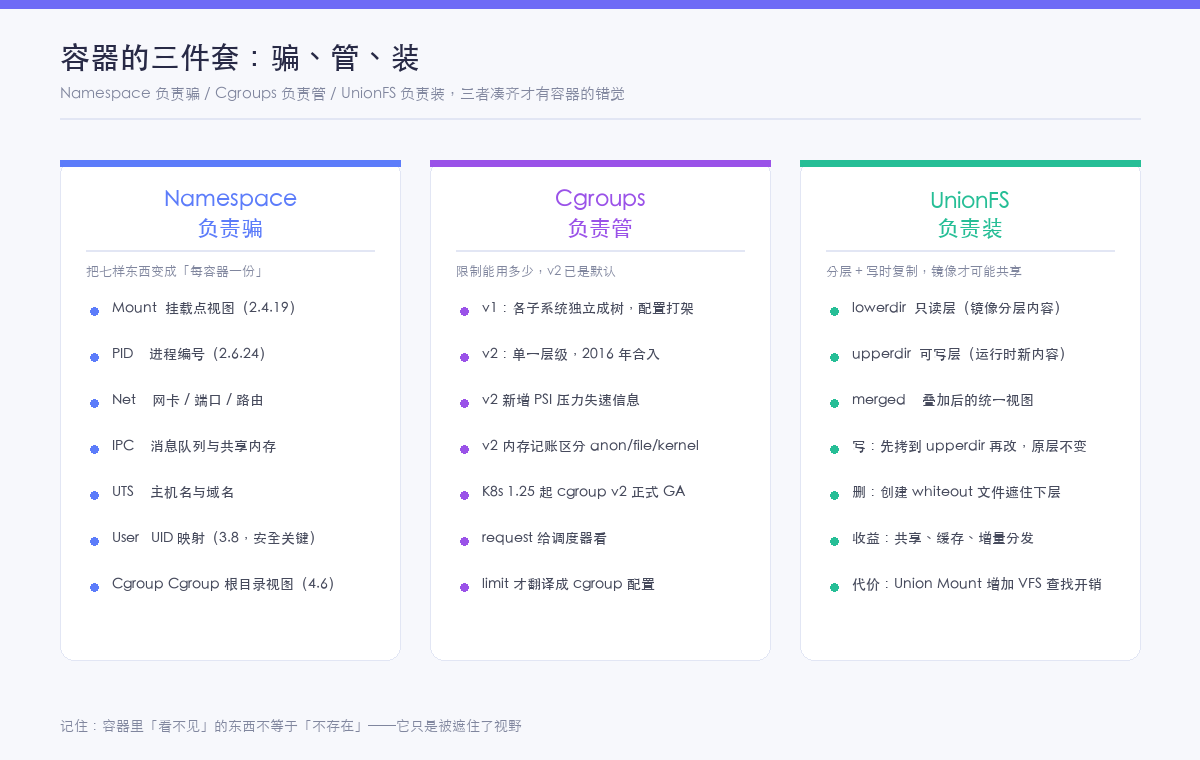
“视野”由 Namespace 限制,”配额”由 Cgroups 限制,”文件系统的假象”由 UnionFS 提供。三件事凑齐,进程就以为自己独占了一台机器——但那只是它以为。
这个区别带来三个直接后果,贯穿全文:
后果一:容器逃逸的后果比虚拟机逃逸严重得多。 虚拟机逃逸拿到的是 Hypervisor 权限,容器逃逸直接拿到宿主机 root。因为共享内核,一个内核漏洞可以打穿所有容器。这也是为什么后来会出现 gVisor、Kata Containers、Firecracker 这些”给容器补一层真隔离”的技术。
后果二:容器启动快是因为它不需要做虚拟机需要做的事。 虚拟机要启动一个内核,容器只需要 fork + exec 加上几个 unshare 调用。这就是为什么容器是毫秒级、虚拟机是秒级。
后果三:容器里”看不见”的东西不等于”不存在”。 /proc 被隔离了,但 /proc 里的信息是从同一个内核来的;kill 不了容器外的进程,是因为 PID namespace 做了映射,不是因为特权消失了。理解这一点,才能理解为什么 privileged 容器那么危险——它只是把那层”视野遮罩”摘掉了。
二、三件套:Namespace 负责骗,Cgroups 负责管,UnionFS 负责装
2.1 Namespace:把七样东西变成”每容器一份”
Namespace 是 Linux 内核从 2.4.19(2002 年的 mount namespace)开始逐步加入的机制。它的作用是把一个全局资源包装起来,让每个 namespace 里的进程觉得自己拥有一份独立的实例。
到 2026 年,一个容器通常涉及七类 namespace:
| Namespace | 隔离内容 | 容器里的表现 | 加入内核 |
|---|---|---|---|
| Mount (mnt) | 挂载点视图 | 容器有独立的 /、/proc、/sys,宿主机目录看不见 |
2.4.19 |
| PID | 进程编号 | 容器里第一个进程是 PID 1,宿主机上是另一个编号 | 2.6.24 |
| Network (net) | 网络设备、端口、路由、iptables | 容器有独立的网卡、IP、端口空间 | 2.6.29 |
| IPC | 消息队列、共享内存、信号量 | 容器之间不能直接通过 System V IPC 通信 | 2.6.19 |
| UTS | 主机名与域名 | 容器可以有自己的 hostname | 2.6.19 |
| User (user) | 用户与组 ID 映射 | 容器内 root(UID 0)映射到宿主机普通 UID | 3.8 |
| Cgroup | Cgroup 根目录视图 | 容器看到的 cgroup 树以自己为根 | 4.6 |
其中 User Namespace 是安全上最关键的一个,也是很多团队没有开启的一个。它做的事情是把容器内的 UID 0 映射到宿主机上一个没有特权的 UID。这样即使容器内的进程”是 root”,它在宿主机上也只是一个普通用户——容器逃逸拿到的权限被大幅削弱。
Kubernetes 在 v1.35(2026 年 1 月发布,代号 “Timbernetes”)把 User Namespaces 推进到 Beta 阶段,配套的还有 PodSecurityProfiles。这不是锦上添花:没有 user namespace 的容器,一旦被逃逸就是宿主机 root。
2.2 Cgroups:从”能用多少”到”能用多少 GPU”
Cgroups(Control Groups)负责限制资源使用量。它的发展分为两代:
cgroup v1(2007 年) 的问题是结构松散:每个子系统(cpu、memory、blkio、net_cls…)各自维护一棵树,配置打架是常态,比如 cpu 和 cpuacct 分家导致统计和限制对不上。
cgroup v2(2016 年合入,现在是主流发行版默认) 的改进是根本性的:
- 单一层级:所有控制器挂在同一棵树下,消除了 v1 的结构性冲突。
- 压力失速信息(PSI):能直接回答”过去 60 秒里,任务因为 CPU/内存/IO 不足被阻塞了多长时间”。这是判断”是真忙还是被限流了”的关键指标,v1 里没有对等物。
- 内存记账更准确:v1 的
memory.usage_in_bytes长期把 page cache 算进去,导致监控数据虚高;v2 区分了 anon / file / kernel 内存。 - 统一的 cgroup 命名空间接口:容器内的进程看到的 cgroup 路径以自己为根。
Kubernetes 从 1.25 起正式把 cgroup v2 作为生产可用(GA),2026 年的主流发行版(RHEL 9+、Ubuntu 22.04+、Debian 11+)默认都是 v2。如果你的集群还在 v1 上跑,至少有三个问题:内存 OOM 判断不准、没有 PSI、部分新特性(如 MemoryQoS)用不了。
关于 cgroups 有一个经常被忽略的要点:
request 是给调度器看的,limit 是给内核看的。
resources.requests不设置任何内核限制,它只是告诉调度器”给我留这么多”,用于决定 Pod 放哪。resources.limits才真正翻译成 cgroup 的配置项:cpu翻译成cpu.max(v2)或 CFS quota(v1),memory翻译成memory.max。- CPU 是可压缩资源:超了只会变慢(被 CFS 节流),不会死。
- 内存是不可压缩资源:超了直接 OOM Kill,进程消失。
这个区别决定了后面所有的资源配置策略。
2.3 UnionFS:为什么 200MB 的镜像 10 台机器只占一份空间
Union Filesystem 把多个目录叠加成一个视图。容器场景用的是 overlayfs(2014 年合入内核,现在是唯一推荐的选择)。
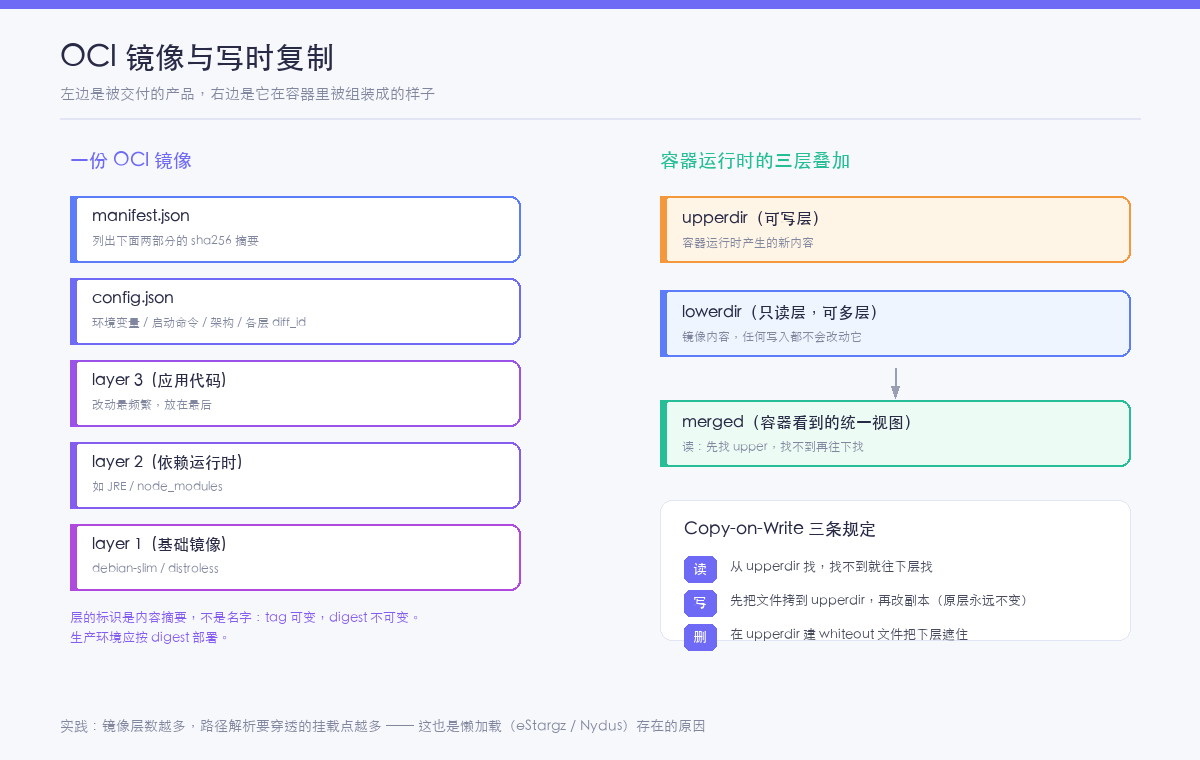
overlayfs 的三个角色:
- lowerdir:只读层,镜像的分层内容,可以有多层。
- upperdir:可写层,容器运行时产生的新内容。
- merged:两者叠加后呈现给进程的统一视图。
它遵循 Copy-on-Write(写时复制) 规则:
- 读文件时,从 upperdir 找,找不到就往下层找。
- 写文件时,先把文件从 lowerdir 拷贝到 upperdir,再在副本上修改——原始层永远不变。
- 删除文件时,在 upperdir 创建一个 whiteout 文件(特殊的字符设备)把下层文件”遮住”。
这个设计有三个直接价值:
- 镜像可以共享:10 个容器用同一个 nginx 基础镜像,磁盘上只存一份。
- 构建可以缓存:Dockerfile 里改了最后一行,前面几层的缓存全部命中。
- 分发可以增量:推拉镜像时,本地已有的层不会重复传输。
同时也有代价:Union Mount 会增加 VFS 查找开销。层数越多,一次路径解析要穿透的挂载点越多。这就是为什么现代最佳实践要求”减少层数”以及为什么会有 eStargz / Nydus 这类懒加载(lazy pulling)技术——既然全量拉取慢,那就只在实际访问某个文件时才去拉它,把启动时间从分钟级压到秒级。
三、手搓一个容器:150 行命令看穿本质
讲完理论,我们可以直接用命令验证。下面这段操作在一台 Linux 机器上就能执行,它做的事情和 docker run 内核路径上做的是同一件事。
1 | # 1. 准备一个最小 rootfs(用 busybox 就够) |
把它翻译成内核视角,就是七行操作:
1 | 1. clone(CLONE_NEWUTS | CLONE_NEWPID | CLONE_NEWNS | CLONE_NEWNET | CLONE_NEWIPC) |
第 3 步用的通常是 pivot_root 而不是 chroot。区别在于:chroot 只是改变进程的根目录,旧的 root 仍然可以通过某些方式访问;pivot_root 把整个挂载命名空间里的根换掉,更加彻底。
容器缺的那部分:安全
上面的操作可以让进程被隔离,但还没有被限制”能做什么”。真实容器还需要三道防线:
- Capabilities:Linux 把 root 的特权拆成了 40 个左右的能力(CAP_SYS_ADMIN、CAP_NET_RAW、CAP_CHOWN…)。容器默认只保留 14 个,最危险的
CAP_SYS_ADMIN(几乎等于 root)被去掉。 - Seccomp:过滤系统调用。默认 profile 会拦截 300 多个高危调用,比如
kexec_load、reboot、bpf。 - MAC(强制访问控制):SELinux 或 AppArmor,在内核层面再套一层策略。
容器安全的第一原则是:最小特权。 一个 Web 服务不需要 CAP_SYS_ADMIN,不需要写 /proc,不需要加载内核模块。但现实里大量生产容器是 privileged: true——那等于把上面三道防线全部关掉。
四、镜像:容器真正被交付出去的形态
容器是运行时的概念,镜像才是被交付的产品。而镜像之所以能在 Docker、containerd、Podman、CRI-O 之间自由流动,是因为有一套标准:OCI(Open Container Initiative)规范。
OCI 有两个核心规范:
- image-spec:镜像长什么样。
- runtime-spec:容器怎么被启动(
config.json+rootfs)。
4.1 一份 OCI 镜像由三部分组成
1 | my-app:v1.2.0 |
关键设计:层的标识是内容摘要(sha256),不是名字。这带来几个连锁结果:
- 内容相同的层在仓库里只存一份。
- 镜像可以被签名验证——你验的是内容的哈希,不是标签。
- 标签(tag)是可变的,
latest只是一个指针。摘要(digest)才是不可变的引用:my-app@sha256:abc123...。
生产环境的最佳实践是按 digest 部署,因为 tag 可以被覆盖,digest 不能。这在 Kubernetes 上尤其重要——同一个 tag 在不同节点上可能解析出不同的镜像。
4.2 Registry 是同一套 API
OCI 还有第三个规范:distribution-spec,定义了镜像仓库的 HTTP API。这就是为什么 ECR、GCR、ACR、Harbor、Quay、Docker Hub 虽然是不同的产品,客户端却可以通用。
这个规范的直接收益是你可以自建仓库而不被锁定。企业内部通常需要一个 Harbor(★29.5k,Go,Apache-2.0),原因有三:
- 拉取不限速:Docker Hub 从 2024 年起对匿名和免费账号实施小时级拉取限流,CI 机器上”莫名其妙构建失败”的常见元凶就是这个。
- 可以做复制与灾备:Harbor 支持多实例之间的镜像复制规则。
- 可以卡安全门禁:Harbor 与 Trivy 集成,可以直接把含高危 CVE 的镜像标记为”禁止拉取”。
4.3 镜像瘦身:从 1.2GB 到 40MB
镜像大小不是审美问题,是工程问题。它直接影响:拉取耗时(冷启动)、节点磁盘占用、CVE 数量、攻击面。
三个手段,按效果排序:
手段一:多阶段构建。 编译环境和运行环境分离。
1 | # ---------- 构建阶段 ---------- |
典型 Go 服务:golang 构建镜像约 800MB(含 SDK),distroless 运行镜像约 2MB + 二进制 20MB,总量从 800MB 降到 25MB 左右。
手段二:使用 distroless / hardened 基础镜像。
distroless 的思路是”容器里不需要 shell”。没有 /bin/sh,就没有包管理器,就没有 curl、wget——攻击者在容器里能做的事被极大压缩。缺点也明显:调试时没法 kubectl exec 进去 sh。
手段三:2026 年的新选项——Docker Hardened Images(DHI)。
Docker 在 2025 年把这套镜像作为完全开源、Apache-2.0 许可的产品推出,2026 年已有 1000+ 个镜像。它的三个卖点值得注意:
- 近乎零 CVE:持续重建,附带完整 SBOM 和 SLSA Level 3 来源证明。
- 极小体积:distroless 变体,宣称攻击面缩减最多 97%。
- Drop-in 采用:不需要改 Dockerfile 工作流。
对有明显合规要求的团队(金融、政务),这类”自带 SBOM 与来源证明”的基础镜像正在从加分项变成必选项——因为软件供应链审查会直接问”这个镜像的来源证明在哪”。
4.4 镜像构建:不止 Docker build
2026 年构建一个 OCI 镜像至少有六条路径,选哪条取决于你的环境约束:
| 工具 | 语言/形态 | 需要特权? | 适合场景 |
|---|---|---|---|
| BuildKit | Go,docker buildx 后端 |
需要 dockerd 或 rootless | 标准首选,支持并发构建、缓存导出、多架构 |
| Buildah | Go,Red Hat 系 | 无守护进程 | 在 CI 容器里构建(不需 dockerd) |
| Kaniko | Go,Google 开源 | 无需特权 | K8s 内构建;注意:仓库最后推送 2025-06,已明显放缓 |
| ko | Go | 无 | 纯 Go 项目,直接推镜像,无需 Dockerfile |
| Jib | Java | 无 | Java 项目,Maven/Gradle 插件直接构建 |
| Cloud Native Buildpacks | 规范 | 无 | 无需 Dockerfile 的”代码进、镜像出”,国产 PaaS 常用 |
选型上有一条简单规则:有 dockerd 就用 BuildKit,没有就 Buildah 或 Buildpacks,纯 Go/Java 项目可以试 ko/Jib 省掉 Dockerfile。 Kaniko 虽然是”在 K8s 里构建”的经典答案,但项目活跃度在 2025 年中之后明显下降,新项目不建议再依赖它。
五、运行时的五层栈:为什么 Docker 被架空了
讲完镜像,往下走一层。
5.1 2026 年的容器技术栈分五层
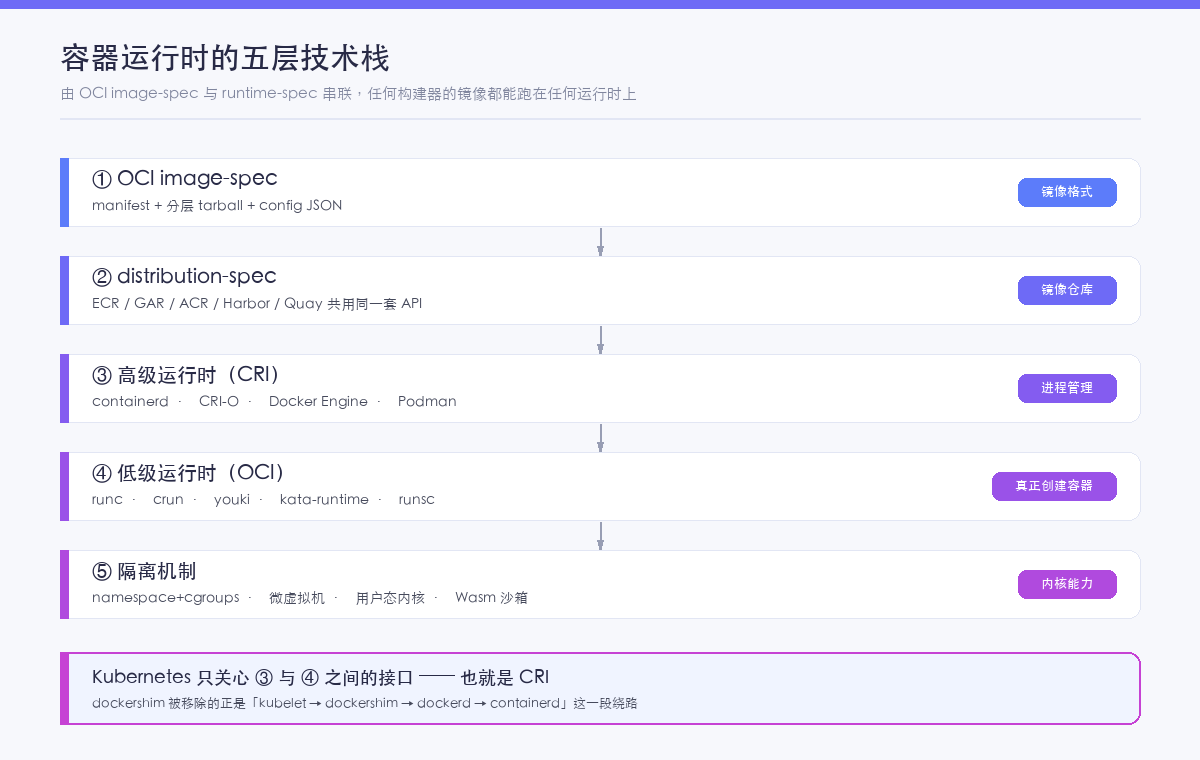
1 | ① OCI image-spec 镜像格式:manifest + 分层 tarball + config JSON |
这五层由两个标准串联:OCI image-spec 和 OCI runtime-spec。任何构建器产出的镜像应该能跑在任何运行时上——到 2026 年,这个承诺基本没有破过。
这五层是关键判断依据:你在哪一层工作,就决定了你该关心什么。
- 应用开发者主要接触 ①②。
- 平台工程师主要接触 ③④。
- 内核与安全工程师主要接触 ④⑤。
- Kubernetes 只关心 ③ 和 ④ 之间的接口,也就是 CRI。
5.2 dockershim 事件:K8s 弃用的到底是什么
这是容器史上最大的一次误会,值得单独讲清楚。
2020 年,Kubernetes 1.20 宣布弃用 Docker 作为容器运行时。当时社区一片”Docker 要完了”的声音。到 2022 年,Kubernetes 1.24 正式移除 dockershim 组件。
但被移除的那个东西,从来不是 Docker 镜像,也不是 Dockerfile。
被移除的是这条链路:
1 | 之前:kubelet → dockershim → dockerd → containerd → runc → 容器 |
dockershim 是 kubelet 里的一段适配代码,作用是让 kubelet 能通过 Docker 的 API 去操作容器。问题在于:containerd 本来就是从 Docker Engine 里剥离出来的,Docker Engine 自己就在用 containerd。 那 kubelet 为什么不直接跟 containerd 说话,非要绕一圈?
答案很简单:CRI 标准 2016 年才发布,而 containerd 当时还不属于 Docker 之外的一等公民。dockershim 是历史包袱。移除它,只是把这条绕路拆了。
所以精确的结论是:
Kubernetes 弃用的是 Docker Engine 这个”高级运行时 + 守护进程 + CLI + 镜像仓库入口”的整套商业产品组合,不是 Dockerfile、不是 OCI 镜像、也不是容器本身。
这带来一个深刻的悖论:
Docker 最大的遗产不是 Docker Engine,而是 Dockerfile 和 OCI 镜像格式。而正是这个标准,最终让 Docker Engine 本身变得可替代。
5.3 2026 年的运行时分布
到 2026 年,这条链路的实际情况是:
- containerd 是 Kubernetes 集群的事实标准 CRI。EKS、GKE、AKS、kubeadm 默认都是它。
- CRI-O 是 Red Hat 主导的、只服务 Kubernetes 的精简 CRI,OpenShift 默认用它,节点占用比 containerd 更小。
- Docker Engine 仍在开发环境占统治地位,但越来越依赖 Docker Desktop 这个产品。
说 containerd 是”沉默的赢家”并不夸张。它的设计哲学就是”不追求开发者体验,不做桌面端,不搞商业化,只做一件事:稳定地跑容器”。代价是它的命令行 ctr 体验极差,所以社区有了 nerdctl——一个与 docker 命令几乎完全兼容的 containerd CLI。
containerd 2.x 是一次必须了解的升级:
- 2.0 于 2024-11-05 发布(LTS),2.1(2025-05)、2.2(2025-11)、2.3 于 2026-04-30 发布并支持到 2028-04-30。
- 1.7 系列已于 2026-09-30 停止支持。
- 2.0 移除了 AUFS snapshotter(转 overlayfs)、移除 CRI v1alpha2、拒绝 Docker Schema 1 镜像。
- 2.x 原生支持 NRI(Node Resource Interface),并把 Sandbox API 稳定化。
其中最后一条最需要提前准备:Schema 1 镜像在 2.x 上会拉取失败。而这个问题的阴险之处在于——它只在新节点第一次拉取某个老镜像时才暴露。你升级完节点以为没事,一周后某个节点重建,才发现某个三年前的镜像拉不下来了。
升级前必做的检查:
1 | # 列出集群里所有节点的运行时版本 |
5.4 低级运行时:三个实现,一个接口
最底层真正创建容器的是 OCI runtime,它读一个 config.json 和一份 rootfs,把容器跑起来。三个主流实现:
| 运行时 | 语言 | 特点 | 备注 |
|---|---|---|---|
| runc | Go | OCI 规范的参考实现,事实标准 | ★13.5k,2015 年至今 |
| crun | C | 启动更快、内存更低 | ★4.2k,Podman 与 CRI-O 默认 |
| youki | Rust | Rust 重写,内存安全 | ★7.6k,2021 年起,被若干沙箱项目采用 |
三者实现同一份规范,所以在 containerd 配置里可以直接互换:
1 | # /etc/containerd/config.toml 片段 |
5.5 隔离的选择:runc 不够用时怎么办
runc 提供的是进程级隔离(namespace + cgroups)。对可信的内部代码,这足够了。但有三类场景不够:
- 多租户:不同客户的不可信代码跑在同一节点。
- 合规要求:金融等监管场景要求硬件级隔离。
- CI 流水线:在集群里执行用户提交的任意构建脚本。
2026 年的四个选项,按隔离强度与启动时间的权衡:
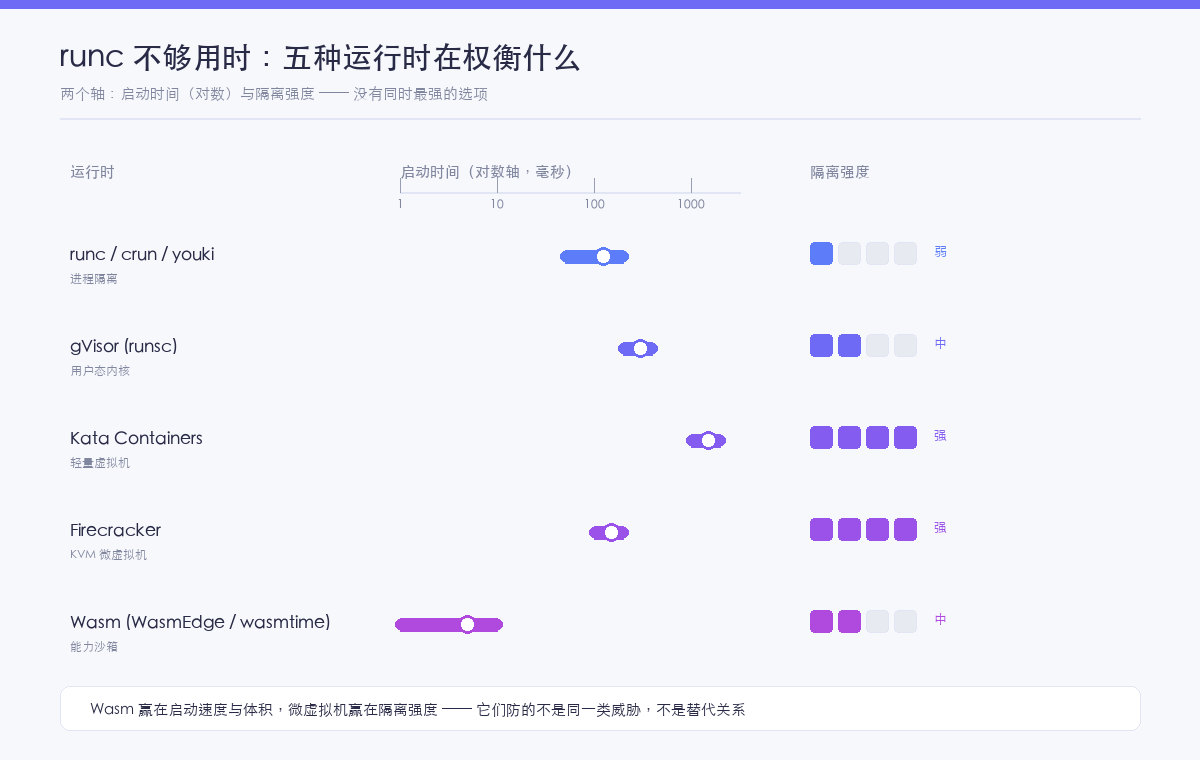
| 运行时 | 隔离机制 | 启动时间 | 适用场景 |
|---|---|---|---|
| runc / crun / youki | 进程隔离 | 50–200ms | 可信代码,绝大多数 K8s 工作负载 |
| gVisor (runsc) | 用户态内核 | 200–400ms | 不可信用户代码、CI Runner |
| Kata Containers | 轻量虚拟机 | 1–2s | 多租户、强合规 |
| Firecracker | KVM 微虚拟机 | 100–200ms | Serverless、短生命周期 |
| Wasm (WasmEdge/wasmtime) | 沙箱 + 能力模型 | 1–10ms | 边缘、插件、AI 推理 |
一个必须讲清楚的误区:Wasm 的隔离强度和微虚拟机不是同一类东西。 Wasm 是基于能力(capability)的沙箱,默认没有文件系统和网络访问,语言层面就禁止了越权——它防的是”恶意代码想读你的文件”。但 Wasm 防不住容器的内核逃逸路径,因为它和 runc 一样共享宿主内核。微虚拟机提供的是硬件级隔离,能防内核 CVE。
所以正确说法是:Wasm 赢在启动速度和体积,微虚拟机赢在隔离强度。 它们不是替代关系。
gVisor(★19.7k,Go,Apache-2.0)是一个有意思的中间方案:它不虚拟硬件,而是用 Go 重新实现了一份 Linux 内核系统调用接口(”用户态内核”)。容器里的进程发起系统调用时,被 gVisor 拦截并自己处理,只有少量必要调用才转发给真实内核。这样即使容器内的代码想攻击内核,它面对的其实是 gVisor 这个 Go 程序。代价是系统调用开销增加,IO 密集型负载性能损失明显。
Kata Containers(★9.0k,Rust + Go)则是”每个 Pod 一个轻量虚拟机”:外面看起来是容器,里面跑的是裁剪过的 VM。启动 1–2 秒,代价换来的是真正的硬件隔离。它同时支持 QEMU、Firecracker 和 Cloud Hypervisor 作为后端 VMM。
5.6 那 Docker 现在是什么
回到开篇的问题。2026 年的 Docker 公司:
- Docker Engine 29 是当前主版本(29.7.1,2026 年 7 月),新装默认启用 containerd 镜像存储。开源、Apache-2.0、免费。
- Docker Desktop 是按人收费的订阅产品:Personal $0、Pro $9–11/人/月、Team $15–16/人/月、Business $24/人/月。**免费门槛是”少于 250 名员工且年收入低于 1000 万美元”**——超过就需要付费,政府实体无论规模都需要付费。
- Docker Hardened Images 免费开源(Apache-2.0),Select 与 Enterprise 是付费订阅。
- 新增了 Docker Model Runner(本地跑大模型,OpenAI 兼容接口)和 MCP Catalog/Toolkit(把 MCP 服务器容器化运行)。
这个产品组合传达的信号很清楚:Docker 公司正在从”容器引擎公司”转型为”开发者体验 + AI 工具 + 供应链安全公司”。
容器引擎本身已经完全 commoditized(商品化)了——它是开源免费的,你在服务器上装 Docker Engine 不需要付一分钱,即使商业用途。真正收费的是”开发者桌面体验”和”企业级供应链服务”。
对工程师的实操结论:
- 生产集群:用 containerd(或 CRI-O),不要装 dockerd。
- 开发机上:Docker Desktop 在 250 人 / 1000 万美元门槛内免费,超过就考虑 OrbStack(macOS 上更轻)、Colima(免费 CLI)、Rancher Desktop(自带本地 K8s)或 Podman Desktop(无守护进程、默认 rootless)。
- 容器内构建:不需要 dockerd,用 Buildah / Buildpacks。
第二部分 · Kubernetes:接管了什么,代价是什么
六、声明式 API:K8s 最重要的一个设计,和最贵的一个代价
有些团队上了 K8s 之后觉得”也就那样,跟之前的发布脚本差不多”。这通常意味着他们把 K8s 当成了一个命令式工具在用——写好 YAML,kubectl apply,完事。
Kubernetes 真正的核心是一个哲学:
你告诉系统”我要什么状态”,系统负责让它变成那样,并且一直保持那样。
这个过程叫 reconcile(调和),实现它的循环叫 控制循环(control loop):
1 | for { |
这个循环在 K8s 里到处都是,每一个 Controller 都在跑它:
- Deployment Controller 发现”应该有 3 个副本,现在只有 2 个” → 创建 1 个 ReplicaSet 的 Pod。
- ReplicaSet Controller 发现”应该有 3 个 Pod,现在有 4 个” → 删掉 1 个。
- EndpointSlice Controller 发现”有个新 Pod 就绪了” → 把它的 IP 加进 Service 后端。
- Kubelet 发现”这个节点上应该跑这个 Pod,但容器不在” → 启动容器。
6.1 声明式的收益
收益一:系统自我修复。 节点宕机,Pod 消失,控制器会在别的节点上重建它。不需要人介入,也不需要监控系统先发现再触发脚本。
收益二:幂等。 kubectl apply 同一个文件一百次,结果是一样的。这让自动化变得安全——CI 系统可以随便重跑。
收益三:状态可描述、可版本化。 整个系统的期望状态可以用文本(YAML)描述,放进 Git 管理,做 code review、做 diff、做回滚。这是 GitOps 能成立的根本前提,后面会再讲。
6.2 声明式的代价
代价也很实在,而且经常被低估。
代价一:心智负担。
写一个 docker run 就能跑的容器,在 K8s 里要写 Deployment + Service + Ingress + ConfigMap + Secret + HPA + PDB + NetworkPolicy,八份 YAML。这八份 YAML 还分散在不同目录,彼此之间有隐含依赖。
这就是为什么后来出现了 Kustomize、Helm、KubeVela、以及”平台工程”这个专门的职业方向。
代价二:最终一致性带来的”不确定感”。kubectl apply 返回成功,只代表”期望状态被写进了 etcd”。不代表 Pod 起来了,更不代表服务可用。从业者必须区分三个概念:
- Applied:API Server 接受了你的声明。
- Reconciled:控制器已经把实际状态调成期望状态。
- Ready:Pod 通过了就绪探针,真的可以接流量。
生产事故里有一大类,就是脚本把 kubectl apply 的成功当成了”发布完成”。
代价三:控制器打架。
这是最隐蔽的一个。多个控制器都想控制同一个字段时,它们会无限互相覆盖。
经典例子:你给 Deployment 的 replicas 写了 3,同时配了 HPA。HPA 把 replicas 改成 10,你下次 apply 又改回 3,HPA 再改成 10……两个控制器在拉锯。
到了 GitOps 时代这个问题更明显:Argo CD 的自愈(self-heal)会把你手动 kubectl edit 的改动回滚掉,也会把 HPA 动态算出来的副本数”当成漂移”改回 Git 里的静态值。解决办法是显式声明字段归属:
1 | # Argo CD Application 的 ignoreDifferences:告诉它哪些字段不是我管的 |
经验法则:一个字段只能有一个主人。 任何”两个组件都在改它”的配置,迟早会在半夜变成事故。
七、一个 Pod 的诞生:从 kubectl apply 到容器对外服务
理解了控制循环,我们就能完整走一遍 K8s 的执行链路。这条链路在排查问题时极其有用——“Pod 起不来”这个现象,可能卡在下面任何一步。
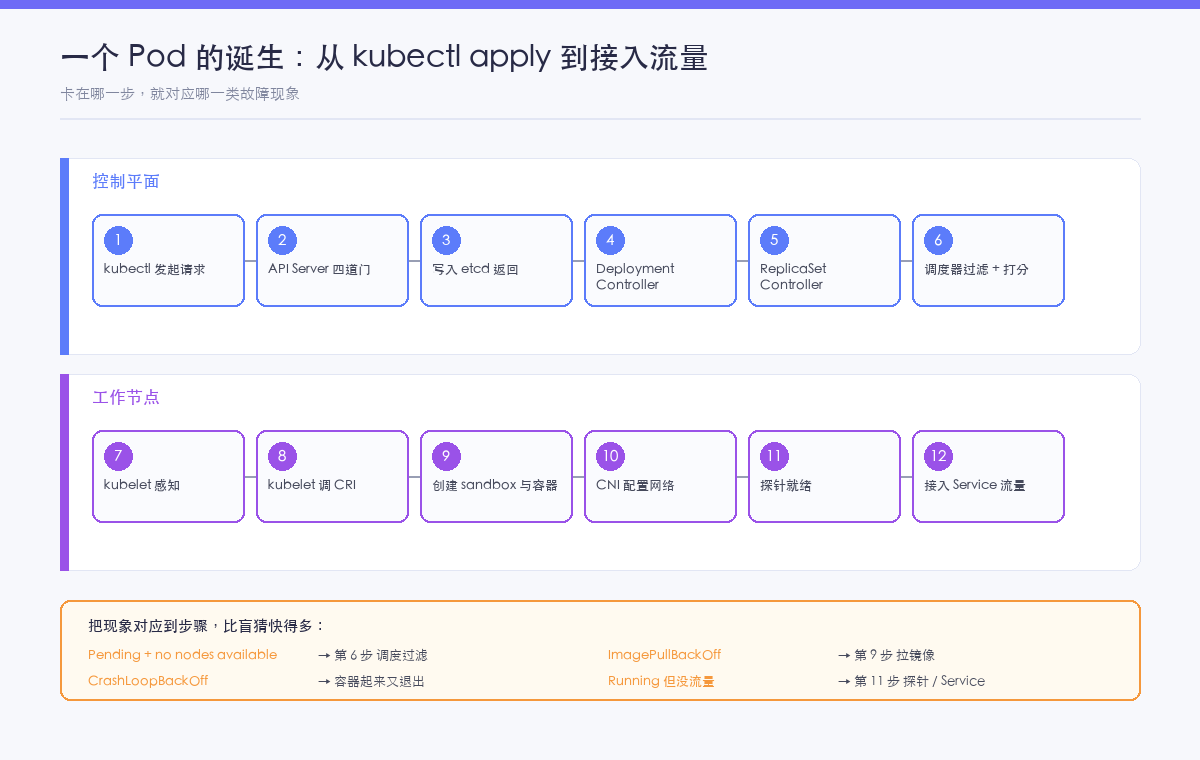
kubectl 发起请求:
kubectl apply把 YAML 序列化,通过 HTTPS 发给 API Server。客户端先做认证(证书 / token / OIDC),请求体是 JSON(YAML 在客户端侧转换成 JSON)。API Server 的四道门:请求依次经过
- 认证(Authentication):你是谁?
- 鉴权(Authorization):你能做这件事吗?(RBAC)
- 准入控制(Admission):请求内容合法吗?这里分 Mutating(改请求)和 Validating(只判断)两类。Webhook 形式的准入控制器就挂在这一层——Kyverno、OPA Gatekeeper、sidecar 注入器都在这里工作。
- 持久化:通过校验后写入 etcd。
etcd 写入成功 → API Server 返回 201。注意:到这里,
kubectl apply就返回了,但一个容器都还没创建。Controller Manager 接手:Deployment Controller 通过 Watch 机制感知到新的 Deployment 对象,创建对应的 ReplicaSet。
ReplicaSet Controller 感知到 ReplicaSet,按
replicas创建 Pod 对象(此时 Pod 只是 etcd 里的一条记录,spec.nodeName为空)。Scheduler 介入:
- 过滤(Filtering):跑一遍所有节点的谓词——资源够不够?节点有 taint 吗?节点选择器匹配吗?亲和性规则满足吗?端口冲突吗?卷能挂载吗?过滤掉所有不满足的节点,剩下的叫”可行节点集”。
- 打分(Scoring):给每个可行节点打分。默认策略里包含
LeastAllocated(倾向资源最闲的节点)、BalancedAllocation(CPU 和内存使用要均衡)、ImageLocality(镜像已在本节点缓存的加分)等。 - 选出最高分节点,把
spec.nodeName写进 Pod 对象。这一步叫”绑定(Binding)”,是整个调度器唯一真正写 API 的动作。
Kubelet 感知:目标节点上的 kubelet 一直在 Watch API Server,发现有一个 Pod 被调度到自己身上,开始执行。
Kubelet 调 CRI:kubelet 通过 gRPC 调用本节点的 CRI 接口。在 containerd 的架构下,请求进到 containerd 的 CRI 插件。
容器创建:
- 如果镜像不在本地,先拉取(走 snapshotter 解包到 overlayfs)。
- 创建 sandbox(pause 容器),它持有 network namespace,为整个 Pod 提供网络栈。
- 创建业务容器,注入资源限制(cgroup)、seccomp、capabilities。
- 挂载卷、注入 ConfigMap/Secret。
CNI 插件配置网络:容器运行时调用 CNI 插件(Calico / Cilium / Flannel 等),插件创建 veth pair、分配 IP、下发路由与网络策略。
探针与就绪:kubelet 执行
startupProbe→readinessProbe→livenessProbe。就绪探针通过后,kube-proxy / CNI 把这个 Pod 的 IP 加入 Service 的 EndpointSlice,流量开始进来。
这条链路意味着:**”Pod 起不来”需要逐段排查。** 快速定位口诀:
| 现象 | 卡在哪 |
|---|---|
Pending,事件里显示 no nodes available |
调度器过滤阶段(资源不足 / taint / 亲和性) |
Pending,事件里显示 FailedScheduling + 卷相关 |
存储卷无法创建 |
ContainerCreating 长时间不动 |
镜像拉取失败(网络/registry/限流/tag 不存在) |
ImagePullBackOff |
同上,且已重试多次 |
CrashLoopBackOff |
容器起来了又退出(配置错误 / 依赖不可用 / 探针太严) |
Running 但没流量 |
就绪探针没过,或 Service selector 不匹配 |
一条必须记住的诊断命令:
1 | kubectl describe pod <pod-name> # 看 Events,90% 的问题答案在这里 |
八、调度器:Kubernetes 里最被低估的组件
大多数人对调度器的认知停留在”它决定 Pod 放哪个节点”。这没错,但严重低估了它的作用。
8.1 默认调度策略的隐藏倾向
K8s 默认的 NodeResourcesFit 打分策略用的是 **LeastAllocated**:倾向于把 Pod 放到最闲的节点上。
这个默认值的出发点是好的:打散负载,避免噪声邻居问题,某个节点挂了影响面小。公有云厂商喜欢这个默认值,因为它能减少客户投诉。
但它有一个副作用,而且是严重的副作用:
LeastAllocated会”按设计”制造出低利用率集群。
因为每个新 Pod 都被放到最空的节点,结果是所有节点都”一点点忙”,没有节点是满的——每台机器都在为一点点负载付出整台的固定成本。在弹性云上,这表现为账单上涨;在自建机房,这表现为你买了 12 核算力只用 1 核,而且退不回去。
改法很小,只需要给调度器挂载一份配置:
1 | apiVersion: kubescheduler.config.k8s.io/v1 |
MostAllocated 的策略是”先填满一个节点,再开下一个”。配合节点自动伸缩,空节点就可以被回收掉。
但两个策略都不能极端化。 目标应该是一个区间,而不是一个分数:
- **低于 50%**:你在为空闲的机器付费。
- **50%–70%**:健康区间。
- **高于 70%**:你在吃掉故障冗余。
上限 70% 不是保守,是 N+1 冗余的必然结果:三节点集群里死掉一个,剩下两个必须能吃下它的负载,这在数学上就把稳态装箱率压到了 66% 附近。
8.2 调度器能表达的约束
生产集群里,真正让调度变得复杂的是这些约束:
拓扑分布(Topology Spread):让副本分散在不同可用区、不同节点。
1 | spec: |
这里有个坑:whenUnsatisfiable: DoNotSchedule 会让 Pod 永久 Pending。生产上如果想要”尽量分散但不阻塞”,用 ScheduleAnyway。
PodDisruptionBudget:保证自愿驱逐时至少存活多少副本。
1 | apiVersion: policy/v1 |
注意 PDB 的双面性:它保护你不被驱逐搞挂,同时也会永久阻止节点缩容。单副本 Deployment 上配 minAvailable: 1,意味着这个 Pod 所在的节点永远不能被腾空,缩容永远做不了,机器永远在计费。这是生产集群里最典型的”隐形成本泄漏”,后面还会再提。
亲和性与反亲和:
1 | affinity: |
规则很简单:能软则软。 硬约束是 Pod Pending 的头号来源,而”因为硬约束不满足所以没调度上”这类问题,往往在流量高峰时才暴露。
8.3 2026 年调度器新增的三件重要的事
Kubernetes v1.35(”Timbernetes”,2025 年 12 月发布)是一个把 AI/ML 负载当作一等公民对待的版本。对普通企业也有直接影响的有三条:
① In-place Pod Resize 转正(Stable)。
以前改 Pod 的 CPU/内存配置必须重启容器。现在可以在不重启的情况下调整。这对长生命周期负载(Java 服务、有状态的推理服务)价值很大——调资源不再是 disruptive 操作。
1 | # 直接 patch 正在运行的 Pod 的 resources |
② Workload API 与 Gang Scheduling(Alpha)。
K8s 原生第一次提供了”一组 Pod 要么全调度上,要么一个都不调度”的语义。此前这要靠 Volcano、Kueue 等第三方调度器模拟。对分布式训练和紧耦合批处理是实质改进,让”部分调度导致的资源浪费和任务卡死”有了原生解法。
③ Dynamic Resource Allocation(DRA)锁定为默认开启。
DRA 是设备(GPU、FPGA、网卡等)资源管理的新框架,取代了传统的 device plugin 模型。v1.34 的 DRA Core 已 GA,v1.35 把特性开关直接锁死、不能再禁用。可分区设备(partitionable devices) 这个 Alpha 特性尤其值得关注——它意味着单张物理 GPU 可以被切成多份、跑多个隔离的负载,这对 GPU 成本敏感的企业是直接利好。
此外还有几条 2026 年必须知道的生态变化:
- KYAML 成为 kubectl 默认输出格式:一个更严格的 YAML 子集,减少缩进和类型歧义导致的配置事故。可以用
KUBECTL_KYAML=false关闭。 - Ingress NGINX 退役:2026 年 3 月后停止维护,不再有任何更新和安全修复。所有还在用
kind: Ingress+ nginx-ingress 的团队都必须迁到 Gateway API。 这是 2026 年最重要的一个运维规划项。 - ImageVolume 默认启用:可以把 OCI 镜像作为只读卷挂载进 Pod(需要 containerd ≥ 2.1)。这意味着”用镜像分发大模型权重、AI 模型、静态资源”成了原生能力,不必再走 initContainer 拷贝。
九、工作负载选型:五个 Controller 的分工
K8s 提供了几种内置 Controller,选错类型会造成长期痛苦。判断依据是三个问题:实例之间有没有区别?是否需要固定在特定节点?是否跑完就结束?
| 控制器 | 实例有状态/有差异 | 每节点一份 | 跑完就退出 | 典型用途 |
|---|---|---|---|---|
| Deployment | 否 | 否 | 否 | Web 服务、API、无状态消费者 |
| StatefulSet | 是 | 否 | 否 | 数据库、消息队列、有固定身份的集群 |
| DaemonSet | 否 | 是 | 否 | 日志采集、节点监控、CNI 插件 |
| Job | 否 | 否 | 是 | 批处理、数据迁移、一次性任务 |
| CronJob | 否 | 否 | 是 | 定时备份、定时报表 |
关于 StatefulSet 的三件事,很多人只知其一:
1. 稳定的网络标识。 Pod 名字是 <statefulset>-0/1/2,配套的 Headless Service 提供稳定的 DNS 记录 pod-0.svc.namespace.svc.cluster.local。
2. 有序的滚动更新。 默认是逆序(从最大编号开始)逐个更新,且必须前一个 Ready 才更新下一个。可以用 podManagementPolicy: Parallel 改成并行。
3. 稳定的存储。 通过 volumeClaimTemplates,每个 Pod 获得独立的 PVC。注意 PVC 不会随 Pod 删除而消失——StatefulSet 缩容从 3 到 1,PVC 仍然存在,卷仍在计费。这是另一大隐形成本来源。
该不该在 K8s 上跑数据库?这个问题没有标准答案,但有判断依据:
1 | 问自己三个问题: |
2026 年的现实是:大部分企业把有状态服务留在了 K8s 外(云托管 RDS/Redis),K8s 只负责无状态应用层。 这不是技术保守,而是成本最优化——自己运维一套高可用 MySQL 集群的人力成本,通常高于直接买托管服务。
真正需要在 K8s 内跑有状态时,建议用 Operator 而不是自己写 StatefulSet。KubeBlocks(★3.1k,Go,AGPL-3.0)这类项目就是把”数据库运维知识”编码成 CRD 的产物——它支持 MySQL、PostgreSQL、Redis、MongoDB、Kafka、ClickHouse 等 30 多种引擎的生命周期管理。
第三部分 · 动态扩容:五个工具,四层职责,一个都不能配错
十、先分清:扩容不是一个问题,是四个问题
“我们的服务能自动扩容”这句话背后,可能是完全不同的四件事。混淆它们,是绝大多数扩容配置失效的起点。
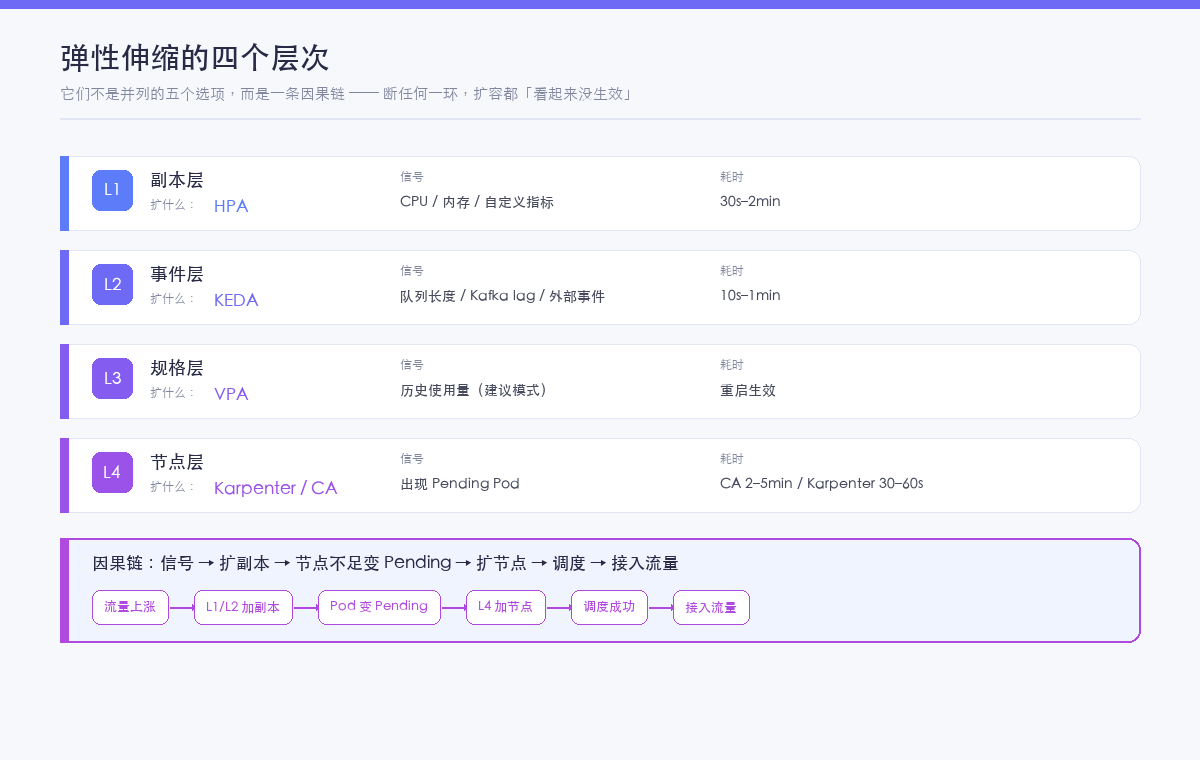
| 层次 | 扩什么 | 工具 | 触发信号 | 典型耗时 |
|---|---|---|---|---|
| L1 副本层 | Pod 数量 | HPA | CPU / 内存 / 自定义指标 | 30s–2min |
| L2 事件层 | Pod 数量 | KEDA | 队列长度 / Kafka lag / 外部事件 | 10s–1min |
| L3 规格层 | 单个 Pod 的资源 | VPA | 历史使用量 | 分钟级(会重启) |
| L4 节点层 | 机器数量 | Cluster Autoscaler / Karpenter | 有 Pod 处于 Pending | CA 2–5min,Karpenter 30–60s |
它们的关系是一条因果链,而不是五个并列的选项:
1 | 流量上涨 |
这条链上任何一个环节断了,扩容就”看起来没生效”。最常见的误解是:明明配了 HPA,为什么没扩? 因为 HPA 只管 Pod 数量,节点不够它不管——Pod 卡在 Pending,HPA 的副本数照涨不误,但一个都起不来。
10.1 选型的出发点不是工具,是信号
配置弹性伸缩的正确顺序不是”我要用 KEDA”,而是三问:
- 信号是什么? CPU 涨?内存涨?队列积压?请求延迟?外部事件?
- 扩什么? 扩副本能解决吗,还是单个副本的资源规格就不够?
- 边界在哪? 最多扩到多少?最少保留几个?冷却多久?
对应的回答路径:
1 | 信号来自应用内部负载(CPU/内存/QPS) → HPA |
十一、HPA:最常用,也最容易配错的那个
HPA(Horizontal Pod Autoscaler)是 K8s 内置能力,不需要额外装组件(但必须装 metrics-server 才能拿到 CPU/内存指标,这是新手最常见的坑)。
11.1 HPA 的算法
HPA 每 15 秒(默认 --horizontal-pod-autoscaler-sync-period)算一次:
1 | 期望副本数 = 向上取整( 当前副本数 × ( 当前指标值 / 目标指标值 ) ) |
比如当前 4 个副本,CPU 平均使用率 80%,目标 50%:
1 | 期望副本数 = ceil(4 × (80 / 50)) = ceil(6.4) = 7 |
三个必须知道的细节:
细节一:指标是所有 Pod 的平均值,不是最大值。 一个 10 副本的 Deployment 里,如果有 1 个 Pod 打到 100% CPU、其余 9 个在 10%,平均值是 19%,目标 50% 的话 HPA 会认为”很闲”,不会扩容。热点 Pod 会被”平均掉”。
细节二:有容忍度(tolerance)。 默认容忍 10% 的偏差,即计算值在 [0.9, 1.1] 区间内不做任何操作。目的是减少抖动。Kubernetes v1.35 起,behavior 字段支持配置这个容忍阈值,不再是全局固定的 10%。
细节三:缩容有稳定窗口。 默认 5 分钟内,取”这段时间内算出来的最大值”作为目标——防止短暂的低谷触发缩容。
11.2 一个生产可用的 HPA 配置
1 | apiVersion: autoscaling/v2 |
behavior 是 HPA v2 最重要也最少人用的部分。它的核心策略是:
扩得快,缩得慢。(Fast up, slow down)
原因很实际:扩容慢,用户会感受到卡顿甚至超时;缩容太快,一个短暂低谷就把容量砍掉,下一波流量来了又得重新扩——而重新扩的代价是冷启动 + 预热 + 可能的 OOM。激进缩容省下的那点钱,远不如一次抖动造成的事故成本高。
11.3 自定义指标:CPU 之外的选择
CPU 是最容易拿到但经常不是最好的信号。原因有三:
- CPU 是结果,不是原因。 队列积压 10 万条时,CPU 可能只有 20%。
- 异步/IO 密集型服务,CPU 常年很低。 一个消息消费者卡在等待下游 API,CPU 使用率可能只有 5%,但延迟已经爆了。
- 语言运行时干扰。 JVM 的 GC 峰值未必反映在 CPU 平均值上;Go 的 goroutine 堆积也不体现在 CPU 上。
更有意义的信号通常是三类:
- QPS / RPS:直接反映请求压力。
- 队列深度 / 消费延迟:反映异步链路的积压。
- p95/p99 延迟:反映用户体验,但不要用它做唯一信号——延迟升高时扩容往往已经晚了。
自定义指标需要通过 Prometheus Adapter 暴露给 K8s 的 metrics API:
1 | - type: Pods |
11.4 HPA 的四个坑
坑一:minReplicas 设成 1。 单副本在低峰期会被缩到 1,此时这个 Pod 就成了单点——它一旦重启(节点驱逐、滚动更新),服务就完全不可用。生产服务至少 2,重要服务至少 3。
坑二:用 CPU 做信号但没设 CPU limit。 HPA 的 Utilization 类型是”实际使用量 / request”。如果没设 request,或者 Pod 的 request 明显虚高,使用率永远达不到目标值,HPA 永远不触发。
坑三:HPA 和 VPA 控制同一个指标。 VPA 改 request,HPA 基于 request 算使用率,两者互相影响会形成震荡。解法:VPA 只用推荐模式(updateMode: "Off"),HPA 负责副本。
坑四:扩容了但没用。 表现为 HPA 的副本数涨上去了,但 Pod 全是 Pending。这是节点层的问题,不是 HPA 的问题。
十二、KEDA:事件驱动与缩到零
KEDA(Kubernetes Event-driven Autoscaling,★10.6k,Go,Apache-2.0,CNCF 毕业项目)解决 HPA 解决不了的一类问题:信号来自 Kubernetes 之外。
12.1 KEDA 的定位:它是 HPA 的”信号源扩展”
技术上,KEDA 创建并管理一个 HPA 对象。它不是 HPA 的替代品,而是给 HPA 提供了它自己拿不到的外部信号:
1 | 外部事件源 → KEDA Scaler → 指标 → KEDA 创建的 HPA → 调整副本数 |
因此:不要对同一个 Deployment 同时手动创建 HPA 和 KEDA ScaledObject——两个控制器会争抢副本数,导致震荡。
12.2 三个核心对象
- ScaledObject:把 Deployment/Job 和外部事件源关联起来。
- ScaledJob:按事件数量创建 Job(而不是加副本),适合批处理。
- TriggerAuthentication:事件源的认证信息(连接串、密码),与业务配置分离。
12.3 一个 Kafka 消费者的配置
1 | apiVersion: keda.sh/v1alpha1 |
KEDA 2.x 支持 60 多个 Scaler:Kafka、RabbitMQ、NATS、AWS SQS、Azure Service Bus、GCP Pub/Sub、Redis、Prometheus、Cron、PostgreSQL、MySQL、Elasticsearch、GitHub Runner……
最后两个值得单独提:
- Cron Scaler:按时间表扩容。适合”每天早上 9 点流量高峰”这类可预测场景——在流量来之前先把容量准备好,比被动扩容体验好得多。
- GitHub Runner Scaler:按 CI 队列长度自动扩 Runner,是降低 CI 成本的有效手段。
12.4 缩到零的三个前提
minReplicaCount: 0 是 KEDA 最大的省钱武器,但有三个必须满足的前提:
前提一:业务能接受冷启动。 从 0 到 1 需要:调度 Pod → 拉镜像 → 启动进程 → 通过探针 → 接入流量。整体通常是 10 秒到 2 分钟,取决于镜像大小和 JVM 预热。
前提二:HTTP 服务需要 KEDA HTTP Add-on。 普通 Deployment 缩到 0 后,第一个请求会直接 connection refused。HTTP Add-on 提供了一个常驻代理,把请求 hold 住,同时触发扩容,副本起来后再把请求转发过去。
前提三:要有 fallback 副本数兜底。 如果外部事件源本身不可达(比如监控系统挂了),KEDA 会失去信号。配置 fallback 可以保证它按一个保守值继续运行,而不是缩到 0。
1 | fallback: |
判断标准:缩到零适合异步消费者、内部任务、不频繁的事件处理器;不适合有严格 SLA 的对外 API。
十三、VPA:为什么它应该只开推荐模式
VPA(Vertical Pod Autoscaler)调整单个 Pod 的资源 request/limit。理念和 HPA 完全不同:HPA 加数量,VPA 调单个。
13.1 三种模式,只有一种应该上生产
| 模式 | 行为 | 生产可用性 |
|---|---|---|
Off |
只给建议,不改任何东西 | 推荐:唯一安全的选择 |
Initial |
只在 Pod 创建时设定 request | 有限可用 |
Recreate / Auto |
修改 request,驱逐并重建 Pod | 谨慎:会造成重启 |
Auto 模式的机制是:VPA 算出更合适的 request → 修改 Pod 规格 → 驱逐 Pod 让它重建。这意味着生产服务会在你不知道的时候被重启。对于长连接服务、有内存缓存的服务、或者 minReplicas: 1 的服务,这是不可接受的。
13.2 VPA 的正确用法
1 | apiVersion: autoscaling.k8s.io/v1 |
然后定期查看建议:
1 | kubectl describe vpa order-service |
输出会给出四个值:Lower Bound / Target / Upper Bound / Uncapped Target。
推荐模式下的工作流是:
1 | 1. VPA 持续观察 7–14 天的真实使用量 |
这个流程把”资源规格调整”变成了一次受审查的变更,而不是一个黑盒自动行为。对生产系统来说,这个约束是必要的。
VPA 还有两个进阶用法:
- CPU 与内存分开:只对内存开 VPA,CPU 交给 HPA,避免同一指标被两个控制器影响。
- VPA 与 In-place Resize 结合:Kubernetes v1.35 起 In-place Pod Resize 转正,未来 VPA 有望在不重启的情况下调整资源,这会彻底改变 VPA 的生产可用性。这是 2026 年最值得期待的一个组合。
十四、节点层:Karpenter 与 Cluster Autoscaler 的根本差异
14.1 不是快慢之争,是心智模型之争
| 维度 | Cluster Autoscaler | Karpenter |
|---|---|---|
| 模型 | 基于节点组(Node Group / ASG) | 直接调用云 API 创建实例 |
| 决策方式 | 从你预先定义的节点组里挑一个扩容 | 根据 Pending Pod 的需求,临时决定机型 |
| 机型选择 | 一个节点组通常固定机型 | 在上千种机型里实时选最合适的 |
| 扩容速度 | 2–5 分钟 | 30–60 秒 |
| 缩容方式 | 逐个缩 ASG | 整合(Consolidation):主动把负载搬到更少的机器上 |
| Spot 处理 | 通过 ASG 混合实例策略 | 自动处理中断、自动回退到按需 |
| 多集群/多云 | 支持广,成熟 | AWS 最佳,其它云在推进中 |
根本差异是这个反转:
- Cluster Autoscaler 的思维是:你先定义好有哪些类型的节点,它从中选一个。
- Karpenter 的思维是:你只描述约束(架构、可用区、容量类型、实例族范围),它临时决定创建什么。
这个转变让很多团队不适应,因为它要求你少配置、多信任。但它是正确的方向——人不应该在几个月前就猜出下个流量高峰需要什么机型。
14.2 Karpenter NodePool 配置要点
1 | apiVersion: karpenter.sh/v1 |
三个要点:
要点一:机型列表要宽。 这是最贵的错误之一——工程师只填了熟悉的三种机型,结果 Spot 容量在这些机型上短缺,Karpenter 只能回退到按需,省的钱全部吐回去。允许 8–12 个实例族不会增加任何成本,但会显著提高 Spot 可用率。
要点二:一定要开 Consolidation。 Karpenter 的整合会持续寻找”把这些 Pod 挪到更少的机器上”的机会,这是它省钱的真正来源。
要点三:limits 是硬护栏。 没有 limits,一个流量高峰可以把集群扩到破产。limits 是财务安全线,必须设。
14.3 什么时候不该用 Karpenter
- 自建机房 / 私有云:Karpenter 依赖云 API 直接创建机器,物理机上用不了。这时 Cluster Autoscaler + Cluster API 是更现实的组合。
- 合规要求绑定了特定 ASG 配置:如果审计要求”机器必须由经过审计的 ASG 模板创建”,Karpenter 的动态机型选择会成为一个合规问题。
- 团队没人维护:Karpenter 需要 IAM 配置、CRD 管理、版本升级,是有运维成本的。
决策建议:新集群默认 Karpenter,老集群没有痛点就先别动。
十五、2026 年的现实:你的集群可能只用了 8%
讲完工具,看一组数据。这组数据是本文所有”落地方案”的现实基础。
根据 Cast AI 2026 State of Kubernetes Optimization Report(2026 年 1—4 月,采集 AWS / GCP / Azure 上 23,000+ 个生产集群的直接遥测数据,未开启任何优化工具前):
| 指标 | 2025 | 2026 | 趋势 |
|---|---|---|---|
| 平均 CPU 利用率 | 10% | 8% | ↓ |
| 平均内存利用率 | 23% | 20% | ↓ |
| GPU 利用率 | — | 5% | — |
| CPU 过度配置的集群比例 | 40% | 69% | ↑ |
| 内存过度配置的集群比例 | — | 79% | — |
Datadog 的 State of Cloud Costs 从账单侧印证了同一件事:约 83% 的容器支出花在闲置资源上,其中 54 个百分点是闲置的集群基础设施,29 个百分点是工作负载申请超过实际使用。
注意趋势方向:这些数字在变差,不是变好。
15.1 为什么会漂移成 8%
没有人一开始就想买 12 核只用 1 核。它是四个”没人复查的默认值”叠加的结果:
① 复制粘贴的 request。 Helm Chart 里写着 cpu: 1000m,因为作者在自己笔记本上测完就向上取整了。这个 Chart 被部署了 40 次。
② 每一层都加一点恐惧。 开发者为了保险加 2 倍 → Chart 维护者默认再加 2 倍 → 平台团队的 LimitRange 再加 2 倍。三个”合理的” 2 倍安全系数复合成了 8 倍。
③ 调度器默认在打散。 LeastAllocated 把每个 Pod 放到最空的节点,结果是所有节点都一点点忙,没有节点是满的。这是 8% 直方图的直接成因。
④ 为临时事件加的容量永远不会退场。 为一次大促、一次迁移、一次流量高峰加的机器,因为”删掉有风险”而永久留下。在云上它至少是一条能被质疑的账单;在自建机房,它是沉默的。
15.2 一份可以直接抄的默认配置表
针对固定集群(自建机房、托管机架、Cluster API 纳管的机器),这组默认值可以直接投入使用:
| 配置项 | 应该采用的默认值 | 为什么 |
|---|---|---|
| CPU request | 实测 p95;Web 服务从 100m–250m 起步,不要 1000m | request 是调度器唯一的装箱输入。p95 只有 80m 的服务申请 1000m,会在每个副本上浪费 92% 的核心 |
| CPU limit | 延迟敏感服务不设;如策略要求则 ≥ 4× request | CPU 是可压缩资源,争抢时内核按 request 权重公平调度。硬限制即使在空闲节点上也会引入 CFS 节流延迟 |
| 内存 request | 实测峰值 + 约 25%,且与 limit 相等 | 内存不可压缩,超用是 OOM Kill 不是变慢。request=limit 让 Pod 获得 Guaranteed 级别,也让装箱计算诚实 |
| 内存 limit | 与 request 相同 | 装箱节点上绝不能让 limit > request,那个差额是无法调度的风险 |
| LimitRange(每命名空间) | defaultRequest: 100m CPU / 128Mi;默认只给内存设 limit | 没写 request 的 Pod 继承合理默认值,而不是 Chart 作者的恐惧 |
| 调度器打分 | NodeResourcesFit + MostAllocated |
默认的 LeastAllocated 会按设计制造出 8% 集群 |
| Descheduler | HighNodeUtilization profile,尊重 PDB |
装箱会随着 Deployment 更新而衰减,重调度器负责持续回收 |
| VPA | 只开推荐模式 updateMode: "Off" |
它是你的测量回路,建议输出后作为受审查变更应用 |
| 节点目标 | 每节点可分配 CPU 的 50%–70% 被 request 占用 | 区间,不是要最大化的分数 |
关于这个区间,两个边缘都要注意:
- **低于 50%**:你在为空闲的机器付费。
- **高于 70%**:你在吃掉故障冗余。
而且 CPU 和内存要区别对待:
- CPU 打满的节点会优雅降级(大家按权重分),不会死。
- 内存打满的节点会 OOM Kill,这是硬失败。
所以内存权重要高于 CPU,内存的 request 占比要比 CPU 更保守。
15.3 扩容的六个反模式
最后,把生产上最常遇到的扩容失效原因列成清单。每一个都真实地烧过钱或出过事故。
反模式一:单副本 + PDB minAvailable=1。
这是永久缩容阻断器。这个 Pod 所在的节点永远不能被腾空,集群会悄悄积累一批”永远在计费的空闲节点”。排查缩容问题时,第一个要查的就是 PDB。
反模式二:safe-to-evict: "false" 注解用得太随意。
这个注解保护 Pod 不被驱逐,但很多人是随手加的。加了它的 Pod 会让节点无法排空。
1 | # 只有真正不能被驱逐的 Pod 才加 |
反模式三:Pod 里用了 emptyDir 但节点缩容时没处理。
emptyDir 的 Pod 无法被安全迁移,会成为缩容阻断点。需要本地缓存时,考虑用 PVC 或外部缓存。
反模式四:节点实例机型列表太窄。
前面讲过,这是 Karpenter 省钱失败的头号原因。
反模式五:无人管理的 PVC。
StatefulSet 缩容、Deployment 删除后,PVC 依然在,云盘依然在计费。这是第二大隐形账单来源,建议定期巡检:
1 | # 找出没有被 Pod 使用的 PVC(候选清理对象) |
反模式六:非生产环境 7×24 运行。
44% 的云支出花在只在工作时间需要的非生产资源上。开发、测试、CI 集群在 168 小时里只被用 40 小时,却全天候开着。
这是最简单也最没被采用的一条省钱措施:给非生产集群配置定时缩容——工作日 9:00 扩容到 N,19:00 缩到最小值。
1 | # 用 KEDA Cron scaler 实现工作时间弹性 |
第四部分 · 企业级落地:一套可以照抄的完整方案
十六、目标架构:先画清楚要建成什么
企业落地容器平台,最忌讳的事是”边建边想”。下面这张架构是 2026 年比较成熟的一种形态,从左往右是研发 → 平台 → 运行时的三段式。
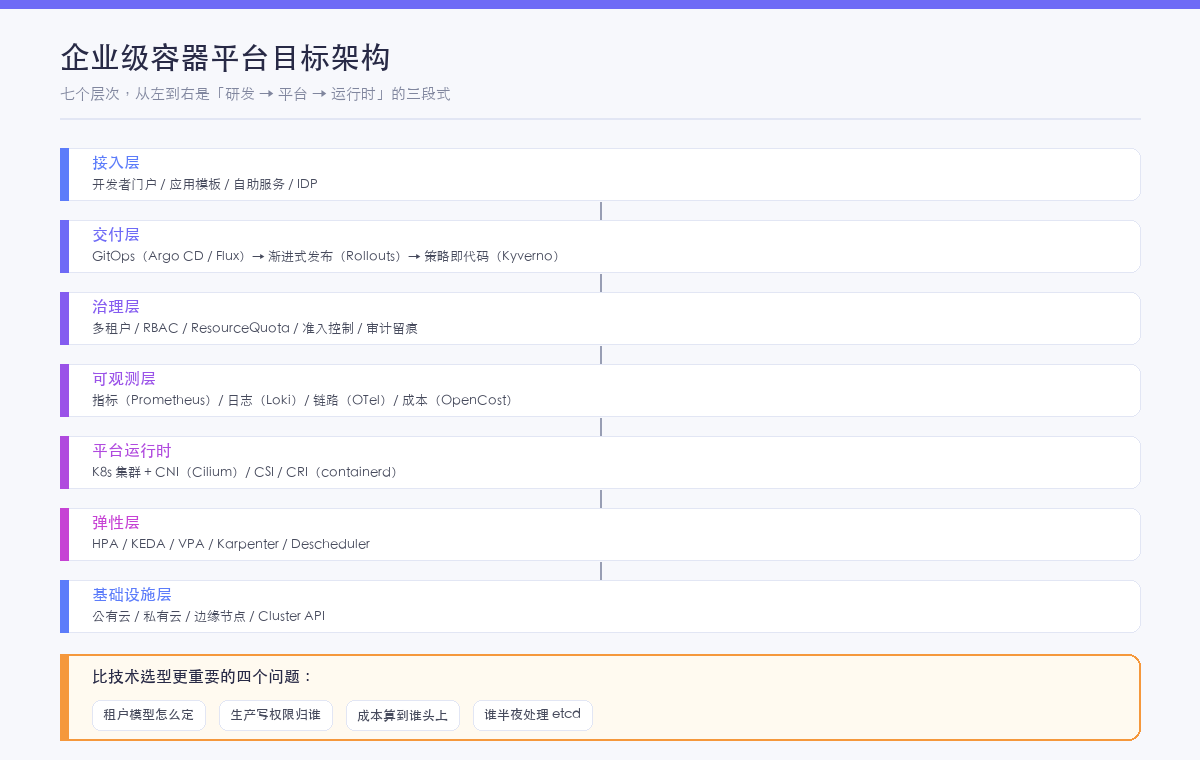
八个层次,从上到下:
1 | ┌─ 接入层 ─────────────────────────────────────────────┐ |
四个必须一开始就定下来的组织决策(它们比技术选型重要得多):
- 租户模型:按团队分命名空间,还是按团队分集群?
- 谁有 kubectl 权限:生产集群的写权限应该收口到 GitOps,还是保留给人?
- 成本归谁:有没有 showback/chargeback 机制,让团队看到自己的花费?
- 谁维护集群:自建控制平面、用云托管、还是用 Rancher/KubeSphere 这类平台?
这四个问题没有统一答案,但必须回答。80% 的容器平台项目失败,都失败在这四个问题上,而不是技术选型上。
十七、逐层落地:七个决策点
17.1 集群形态:托管、自建,还是发行版
| 形态 | 优点 | 缺点 | 适合 |
|---|---|---|---|
| 云托管(EKS/GKE/AKS/ACK/TKE) | 控制平面不用运维,高可用开箱即用 | 控制平面月费(EKS/GKE 约 $73/集群/月);版本节奏受厂商控制 | 绝大多数企业,默认推荐 |
| 轻量发行版(k3s / K3s / RKE2) | 单二进制,边缘友好,资源占用小 | 功能有裁剪 | 边缘、分支机构、开发测试 |
| 不可变发行版(Talos) | 无 SSH、无 shell,API 驱动,攻击面极小 | 运维方式完全不同,学习曲线陡 | 高安全要求、追求”服务器也要声明式管理” |
| 标准自建(kubeadm) | 完全可控、无厂商绑定 | 控制平面高可用、etcd 备份、证书轮转、升级全靠自己 | 有专职平台团队、强合规、私有化交付 |
| Cluster API 声明式自建 | 集群本身也是 K8s 对象,容量变更即 PR | 门槛最高 | 大规模自建机队、私有化交付产品化 |
2026 年的现实建议:
- 起步阶段:直接用云托管控制平面。控制平面的运维不产生业务价值,且是最容易出大事故的部分。
- 规模变大后:把集群创建过程用 Cluster API 或 Terraform 声明式化,让”加一个集群”变成一次 PR。
- 私有化交付场景:用 KubeKey(KubeSphere)、k3s、Sealos 这类能一键离线部署的方案。
一个反直觉但正确的判断:自建控制平面的成本不在钱,在于你需要一个能处理 etcd 故障、证书过期、API Server 雪崩的团队。 如果你的团队还没有人能独立处理这三类问题,就用托管。
17.2 网络:CNI 与 Gateway API
CNI 选型(2026 年):
| CNI | 数据面 | 特点 | 适合 |
|---|---|---|---|
| Cilium | eBPF | 性能最好,可观测性最强(Hubble),原生支持 NetworkPolicy 与 L7 策略 | 新集群首选,大规模集群 |
| Calico | iptables / eBPF(可切换) | 最成熟,文档全,网络策略能力强 | 存量集群、需要稳妥选择 |
| Flannel | VXLAN | 极简,无网络策略 | 学习、测试环境 |
选 Cilium 的理由在 2026 年越来越充分:eBPF 让它在高并发下绕过了 iptables 的线性查找开销,而且 Hubble 提供的网络层可观测性是排查”服务之间到底通不通”的唯一高效手段。
南北向流量:Gateway API 是 2026 年必须迁移的方向。
这是本文里最紧迫的一条时间提醒:
Ingress NGINX 已于 2026 年 3 月停止维护,不再有安全更新。
这意味着如果你还在用 kind: Ingress + nginx-ingress-controller,你的南北向入口已经是没有安全补丁的组件了。这是 2026 年最该排进日程的迁移项。
Gateway API 相比 Ingress 的实质改进:
- 角色分离:基础设施提供方管 GatewayClass/Gateway,业务团队管 HTTPRoute。这解决了 Ingress 时代”所有人都往一个 Ingress 对象里塞 annotation”的混乱。
- 表达能力强:原生支持加权分流、请求头匹配、流量镜像、超时重试,不依赖各家私有 annotation。
- 可移植:同一份 HTTPRoute 配置可以在 Istio、Envoy Gateway、Nginx Gateway Fabric、Higress 之间迁移。
一份标准的 Gateway API 配置:
1 | apiVersion: gateway.networking.k8s.io/v1 |
注意最后那段:Gateway API 原生支持按比例分流,这意味着即使不做完整的渐进式发布体系,也能实现最简单的灰度。
17.3 存储:有状态服务的最后一公里
存储选型取决于数据形态:
| 场景 | 方案 | 说明 |
|---|---|---|
| 块存储(数据库类) | 云盘 CSI(EBS/PD/云盘)+ Rook/Ceph | 云上优先用云盘;私有云用 Rook/Ceph |
| 分布式文件(共享目录) | Longhorn / OpenEBS / CephFS | Longhorn(★8.0k)上手最快,适合中小规模 |
| 对象存储 | MinIO(或直接云 S3) | 图片、日志、备份 |
| 本地存储 | Local PV / OpenEBS | 延迟敏感,但要接受节点绑定 |
三个 2026 年的存储实践要点:
要点一:StorageClass 要显式声明回收策略。
1 | apiVersion: storage.k8s.io/v1 |
volumeBindingMode: WaitForFirstConsumer 是个容易被忽略但重要的配置:它让卷的创建延后到 Pod 被调度时,这样才能保证卷和 Pod 在同一个可用区——否则会出现”卷在 A 区、Pod 只能调度到 B 区”的死锁。
要点二:默认 StorageClass 只能有一个。 没有默认 StorageClass 时,不指定 storageClassName 的 PVC 会永远 Pending。
1 | kubectl patch sc fast-ssd -p '{"metadata":{"annotations":{"storageclass.kubernetes.io/is-default-class":"true"}}}' |
要点三:定期回收孤儿 PVC。 前面讲过,这是第二大隐形账单来源。
17.4 镜像供应链:三道门禁
企业镜像体系的三件事:建得出来(构建)、存得住(仓库)、信得过(安全)。
门禁一:构建阶段扫描。 在 CI 里扫,越早发现越便宜。
1 | # CI 中:构建后立即扫描,高危漏洞直接失败 |
门禁二:镜像签名。 用 cosign 签名,确保”这个镜像确实是我们 CI 构建的”。
1 | # 签名(在 CI 中,使用 keyless 模式,基于 OIDC 身份) |
门禁三:运行时准入拦截。 用 Kyverno 在集群入口强制校验:
1 | apiVersion: kyverno.io/v1 |
落地顺序很重要:先 Audit,观察一周确认没有误伤,再转 Enforce。 直接上 Enforce 是大规模故障的常见来源——你会发现有几十个历史镜像根本没签名。
17.5 安全基线:Pod Security 与策略即代码
Kubernetes 1.25+ 内置了 Pod Security Admission(PSA),替代了已移除的 PodSecurityPolicy。三个级别:
| 级别 | 允许的容器 | 适合 |
|---|---|---|
| Privileged | 无限制 | 系统组件(CNI、CSI 驱动) |
| Baseline | 禁止已知的特权提升(privileged、hostPath、hostNetwork 等) | 大多数应用的底线 |
| Restricted | 进一步要求非 root、丢弃所有 capability、seccomp、无权限提升 | 高安全场景,也是应该追求的目标 |
命名空间级别启用:
1 | apiVersion: v1 |
建议:非系统命名空间至少设到 baseline,重要业务设 restricted。
更细粒度用 Kyverno(或 OPA Gatekeeper),它能在 PSA 之外做这些事:
1 | apiVersion: kyverno.io/v1 |
这份策略同时解决了四个高频问题:没有资源限制(导致装箱乱套)、没有探针(导致流量打到未就绪的 Pod)、用 latest 标签(导致无法复现和回滚)、以及镜像来源不可控。
17.6 可观测:指标、日志、链路、成本的四位一体
2026 年可观测性的一大变化是 OpenTelemetry 成为事实标准——指标、日志、链路三种信号用同一个协议采集,不再各自为政。
| 信号 | 采集 | 存储 | 关键指标 |
|---|---|---|---|
| 指标 | Prometheus / OTel Collector | Prometheus / VictoriaMetrics / Thanos | RED(Rate/Error/Duration)+ USE(Utilization/Saturation/Errors) |
| 日志 | Fluent Bit / Vector / OTel | Loki / Elasticsearch / ClickHouse | 结构化 JSON,带 trace_id |
| 链路 | OTel SDK + Collector | Jaeger / Tempo | 端到端调用链、跨服务延迟分解 |
| 成本 | OpenCost | Prometheus | 按命名空间/团队/应用的成本分摊 |
四条实践建议:
① 指标 cardinality 是最容易失控的东西。 一个 label 基数爆炸(比如把 user_id 塞进 label),能让 Prometheus 内存飙到几十 GB。原则:label 只放低基数、有聚合意义的维度(namespace、service、method、status_code)。
② 日志必须结构化。 应用直接输出 JSON 日志,不要依赖后面的正则解析。每条日志带上 trace_id,这样日志和链路能直接关联。
③ 成本可观测是 2026 年的必选项。 OpenCost(★6.8k,Go,Apache-2.0,CNCF 项目)能把云账单拆到命名空间级别:
1 | # 查看每个命名空间的日成本 |
没有成本可见性,就不可能有成本优化——你连该优化谁都不知道。
④ 先做 showback,再做 chargeback。 直接把账单甩给业务团队会引发抵触。先让他们”看到”自己的花费(showback),等习惯养成、数据可信了,再谈实际扣费(chargeback)。CNCF 的数据显示只有 14% 的组织真正做了 chargeback——这也解释了为什么浪费会持续积累。
17.7 成本治理:六步路线图
顺序很重要,跳步会让工具帮你规模化浪费,而不是消除浪费:
1 | Step 1 可见性 → 部署 OpenCost,标准化标签,按命名空间/团队/应用分摊 |
为什么顺序不能乱:
- 在 request 虚高 8 倍的情况下先配 HPA?HPA 会基于虚高的 request 算出极低的利用率,永远不触发。 你配了一个永不生效的 HPA。
- 在 request 虚高的情况下先配 Karpenter?Karpenter 会为满足虚高 request 而创建远超实际需要的节点。 你在规模化浪费。
这就是为什么”先买优化工具、后修 request”是错的——你花钱是为了观察浪费,而不是消除它。
关于 Spot 实例的判断很直接:
1 | 适合 Spot:无状态服务、批处理任务、CI Runner、可重入的消费任务 |
Karpenter/KEDA 的组合能让 Spot 的中断影响降到最低——Karpenter 会在收到中断信号(提前 2 分钟)后立即创建新节点并驱逐 Pod。
十八、交付层:GitOps 为什么是终局
18.1 GitOps 解决的核心问题
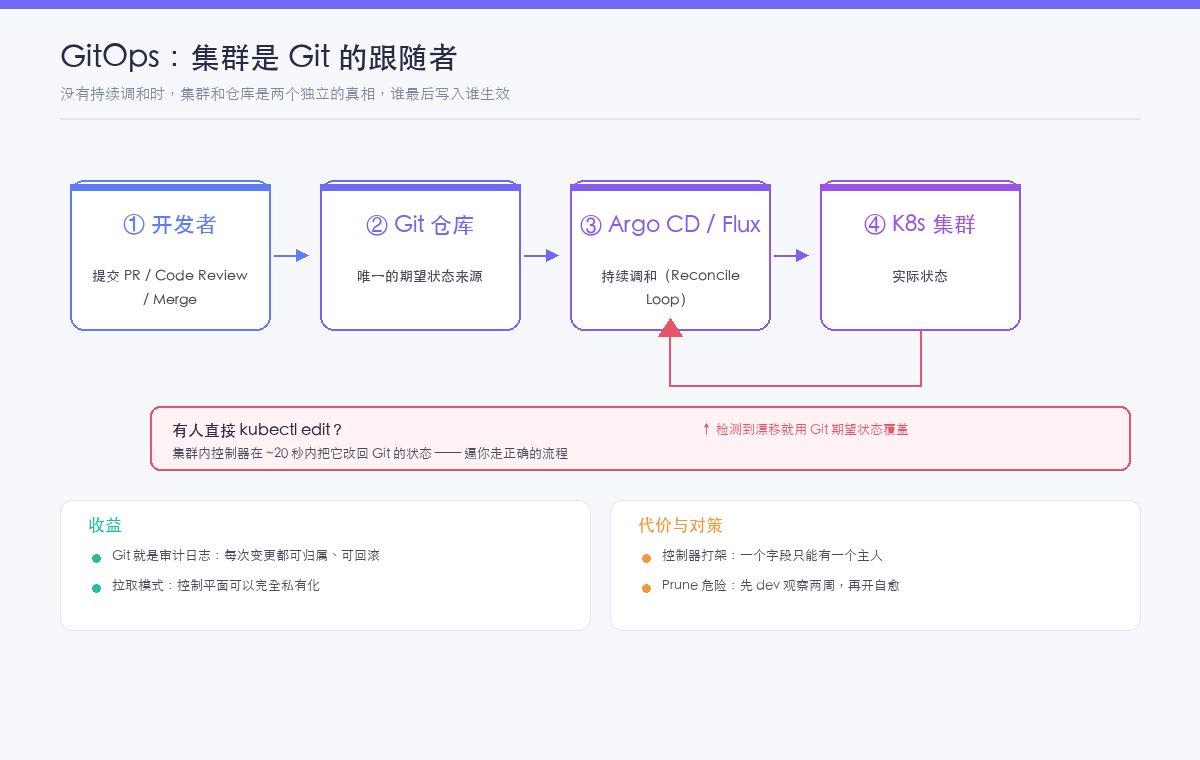
先说一个真实场景(这类事故在很多公司都发生过):
凌晨 2 点,值班工程师为了快点修好故障,直接在生产集群上执行了
kubectl set image替换了镜像。修好了。一小时后,定时任务触发了正常的流水线,从 Git 里拉配置重新部署——把刚才那个热修复静默回滚了,服务又坏了。
接下来 45 分钟没人能搞清楚发生了什么,因为谁都没把”定时重部署”和”服务又坏”联系起来。
这个故事暴露的问题不是”人违规操作”,而是:
没有持续调和时,集群和仓库是两个独立的真相,谁最后写入谁生效。
GitOps 的核心主张是:集群是 Git 的跟随者。
1 | 想要改生产环境 → 改仓库 → 集群自动跟上 |
18.2 GitOps 的四个收益
- Git 就是审计日志:每一次生产变更都是一次经过 review 的、可归属的、可回滚的提交。合规审计问”证明每个生产变更都经过评审”,直接给 git log 和 PR 记录。
- 持续漂移修正:集群不可能悄悄偏离意图。
- 拉取模式:不需要把集群凭证交给外部 CI 系统,API Server 可以完全私有化——这是安全架构上的重要收益。
- 回滚就是 git revert:几秒钟完成,而不用重跑 45 分钟的流水线。
18.3 Argo CD 与 Flux:不是二选一
| 维度 | Argo CD | Flux |
|---|---|---|
| 形态 | 有成熟 Web UI 和 API | 纯 CLI/CRD,无 UI |
| 上手 | 曲线相对平缓 | 需要理解其 CRD 模型 |
| 多集群 | ApplicationSet + Cluster 生成器,很强 | 同样支持,但更声明式 |
| 架构 | 控制平面集中 | 组件化,更”Unix 哲学” |
| 典型分工 | 面向应用团队(要 UI) | 面向平台团队(要无头) |
2026 年很多团队的答案是:混合。
1 | Argo CD → 管理应用(业务团队需要 UI 看状态、需要手动 sync) |
这个分工还有个额外的可靠性收益:Argo CD 挂了,Flux 还能发服务;Flux 出问题,Argo CD 还能更新集群配置。不会同时全挂。
18.4 ApplicationSet:多集群批量管理的核心
1 | apiVersion: argoproj.io/v1alpha1 |
一份配置,所有生产集群同步。改一个 Chart 版本,一个 PR 同时命中 prod-us 和 prod-eu,版本漂移问题从根上消失。
18.5 GitOps 落地的五个阶段(顺序即经验)
直接上生产、开自愈、开 prune,是事故配方。正确顺序是:
| 阶段 | 动作 | 自愈 / Prune | 这段时间要证明什么 |
|---|---|---|---|
| 第 1–2 周 | 接入 dev,只观察漂移 | 关 / 关 | 找出哪些字段会和控制器打架(HPA 的 replicas、sidecar 注入的容器) |
| 第 3 周 | 补 ignoreDifferences,dev 开自愈 |
开 / 关 | 字段归属明确后,自愈是稳定的 |
| 第 4 周 | staging 阶段 | 开 / 开(PruneLast) | 有护栏时 prune 是安全的 |
| 第 5 周 | 生产集群逐个接入 | 开 / 开 | 手动 kubectl edit 会在 ~20 秒内被自动还原 |
| 第 6 周 | 私有 API Server、SOPS 密钥、ApplicationSet | — | 拉取模式让控制平面可以完全不对外暴露 |
第一步”只观察两周”是最容易被跳过也最不该跳过的。 那两周会发现三到五个”你以为你管着、其实由别的控制器管着”的字段——如果直接开自愈,这些字段会让 Argo CD 和相关控制器无限互相覆盖。
18.6 密钥怎么办
密钥不能明文进 Git,这是 GitOps 最大的一道坎。三个主流方案:
| 方案 | 机制 | 适合 |
|---|---|---|
| SOPS | 用 KMS 密钥加密文件,密文进 Git,集群内解密 | 有云 KMS,最简单直接 |
| Sealed Secrets | 集群内公钥加密,只有本集群能解 | 单集群、不想依赖外部 KMS |
| External Secrets Operator | 集群从 Vault/云密钥管理服务拉取 | 已有 Vault 或云密钥体系 |
推荐 SOPS + 每环境一把 KMS 密钥:密码以密文形式存 Git,轮换就是一次 PR,审计天然满足。
十九、渐进式发布:从”发布”到”控制发布”
传统滚动更新(RollingUpdate)的问题是粒度太粗:一旦新版本有 bug,滚动到第 N 个副本时所有用户都受影响了。
渐进式发布解决的是:把影响面从”全部用户”缩小到”1% 用户”,并且能在指标恶化时自动停止。
19.1 Argo Rollouts 的金丝雀配置
1 | apiVersion: argoproj.io/v1alpha1 |
这段配置的精髓在 analysis 那一步:它不是”等待 10 分钟然后继续”,而是”每 60 秒查一次指标,成功率不达标就自动回滚”。
如果不配 analysis,金丝雀就退化成了”人工盯着 Grafana 看十分钟”——人会在第三次发布时就不看了。
19.2 三种发布策略的适用边界
| 策略 | 机制 | 适用 | 不适用场景 |
|---|---|---|---|
| RollingUpdate | 逐个替换 | 无状态、向下兼容、低风险 | 有状态、大版本变更 |
| Canary | 按比例引流 + 指标验证 | 常规在线服务的默认选择 | 数据库 schema 不兼容时 |
| Blue/Green | 全量切换,旧版保留待回滚 | 大版本、需要秒级回滚 | 资源成本翻倍(要两份全量实例) |
关于数据库迁移这个永恒难题,有一条硬规则:
迁移必须与代码版本双向兼容。(Expand-Migrate-Contract)
具体来说:
- Expand:先加新字段/新表,不改旧的结构,新旧代码都能工作。
- Migrate:发布新代码,读写新结构。
- Contract:确认稳定后,再删除旧结构(这是独立的第三次发布)。
破坏这个规则的后果是:回滚代码后数据库不兼容,导致无法回滚——而”能回滚”是所有发布体系的安全底线。
二十、多集群:什么时候真的需要它
先说结论:绝大多数团队不需要多集群,需要的是更好的单集群治理。
多集群带来的复杂度是超线性的:网络打通、镜像同步、配置分发、跨集群服务发现、跨集群故障切换、多套监控数据聚合……每一个都是独立难题。
真正需要多集群的四个理由:
- 故障域隔离:一个集群的爆炸半径太大,业务规模不允许。
- 地域合规:数据必须留在中国境内 / 欧盟境内。
- 混合云/多云策略:不想被单一云厂商绑定。
- 边缘场景:总部集群 + N 个边缘集群。
20.1 三种多集群拓扑
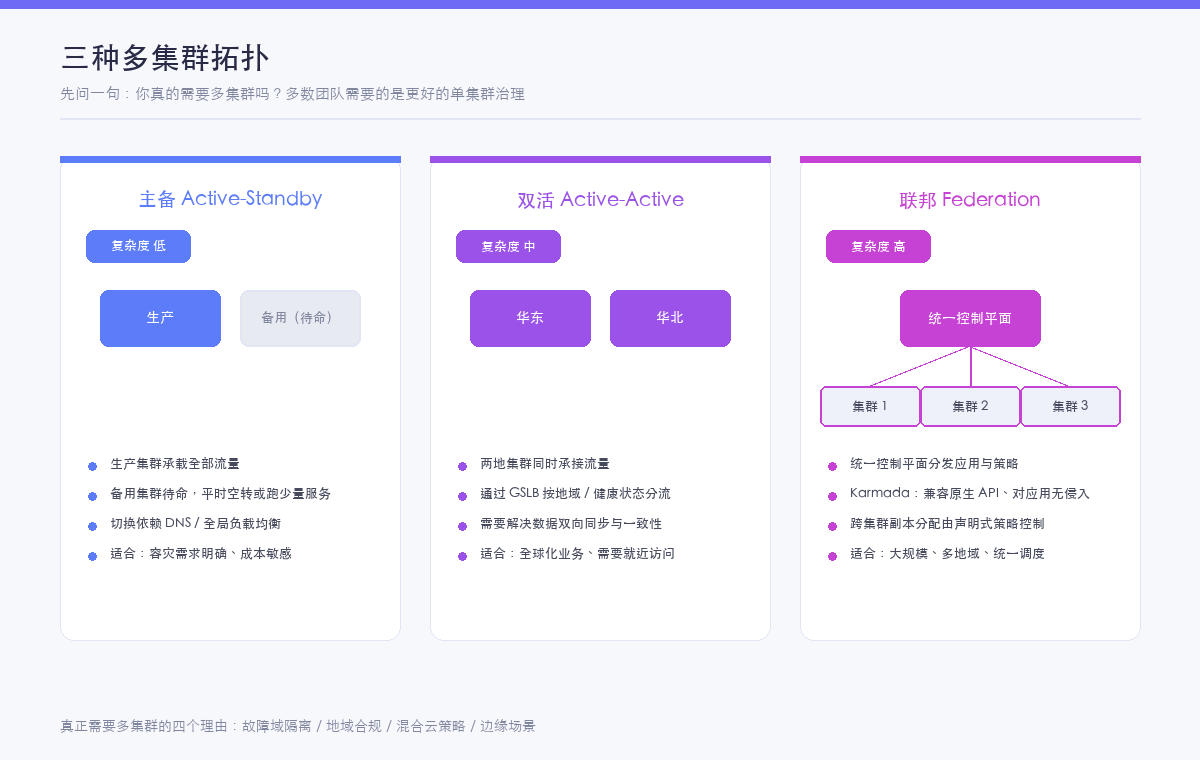
| 拓扑 | 形态 | 复杂度 | 适合 |
|---|---|---|---|
| 主备(Active-Standby) | 生产集群 + 备用集群,平时备用空转或跑少量服务 | 低 | 容灾需求明确、成本敏感 |
| 双活(Active-Active) | 两地集群同时承接流量 | 中 | 有全球化业务,需要就近访问 |
| 联邦(Federation) | 统一控制平面分发应用与策略 | 高 | 大规模、多地域、需要统一调度 |
20.2 Karmada:CNCF 的多集群方案
Karmada(★5.7k,Go,Apache-2.0,CNCF 孵化项目)的定位是”多云 Kubernetes 编排“。它的关键设计是兼容原生 API、对应用无侵入——你写的还是标准 Deployment,Karmada 负责决定把它分发到哪些集群、每个集群几个副本。
1 | apiVersion: policy.karmada.io/v1alpha1 |
这段配置表达的是”10 个副本,上海 6 个、北京 4 个”——跨集群的副本分配由声明式策略控制。
四家下游集群协作的项目里,中国移动、工商银行、腾讯、华为云等都在使用它,这也侧面说明它在多集群场景里的成熟度。
二十一、AI 负载上 K8s:2026 年最热的真实战场
如果 2024 年是”AI 能不能跑起来”,2026 年已经是”AI 在 K8s 上怎么跑得便宜”。CNCF 把 v1.35 称为”AI 的操作系统”版本,不是营销——K8s 确实正在成为混合负载(在线服务 + 批处理 + 训练 + 推理)的统一调度层。
AI 负载和传统 Web 服务的根本差异:
| 维度 | Web 服务 | AI 推理 / 训练 |
|---|---|---|
| 资源 | CPU、内存 | GPU(昂贵、稀缺、不可切分) |
| 时长 | 长期运行 | 训练的突发性 + 推理的长驻 |
| 调度 | 单 Pod 独立 | 训练需要 Gang Scheduling(全有或全无) |
| 弹性信号 | CPU/QPS | 队列深度、GPU 利用率、批处理大小 |
| 成本 | 按核小时 | 按卡时(H100 一小时几十元起) |
GPU 利用率只有 5% 这个数字,是 AI 基础设施当前最大的问题。三件事值得做:
① 用 DRA 管理设备。 v1.35 把 DRA 锁定为默认能力,可分区设备让单卡多负载成为可能。
1 | apiVersion: resource.k8s.io/v1beta1 |
② 用 KEDA 按队列深度弹性,配合缩到零。 GPU 闲置一小时就是一小时的钱。
1 | apiVersion: keda.sh/v1alpha1 |
注意 GPU 的缩容窗口要比 CPU 服务更长——GPU 节点供给不稳定,缩掉之后再想要回来可能拿不到卡。
③ 用 Volcano / Kueue 做批处理与队列管理。 训练任务的 Gang Scheduling、队列优先级、资源配额,这些是原生 K8s 调度器不擅长而 Volcano(★6.0k,Go)专门做的。v1.35 起原生支持了 Gang Scheduling(Alpha),但生态成熟度上 Volcano 仍更可用。
第五部分 · GitHub 开源项目横评:哪些值得二次开发
写技术方案容易,选开源项目难。下面这些数据是 2026 年 10 月 19 日从 GitHub API 直接拉取的真实数据(Star、语言、许可、创建时间、最近推送时间),不是估算。
为什么”最近推送时间”这一列很重要:它比 Star 更能说明项目当前是否还活着。下表中你会发现几个 Star 很高但数月未更新的项目——这是真实信号,不是我编的。
二十二、项目总表:四组,50 个
22.1 容器运行时组
| 项目 | 定位 | 语言 | 许可 | Star | 创建 | 最近推送 |
|---|---|---|---|---|---|---|
| moby/moby | Docker Engine(开发体验的源头) | Go | Apache-2.0 | 72.2k | 2013 | 10-16 |
| containerd/containerd | 生产集群事实标准 CRI | Go | Apache-2.0 | 21.4k | 2015 | 10-18 |
| containers/podman | 无守护进程容器引擎 | Go | Apache-2.0 | 33.1k | 2017 | 10-18 |
| cri-o/cri-o | 只服务 K8s 的精简 CRI | Go | Apache-2.0 | 5.7k | 2016 | 10-19 |
| opencontainers/runc | OCI 参考实现 | Go | Apache-2.0 | 13.5k | 2015 | 10-17 |
| containers/crun | C 实现的快速 OCI 运行时 | C | GPL-2.0 | 4.2k | 2017 | 10-18 |
| containers/youki | Rust 实现的 OCI 运行时 | Rust | Apache-2.0 | 7.6k | 2021 | 10-19 |
| kata-containers | 安全容器(轻量 VM) | Rust/Go | Apache-2.0 | 9.0k | 2017 | 10-17 |
| google/gvisor | 用户态内核沙箱 | Go | Apache-2.0 | 19.7k | 2018 | 10-18 |
| firecracker | KVM 微虚拟机 | Rust | Apache-2.0 | 37.5k | 2017 | 10-16 |
| WasmEdge | Wasm 运行时(AI 推理强) | C++ | Apache-2.0 | 10.8k | 2019 | 10-19 |
| wasmtime | WASI 参考实现 | Rust | Apache-2.0 | 18.7k | 2017 | 10-16 |
| containerd/runwasi | K8s 跑 Wasm 的 shim | Rust | Apache-2.0 | 1.3k | 2022 | 10-19 |
| moby/buildkit | 现代镜像构建引擎 | Go | Apache-2.0 | 10.3k | 2017 | 10-19 |
| GoogleContainerTools/kaniko | K8s 内构建镜像 | Go | Apache-2.0 | 15.8k | 2018 | 2025-06-03 |
⚠️ 注意 Kaniko 那一行:15.8k Star,但最近推送是 2025 年 6 月,已停滞一年多。Star 是历史资产,不是当前状态。新项目不建议再依赖它。
22.2 平台 / PaaS 组(二次开发主战场)
| 项目 | 定位 | 语言 | 许可 | Star | 创建 | 最近推送 |
|---|---|---|---|---|---|---|
| rancher/rancher | 多集群统一管理 | Go | Apache-2.0 | 26.0k | 2014 | 10-17 |
| kubesphere/kubesphere | 容器平台 / 可插拔 PaaS | Go | 自定义 | 17.1k | 2018 | 2026-07-15 |
| labring/sealos | 以 K8s 为内核的云 OS | Go | 自定义 | 18.4k | 2018 | 10-19 |
| kubevela/kubevela | OAM 应用交付平台 | Go | Apache-2.0 | 7.9k | 2020 | 10-18 |
| goodrain/rainbond | 不用学 K8s 的 PaaS | Go | 自定义 | 6.3k | 2017 | 10-15 |
| eip-work/kuboard-press | 中文 K8s 管理界面 | Shell(文档) | 无声明 | 25.3k | 2019 | 10-18 |
| coollabsio/coolify | 自托管 Heroku 替代品 | PHP | Apache-2.0 | 63.2k | 2021 | 10-18 |
| portainer/portainer | 容器管理 GUI | TypeScript | Zlib | 38.7k | 2016 | 10-16 |
| kubero-dev/kubero | 轻量内部 PaaS | TypeScript | GPL-3.0 | 4.4k | 2022 | 10-13 |
22.3 组件 / 增强组
| 项目 | 定位 | 语言 | 许可 | Star | 创建 | 最近推送 |
|---|---|---|---|---|---|---|
| kubernetes/kubernetes | 编排内核 | Go | Apache-2.0 | 128.4k | 2014 | 10-18 |
| k3s-io/k3s | 轻量发行版 | Go | Apache-2.0 | 34.2k | 2018 | 10-17 |
| siderolabs/talos | 不可变 K8s 操作系统 | Go | MPL-2.0 | 11.4k | 2017 | 10-16 |
| kubernetes-sigs/cluster-api | 声明式集群生命周期 | Go | Apache-2.0 | 4.3k | 2018 | 10-16 |
| openkruise/kruise | 应用自动化增强控制器 | Go | 自定义 | 5.4k | 2019 | 10-14 |
| karmada-io/karmada | 多云多集群编排 | Go | Apache-2.0 | 5.7k | 2020 | 10-19 |
| kubeedge/kubeedge | 边缘计算框架 | Go | Apache-2.0 | 7.6k | 2018 | 10-16 |
| volcano-sh/volcano | 批处理 / AI 调度 | Go | Apache-2.0 | 6.0k | 2019 | 10-15 |
| kedacore/keda | 事件驱动弹性 | Go | Apache-2.0 | 10.6k | 2019 | 10-18 |
| kubernetes-sigs/karpenter | 节点自动供给 | Go | Apache-2.0 | 2.2k | 2022 | 10-16 |
| kubernetes/autoscaler | CA + VPA | Go | Apache-2.0 | 9.0k | 2017 | 10-18 |
| kubernetes-sigs/descheduler | 重调度(装箱维护) | Go | Apache-2.0 | 5.5k | 2017 | 10-05 |
| apecloud/kubeblocks | 数据库 / 中间件 Operator | Go | AGPL-3.0 | 3.1k | 2022 | 10-18 |
| argoproj/argo-cd | GitOps 交付 | Go | Apache-2.0 | 24.4k | 2018 | 10-19 |
| argoproj/argo-rollouts | 渐进式发布 | Go | Apache-2.0 | 3.6k | 2018 | 10-19 |
| fluxcd/flux2 | GitOps 工具集 | Go | Apache-2.0 | 8.4k | 2020 | 10-19 |
| cilium/cilium | eBPF 网络 / 可观测 | Go | Apache-2.0 | 25.7k | 2015 | 10-18 |
| goharbor/harbor | 镜像仓库 | Go | Apache-2.0 | 29.6k | 2016 | 10-16 |
| rook/rook | Ceph 存储 Operator | Go | Apache-2.0 | 13.7k | 2016 | 10-16 |
| longhorn/longhorn | 云原生分布式块存储 | Shell/Go | Apache-2.0 | 8.0k | 2017 | 10-19 |
| opencost/opencost | 成本可观测 | Go | Apache-2.0 | 6.8k | 2019 | 10-15 |
| kubevirt/kubevirt | 虚拟机与容器统一调度 | Go | Apache-2.0 | 7.1k | 2016 | 10-18 |
| aquasecurity/trivy | 漏洞 / SBOM 扫描 | Go | Apache-2.0 | 38.5k | 2019 | 10-16 |
| sigstore/cosign | 镜像签名 | Go | Apache-2.0 | 6.4k | 2021 | 10-16 |
22.4 关于”自定义许可”这一列
表中 KubeSphere、Sealos、Rainbond、OpenKruise 四个项目的许可被 GitHub 标记为 NOASSERTION,意思是”GitHub 的标准许可证检测无法自动归类”。
这不是说它们不开源,而是说明:它们使用了自定义许可证文本(通常是在 Apache-2.0 之上附加条款,或采用双许可结构)。
对企业二次开发,这是一个必须提前查清的真实风险点:
- 如果是基于 Apache-2.0 加附加条款,通常意味着保留了署名要求,但可能对商业闭源分发有额外约束。
- 如果需要把平台改造成自己的商业产品对外销售,法务必须读一遍 LICENSE 原文,不能只看 GitHub 的标签页。
- 相比之下,Rancher、KubeVela、Karmada、Argo、Cilium 等是标准 Apache-2.0,条款清晰,风险低。
类似的还有 KubeBlocks 用的是 AGPL-3.0——这是四个项目里最”强传染”的许可。AGPL 的网络条款意味着:如果你改了它的代码并通过网络提供服务,你需要向使用者提供修改后的源码。 这做内部平台没问题,做对外商业产品要非常谨慎。
二十三、平台类:四个值得二次开发的方向
23.1 KubeSphere —— 功能最全,但要先确认活跃度
定位:以 Kubernetes 为内核的分布式操作系统,走”可插拔 PaaS”路线。
能力范围:多租户、DevOps 流水线(Jenkins/自研 DevOps 引擎)、微服务治理(Service Mesh)、应用商店、日志/监控/告警、多集群管理、边缘节点。
为什么适合二次开发:
- 可插拔架构是它最大的优势:几乎所有组件都能通过 CRD 开关启用/禁用。这意味着你可以只要它的”多租户 + DevOps”,把其它模块摘掉。
- 国产项目,中文文档和社区支持对国内团队友好。
- 自带完整的可观测性栈,企业不需要从零拼装。
- 一键部署工具 KubeKey 支持离线安装,对私有化交付场景极有价值。
需要警惕的地方:
- 最近一次代码推送是 2026 年 7 月 15 日,到本文写作已三个月无更新。 这对一个平台级项目是明显信号,选型前必须再确认一次当前状态。
- 自定义许可证,商业闭源分发前需要法务确认。
- 社区版限制:单集群、最多 128 vCPU、3 个用户、3 个企业空间。企业版按 40 vCPU 授权计费(定价面向中国大陆)。
- 资源占用较大,小团队会觉得”太重”。
适合:有平台工程能力、想以它为骨架自建企业 PaaS 的中大型团队(金融、制造、政务)。
23.2 Rancher —— 多集群管理的标准答案
定位:**”多集群的舰队指挥官”**——统一管理成百上千个集群,无论它们在公有云、私有云还是边缘。
能力范围:集群供给与纳管、统一认证与 RBAC、应用目录(Helm + GitOps)、监控与告警、集群备份恢复。
为什么适合二次开发:
- Apache-2.0 标准许可,商业友好,二次开发展无许可障碍。
- 架构清晰:Rancher Server + 下游集群 Agent,边界明确。
- 社区最活跃、生态最成熟(26k Star,3.4k issue——issue 多不代表不好,代表用户多、场景多)。
- RKE2 / k3s 同属生态,可做私有化交付的技术底座。
需要警惕的地方:
- 它的强项是”管理入口”,不是”应用交付与租户治理”。如果企业的痛点已经升级到”发布、权限、审计、租户、运营”层面的分裂,Rancher 单独的解决力有限。
- 功能面广,单集群场景会觉得”杀鸡用牛刀”。
- 商业版(Rancher Prime)与社区版有功能分层。
适合:集群数量多且分散(跨云、跨地域、混合云)的运维型团队。
Rancher vs KubeSphere 的一句话区分:
1 | 痛点是"集群太散、入口太多" → Rancher |
23.3 KubeVela —— 想做”应用抽象层”时的首选
定位:OAM(Open Application Model)的参考实现,CNCF 孵化项目。它不是一个完整 PaaS,而是一套”把基础设施能力封装成开发者可消费的抽象”的引擎。
它的核心主张:
部署计划应该是一个可声明、可渲染、可编程的工作流对象,而不是一文件夹只在某个 CI 系统里能跑的 shell 脚本。
为什么适合二次开发:
- CUE 是它最独特的资产。CUE 是带约束的配置语言,不是字符串替换的模板引擎——能在到达集群之前就把配置错误查出来。这是它最强的设计论点。
- Definition 体系(ComponentDefinition / TraitDefinition / PolicyDefinition / WorkflowStepDefinition)让平台团队可以定义”我们公司的一个应用长什么样”,然后业务团队只写
type: webservice。 - 控制平面极轻:官方宣称单个 Pod、0.5c1g 资源就能处理上千个应用交付。它是一个渲染器和编排器,把实际工作交给已有组件。
- Apache-2.0,由阿里云 + 微软共同发起,现由 CNCF 托管,1500+ 贡献者。
references/目录里有一整套官方给的参考实现样板(CLI、APIServer、Appfile、CUE 代码生成、文档生成),这是为二次开发者准备的。
需要警惕的地方:
- CUE 是一把双刃剑。它有语言破坏性变更的历史,你会需要关注 CUE 版本和兼容开关(
extraEnvs控制CUE_EXPERIMENT)。仓库里曾在一个月内出现三个处理 CUE 兼容性的 PR——这不是缺点,而是告诉你:CUE 版本是你迟早要碰的旋钮。 - 学习曲线陡:OAM 的词汇量(Component / Trait / Policy / Workflow)不小。
- v1.11 于 2026 年 8 月 3 日 GA,发布节奏已从 2023-2024 的月更放缓到 2-3 个月一次。
适合:有”平台工程”诉求、想给业务团队提供自服务抽象、且有一定平台工程能力的团队。
一句话判断:如果你想要的是一个”已经长好的 PaaS”,选 KubeSphere / Rancher;如果你想要的是”造 PaaS 的引擎”,选 KubeVela。
23.4 Sealos —— 最激进的一条路线
定位:**”以 Kubernetes 为内核的云操作系统”**——不是在 K8s 之上建平台,而是把 K8s 本身当成操作系统内核,在上面跑”云应用”。
能力范围:集群一键部署(含离线)、应用商店(模板化部署数据库/中间件)、对象存储、数据库服务、AI 工作负载、Serverless。
为什么值得关注:
- 极其简单:
sealos run一条命令装好集群,对私有化交付是降维打击。 - 采用”集群镜像”的思路——把整个集群当作一个 OCI 镜像分发,这个设计很有原创性。
- 最近推送 10-19,活跃度在最前列。
- 自带应用商店,中小企业可以直接用,不需要自己攒组件。
需要警惕的地方:
- 自定义许可证,商业二次分发前需确认条款。
- 架构比较”重”,它想做的事太多,选它意味着接受它的一整套世界观。
- 深度定制的门槛比 KubeSphere 更高(因为它动的是 K8s 内核层)。
适合:追求快速交付、不想养大平台团队、需要”开箱即用 + 私有化”的团队。
23.5 不适合企业自建的三个:但很好用
| 项目 | 定位 | 为什么不适合”企业平台底座” | 但适合 |
|---|---|---|---|
| Coolify(PHP,★63.2k) | 自托管 Heroku | 它是给”部署项目”用的,不是给”治理多团队”用的 | 小团队自建 PaaS、个人服务器、快速上手 |
| Portainer(TS,★38.7k) | 容器管理 GUI | 聚焦 Docker/边缘场景,K8s 治理能力弱 | 边缘设备管理、Docker 主机管理 |
| Kubero(TS,GPL-3.0,★4.4k) | 轻量内部 PaaS | 规模上限低,GPL-3.0 传染性强 | 10 人以内的团队、想先看一眼内部 PaaS 长什么样 |
二十四、组件类:按目的选,不按热度选
平台类项目是”你要不要买一套房子”,组件类是”你要买哪些家具”。后者更常用到,也更容易选错。
24.1 增强控制器:OpenKruise 是必装项
OpenKruise(★5.4k,Go)是阿里云开源的云原生应用自动化引擎。它解决的是原生 K8s 在大规模应用运维上的短板:
| 能力 | 原生 K8s 的痛点 | Kruise 的答案 |
|---|---|---|
| 原地升级(InPlaceUpdate) | 滚动更新必须重建 Pod,IP 变化、镜像层要重拉 | 只重启容器,Pod 不变、IP 不变 |
| Sidecar 管理 | Sidecar 容器生命周期与主容器耦合,退出顺序难处理 | SidecarSet 独立管理,支持热升级 |
| 高级发布 | 只有 RollingUpdate / Recreate | CloneSet、Advanced StatefulSet、UnitedDeployment |
| 镜像预热 | 大批量扩容时所有节点同时拉镜像,Registry 被打爆 | ImagePullJob 提前把镜像推到节点 |
| 容器重启策略 | 只能按 Pod 级别重启 | ContainerRestartRules,容器级重启策略 |
2026 年的一个有趣变化:v1.35 把 In-place Pod Resize 和 ContainerRestartRules 都转正成了原生能力。也就是说,Kruise 的核心能力正在被上游吸收。
这反而是好事:说明这些能力是真实刚需。Kruise 的价值从”提供缺失能力”转向”在大规模场景下做得更好 + 提前提供完整工具链”。
判断:中大规模集群(>50 节点)建议装。 原地升级在几百个 Pod 的场景下能省下大量发布时间和镜像拉取带宽。
24.2 多集群:Karmada vs KubeEdge vs Cluster API
这三个名字里都有”集群/边缘”,但做的事完全不同:
1 | Cluster API → 管集群的"生命周期"(创建、扩容、升级、销毁) |
- Cluster API(★4.3k):把集群本身变成 K8s 对象。它的价值在私有化交付产品化和大机队管理——节点数量是
MachineDeployment的一个 replicas 字段,”要不要加机器”变成一次 PR。 - Karmada(★5.7k):兼容原生 API、对应用无侵入。适合真正需要多云/多集群编排的场景。
- KubeEdge(★7.6k):华为云发起,CNCF 边缘领域首个正式项目。适合工厂、零售门店、车联网这类边缘场景——边缘节点可能断网,KubeEdge 的 EdgeMesh 与边缘自治能力就是为这个设计的。
24.3 存储:Longhorn vs Rook
| 维度 | Longhorn(★8.0k) | Rook(★13.7k) |
|---|---|---|
| 底层 | 自研分布式块存储 | Ceph 的 K8s Operator |
| 上手 | 极简,UI 友好 | 需要理解 Ceph 概念(MON/OSD/MDS/PG) |
| 规模 | 中小规模(数十节点内) | 大规模、PB 级 |
| 功能 | 块存储为主 | 块 + 文件 + 对象三位一体 |
| 运维复杂度 | 低 | 高(Ceph 出问题排查很专业) |
判断:规模 < 50 节点选 Longhorn;需要对象存储或超过 PB 级选 Rook/Ceph;云上直接用云盘 CSI。
24.4 虚拟机:KubeVirt 的差异化价值
KubeVirt(★7.1k,Go)让你在 K8s 里以 Pod 的形式管理虚拟机。它解决的真实问题是:
存量系统容器化改造不动时,怎么办?
很多企业的老系统(Windows 服务、依赖特定内核模块的遗留应用、某些商业中间件)在短期内不可能容器化。KubeVirt 让这些虚拟机和容器运行在同一个调度平面上,共享同一套网络、存储、CI/CD 和运维体系。
这是”遗留系统现代化”最现实的一条路,比”要么全容器化、要么全留在物理机”这个二选一要好得多。
24.5 安全:Trivy + Cosign 是最小可行组合
- Trivy(★38.5k):2026 年容器安全扫描的默认选择。它不只是扫镜像漏洞,还能扫 IaC 配置(Terraform、K8s YAML)、生成 SBOM、扫密钥泄露。单二进制,无依赖,CI 里集成成本极低。
- Cosign(★6.4k):Sigstore 的签名工具,支持 keyless 模式(基于 OIDC 身份),不需要管理私钥。
这两个组合起来就是一套完整的供应链安全最小方案:构建时扫描 → 签名 → 部署时验证签名。
二十五、二次开发的三条路径与决策树
25.1 先问:你到底要改到哪一层
二次开发的成本差异巨大,取决于你在哪一层动手:
| 层次 | 做法 | 成本 | 风险 |
|---|---|---|---|
| L0 使用层 | 直接用,写配置 | 极低 | 无 |
| L1 集成层 | 通过 API / CRD 集成到自有系统 | 低 | 低,官方支持的路径 |
| L2 扩展层 | 用插件/Definition 机制扩展能力 | 中 | 中,依赖扩展机制的稳定性 |
| L3 源码层 | Fork 后改源码 | 高 | 高,从此被上游更新节奏绑定 |
绝大部分”二次开发”需求应该落在 L1 和 L2。 只有在开源项目的能力确实与你的业务模式冲突时,才考虑 L3。
一旦选择 L3,就要接受三个长期成本:
- 每次上游发版都要做一次合并(可能持续冲突)。
- 你的团队必须深入理解这个项目(否则改不动)。
- 招聘门槛提高(要有懂这个项目的工程师)。
25.2 二次开发选型的决策树
1 | 问题 1:你要解决的是"集群管理"还是"应用交付"? |
25.3 一条最实在的建议
不要因为”看起来很厉害”就引入一个平台级项目。
平台级项目(KubeSphere、Rancher、KubeVela、Sealos)一旦引入,就是一个长期的、有人力成本的承诺。引入之前先问:没有它,我们最痛的那件事能不能用 200 行 YAML + 一个 CronJob 解决?
很多团队的真实答案是”能”。而”能用简单方案解决”这件事,本身就是最珍贵的。
第六部分 · 路线图、趋势与结语
二十六、落地路线图:五个阶段,每个阶段都有明确的验收条件
企业上容器最常见的失败模式是一次性铺开——三个月建好平台,然后发现没人用。下面这条路线图的每一阶段都设了验收条件,条件不满足就不该进入下一阶段。
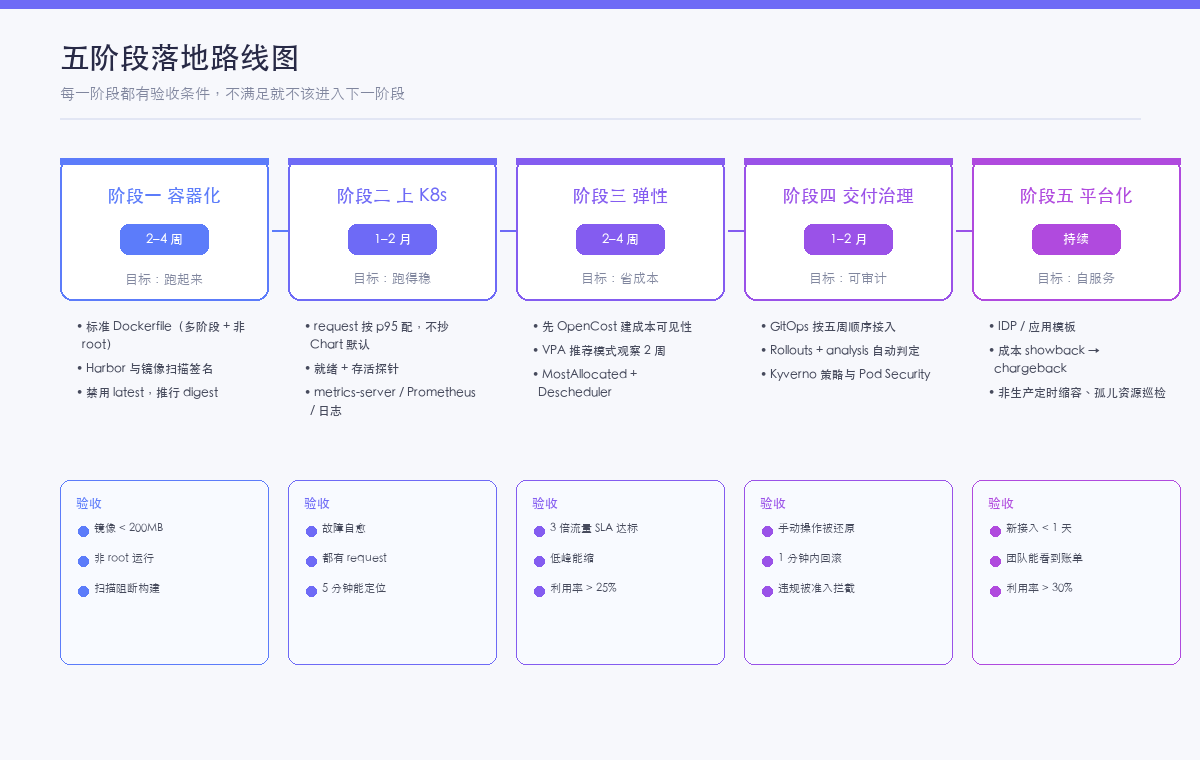
阶段一:容器化(2–4 周)
目标:让应用能跑在容器里,且镜像是干净的。
- 为每类应用建立标准 Dockerfile(多阶段构建 + 非 root + 最小化基础镜像)。
- 搭建 Harbor 或与现有镜像仓库打通。
- 建立镜像扫描与签名流水线。
- 定义命名规范与标签策略(禁用 latest,推行 digest)。
验收条件:
1 | ✓ 核心应用的镜像 < 200MB(Java 应用 < 400MB) |
阶段二:上 K8s(1–2 个月)
目标:应用能在 K8s 上稳定运行,具备基本自愈能力。
- 建设/选型集群(推荐云托管起步)。
- 建立命名空间与 RBAC 模型。
- 配置 requests/limits 与 LimitRange(从这一刻起就按 p95 配,别抄 Chart 默认值)。
- 配置探针(就绪 + 存活)。
- 部署 metrics-server、Prometheus、日志采集。
- 配置 PDB 与 topologySpreadConstraints。
验收条件:
1 | ✓ 节点重启后服务自动恢复,无需人工介入 |
阶段三:弹性(2–4 周)
目标:流量能自动应对,且成本不失控。
- 先部署 OpenCost,建立成本可见性(这一步必须在配 HPA 之前)。
- 用 VPA 推荐模式观察 2 周,按建议修正 request。
- 配置 HPA(扩得快、缩得慢)。
- 异步链路接入 KEDA。
- 节点层:云上 Karpenter / 私有云 Cluster Autoscaler。
- 调度器改为 MostAllocated + 部署 Descheduler。
验收条件:
1 | ✓ 压测到 3 倍流量时系统自动扩容且 SLA 达标 |
阶段四:交付与治理(1–2 个月)
目标:发布变成受控的、可审计的、可回滚的流程。
- 搭建 GitOps(Argo CD / Flux),按五阶段顺序接入。
- 接入渐进式发布(Argo Rollouts),配置 analysis 自动判定。
- 落地 Kyverno 策略:资源、探针、标签、签名、特权。
- 命名空间打上 Pod Security 标签。
- 密钥方案落地(SOPS / External Secrets)。
验收条件:
1 | ✓ 生产环境的手动 kubectl 操作会被自动还原 |
阶段五:平台化与优化(持续)
目标:让业务团队自助,让成本持续优化。
- 建设内部开发者平台(IDP)或应用模板体系。
- 把成本 showback 推给业务团队,逐步过渡到 chargeback。
- 非生产环境定时缩容、孤儿资源巡检自动化。
- 按需引入 KubeSphere / Rancher / KubeVela 等平台层。
- 多集群(如确实需要)。
验收条件:
1 | ✓ 新业务接入平台的时间 < 1 天 |
二十七、八类典型坑:每一条都烧过钱
| # | 坑 | 现象 | 对策 |
|---|---|---|---|
| 1 | request 抄 Chart 默认值 | 集群利用率 8%,节点越加越多 | 按 p95 配,Web 服务从 100m–250m 起步;上 LimitRange |
| 2 | PDB 配置错误 | 节点永远缩不下去,机器一直在计费 | 单副本服务不配 minAvailable: 1;缩容问题先查 PDB |
| 3 | 没有就绪探针 | 流量打到还没启动完的 Pod,发布期大量 5xx | 强制配置 readinessProbe,用 Kyverno 卡准入 |
| 4 | Ingress NGINX 未迁移 | 入口组件没有安全更新 | 迁 Gateway API,这是 2026 年必做项 |
| 5 | HPA 和 VPA 抢同一指标 | 副本数震荡,配置被反复覆盖 | VPA 只用推荐模式;一个字段只能有一个主人 |
| 6 | 孤儿 PVC | 删了应用,云盘还在计费 | 定期巡检;StorageClass 用 Delete 回收策略 |
| 7 | Java 容器内存配置错误 | 容器内存明明没超,Pod 却被 OOM Kill | 用 -XX:MaxRAMPercentage=75 而不是 -Xmx;request=limit |
| 8 | 直接在生产上 kubectl | 热修复被流水线静默回滚,45 分钟定位时长 | GitOps 自愈;生产写权限收口到仓库 |
第 7 条值得展开。Java 应用在容器里的 OOM,90% 的原因不是”内存真不够”,而是 JVM 不知道自己在容器里:
1 | # 错误:JVM 看到的是宿主机内存,会申请超出容器 limit 的堆 |
-XX:MaxRAMPercentage=75 的含义是”堆最多占容器内存限额的 75%”,剩下的留给元数据区、线程栈、直接内存。而硬编码 -Xmx4g 在 limit 设为 2Gi 的容器里必然 OOM。
JDK 16+ 默认已支持容器感知,但堆大小仍建议用百分比形式表达,这样调整容器 limit 时不需要同步改 JVM 参数。
二十八、未来五年:六个判断及依据
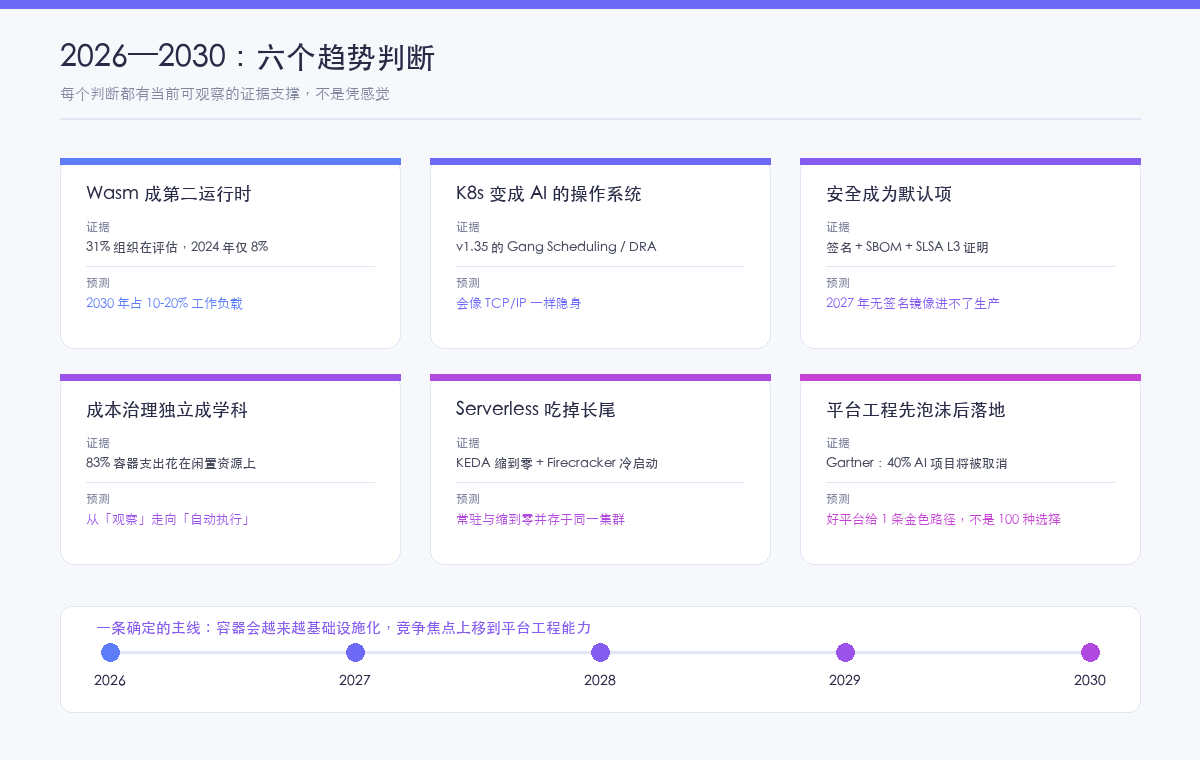
预测是危险的,但下面六个判断都有可观察的当前证据支撑,不是凭感觉。
判断一:Wasm 会成为”第二运行时”,但不会取代容器
现状证据:
- CNCF 的 2026 调查显示,31% 的组织在评估 Wasm 作为特定工作负载的容器替代方案——**2024 年这个数字只有 8%**。
- 冷启动:Wasm 1–10ms,容器 50–200ms。体积:Wasm 模块通常是等效 Docker 镜像的 1/10 到 1/100。
- 生态已成型:WebAssembly 3.0 于 2026 年 6 月发布,WASI 0.3.0 原生支持 async,Component Model 已稳定。
- KubeCon EU 2026 的共识是:”用 Wasm 补容器太重、太宽、太贵的短板,而不是取代它。”
判断:
1 | 2027 年:Wasm 在边缘计算、插件系统、AI 推理三个场景成为默认选择 |
为什么不是取代:Wasm 的语言支持受限(Rust、TinyGo、C/C++ 成熟,Python/Java 需转换),线程与系统调用生态薄弱,且防不住容器逃逸型的内核 CVE——它和容器共享宿主内核。需要硬件隔离的场景仍然要靠微虚拟机。
判断二:Kubernetes 会变成”AI 的操作系统”,并且越来越像”看不见的底座”
现状证据:
- v1.35 把 AI/ML 负载当作一等公民:Gang Scheduling、DRA 可分区设备、In-place Resize。
- 生产 AI 系统本身就是混合负载:突发的训练 + 稳定的推理 + 数据管道。这三种工作负载需要统一的调度、治理与策略面。
- Gartner 预测:到 2027 年底,超过 40% 的 agentic AI 项目会被取消,主因是成本失控、价值不清、风险控制不足。
判断:
1 | K8s 正在从"容器的编排器"变成"混合工作负载的操作系统" |
“越来越看不见”不是坏事,而是技术成熟的标志。真正的问题是:当 K8s 隐身之后,企业竞争的焦点会转移到它上面的那一层——平台工程能力。
判断三:安全从”加分项”变成”默认项”,且以供应链为核心
现状证据:
- 2026 年主流发行版已默认 cgroup v2、Seccomp、容器镜像签名。
- Kyverno / Sigstore 的普及速度远超几年前的 OPA Gatekeeper。
- Docker Hardened Images 这种”自带 SBOM + SLSA L3 来源证明”的基础镜像成为免费开源产品。
- v1.35 把 User Namespaces 推进 Beta、KMS v3 转正、RBAC Conditions 进入 Beta。
判断:
1 | 2027 年:没有签名的镜像将无法进入合规企业的生产集群 |
判断四:成本治理会成为独立学科,且工具会从”观察”走向”自动执行”
现状证据:
- 集群 CPU 利用率从 10% 降到 8%,浪费在变差而不是变好。
- 只有 14% 的组织真正做了 chargeback。
- 83% 的容器支出花在闲置资源上。
- 各大云厂商 2026 年已普遍提供容器成本分析产品。
判断:
1 | 成本工具会经历三个阶段: |
这里有个必须警惕的方向:如果优化工具在 request 还是虚高的时候自动执行,它只会规模化错误。 自动化之前必须先有正确的输入。
判断五:Serverless 容器会吃掉长尾场景
现状证据:
- KEDA 的
minReplicaCount: 0和 HTTP Add-on 已经让”缩到零”变得可用。 - Firecracker / Cloud Hypervisor 让 Serverless 的冷启动降到 100–200ms。
- 各大云厂商的 Serverless 容器产品(如 Fargate、Cloud Run、函数计算)在快速成熟。
判断:
1 | 长尾服务(低频、内部、异步)会大规模转向 Serverless 容器 |
判断六:平台工程会取代”运维”成为主流组织形态,但会先经历一轮泡沫
现状证据:
- 三个平台类项目(KubeSphere、Rancher、KubeVela)都在争夺”企业平台底座”这个位置。
- KubeVela 的核心论点(把部署计划变成可声明的工作流对象)正是平台工程的典型主张。
- Gartner 的 40% AI 项目取消率,本质上是”缺乏可重复的上生产路径”。
判断:
1 | 2027-2028:平台工程会经历一轮泡沫——很多团队建了 IDP 但没人用 |
关于”金色路径”的判断依据:开发者不想要选择,他们想要的是”做完这一步就能上线”。提供 100 个选项的平台,实际效果是让每个团队都自己造了一套轮子——这恰恰是容器化的初衷要解决的问题。
结语:回到那三个词
文章写到这里,可以回到开头的判断。
容器的难点从来不是”跑起来”,而是 **”跑得便宜、跑得稳、跑得可控”**。
- 跑起来:
docker run一条命令。这是 2013 年就解决的问题。 - 跑得便宜:需要正确的 request、MostAllocated 调度、Karpenter 整合、缩到零、以及持续的成本治理。这需要组织纪律,不只是工具。
- 跑得稳:需要探针、PDB、拓扑分布、渐进式发布、自动回滚。这需要理解”故障是常态”。
- 跑得可控:需要 GitOps、策略即代码、镜像签名、审计留痕。这需要接受”人的直接操作是风险源”。
后三个词构成的工作,永远不会完结。
最后给不同角色各留一句:
给应用开发者:你不需要精通 K8s,但你至少要知道三件事——你的容器 request 是多少、你的探针配没配、你的镜像有多大。这三件事直接决定了你的服务在半夜会不会被 OOM、发布时会不会 5xx、扩容时能不能及时起来。
给平台工程师:不要先买工具,先修 request。顺序错了,工具只会帮你规模化浪费。另外,能不引入的平台就不引入——你维护的每一个组件,都要有人能在半夜处理它。
给技术管理者:容器平台项目的失败,80% 死在组织问题上(租户模型、权限归属、成本归属、团队能力),而不是技术选型上。先回答那四个组织问题,再谈 K8s 版本。
技术会继续演进:Wasm 会进来,AI 负载会挤进来,Serverless 会切走长尾,K8s 会越来越像一个看不见的底座。但有两件事十三年没变过:
- 容器仍然只是被限制了视野和配额的普通进程。
- 声明式 API 的核心仍然是”让实际状态向期望状态收敛”这个朴素循环。
理解了这两件事,后面无论再加多少层抽象,都不会迷失。
本文数据来源于:CNCF 官方博客与 Kubernetes v1.35 发布说明、Cast AI 2026 State of Kubernetes Optimization Report(23,000+ 集群遥测)、Datadog State of Cloud Costs、以及 2026 年 10 月 19 日直接从 GitHub API 获取的 50 个开源项目实时数据。行文中的集群利用率、运行时分布等结论均可回溯至上述公开报告。
 微信
 支付宝
欢迎来到李苟蛋的个人博客,对本站的文章和技术问题有疑问或建议,欢迎留言,或者关注我的公众号:狗蛋的智栈