从「AI 世界的 USB-C」到被公开弃用?2026 是 MCP 的黄昏还是重生?
序言
2025 年 12 月 9 日,Anthropic 把 MCP(Model Context Protocol)捐给了 Linux 基金会新成立的 Agentic AI Foundation,与 OpenAI、Block 共同发起,Google、微软、AWS、Cloudflare、Bloomberg 站台支持。当时的说法很漂亮:MCP 是「AI 世界的 USB-C」。生态数据也撑得起这个说法——9700 万次月 SDK 下载,200 多个 server。
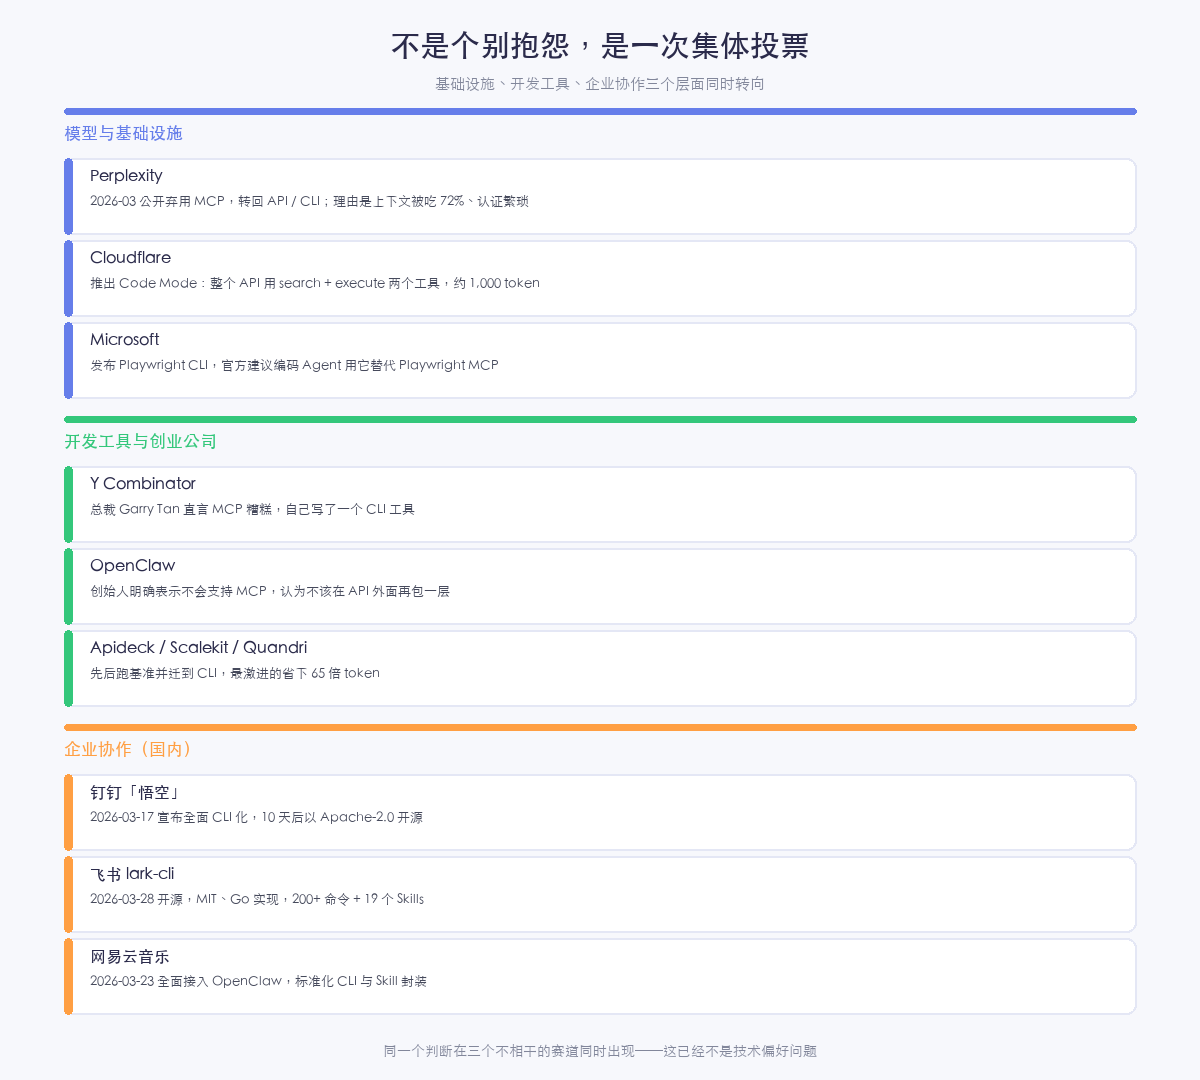
四个月后,2026 年 3 月 11 日,Perplexity CTO Denis Yarats 在 Ask 2026 大会上公开宣布:公司正在放弃 MCP,转回传统 API 和命令行。理由给得很直接——MCP 会吃掉高达 72% 的上下文窗口,认证流程也太繁琐。
从「行业标准」到「大客户公开弃用」,中间只隔了四个月。
同一时期,微软发布了 Playwright CLI 并建议开发者用它替代 Playwright MCP;YC 总裁 Garry Tan 说「MCP 说实话很糟糕」,然后自己写了个 CLI;国内的钉钉、飞书在 10 天内先后完成 CLI 化并把代码开源;网易云音乐接入 OpenClaw,走的是标准化 CLI 加 Skill 封装。
社区很快总结出一句口号:MCP 已死,CLI 当立。
这个判断对了一半。这篇文章想把这半对和半错的地方分清楚:
- 到底哪些公司在转向? 是彻底弃用,还是改造、替代、或者只是给用户多一个选项?这三件事差别很大。
- token 到底多花了多少? 我把公开基准里的实测数字汇总了一遍,从 4 倍到 65 倍都有。
- MCP 会不会被完全替代? 我的判断是不会,但它会退到一个完全不同的位置上。这个位置在哪,是本文的重点。
一、18 个月,风向转了一个完整的弯
先把时间线钉住,因为很多讨论的混乱都来自时间点错位。
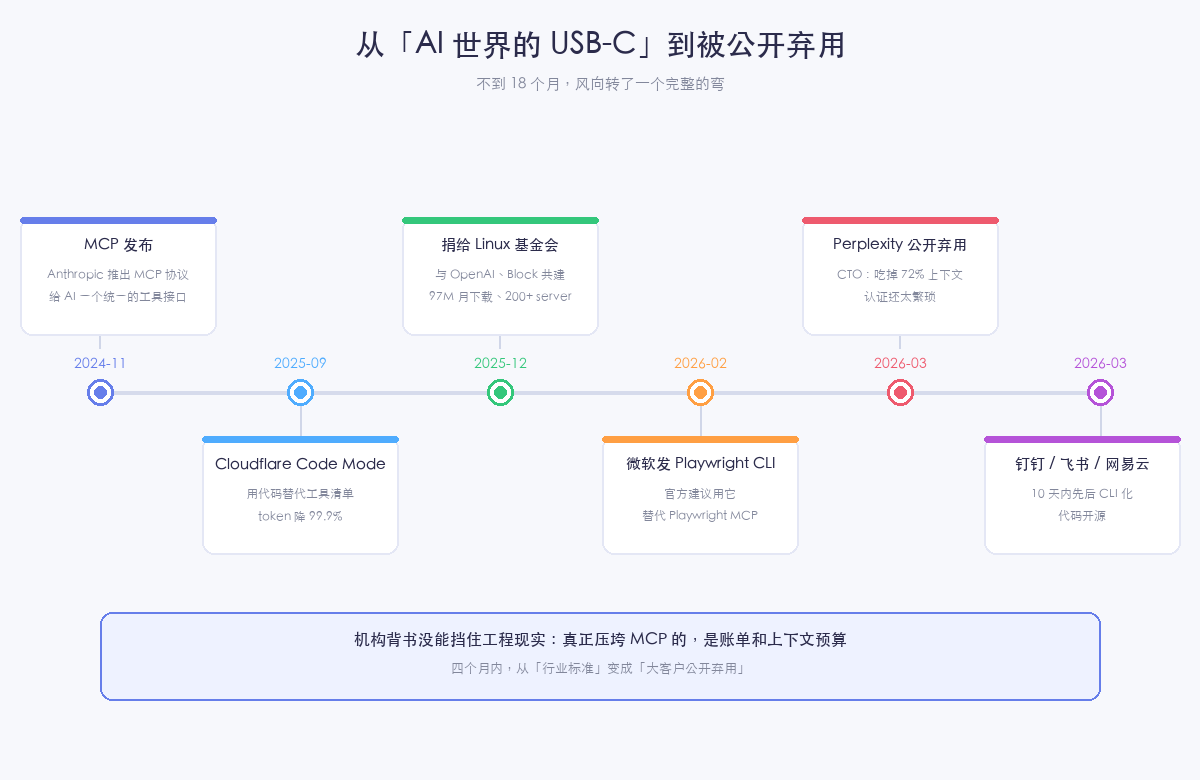
| 时间 | 事件 |
|---|---|
| 2024-11 | Anthropic 发布 MCP,给 AI 一个统一的工具调用接口 |
| 2025-09-26 | Cloudflare 发布 Code Mode,用两个工具覆盖整个 API,约 1,000 token |
| 2025-11-04 | Anthropic 发布高级工具调用(Tool Search / 程序化调用),作为官方补救 |
| 2025-12-09 | MCP 捐给 Linux 基金会 Agentic AI Foundation |
| 2026-02 | Perplexity 悄然上线 Agent API;微软发布 Playwright CLI |
| 2026-03-11 | Perplexity CTO 在 Ask 2026 公开宣布弃用 MCP |
| 2026-03-17 | 钉钉「悟空」宣布完成全面 CLI 化 |
| 2026-03-23 | 网易云音乐全面接入 OpenClaw,标准化 CLI |
| 2026-03-27 | 钉钉 CLI 以 Apache-2.0 开源,首批开放 10 项核心能力 |
| 2026-03-28 | 飞书 lark-cli 开源(MIT、Go),200+ 命令 + 19 个 Skills |
看清这条线,会发现一个有趣的结构:MCP 拿到制度性背书的那一刻,它的问题已经在生产环境里暴露了。
Cloudflare 的 Code Mode 比 Anthropic 的官方补救早了一个多月,两家在完全独立的情况下得出了同一个结论:把工具清单塞进上下文这件事,从根上就不该这么做。 Cloudflare 9 月 26 日发布,Anthropic 11 月 4 日跟进,两篇博客互相引用——这是典型的技术压力下并行发现,不是谁抄谁。
顺带说一个容易被忽略的事实:MCP 那时已经有 1.3 万个 server,平均每个开发者连 4 到 7 个。这个数字很关键——它说明问题不是「有人配错了」,而是「默认用法就会出问题」。
二、到底谁在弃用?要把四种情况分开
标题里的「弃用」是个笼统说法。真去看各家做的事,至少能分成四类,混在一起谈就失真了。
第一类:真的弃用,换回 API / CLI
Perplexity 是最明确的一个。CTO 在公开场合给了两条理由:上下文被吃掉 72%、认证机制笨重。他们在 2026 年 2 月先上线了 Agent API(一个端点路由 OpenAI、Anthropic、Google、xAI、NVIDIA 的模型,OpenAI 兼容语法),一个月后才公开宣布弃用 MCP。先有替代品再宣布,节奏很稳。
Y Combinator 的 Garry Tan 更早开炮,说法是「MCP 说实话很糟糕」,然后自己动手写了个 CLI 工具,理由是生产系统需要的是可靠性和速度。
OpenClaw 创始人 Vincent Koc 明确表示不会支持 MCP。他的比喻值得记一下:MCP 是「server to serve a server」——API 本身已经是服务器了,为什么还要在外面再包一层?
第二类:不弃用协议,但把协议重写
Cloudflare 是最容易被误读的一家。它没有弃用 MCP,而是用 Code Mode 重写了自己的 MCP server:整个 Cloudflare API(2,500 多个端点)只暴露 search() 和 execute() 两个工具,常驻约 1,000 token。
对照数字很刺眼:
| 方案 | 工具数 | Token 开销 |
|---|---|---|
| 原生 MCP(全量 schema) | 2,594 | 约 1,170,000 |
| 原生 MCP(仅必填参数) | 2,594 | 约 244,000 |
| Code Mode | 2 | 约 1,000 |
这是 99.9% 的降幅。但注意,Cloudflare 仍然在说 MCP——只是换了一种实现方式。它证明的是「MCP 的默认实现方式有问题」,而不是「MCP 这个协议没用」。
第三类:官方给一个替代品,让用户自己选
微软 2026 年初发布 Playwright CLI,官方仓库里的表述是:CLI 调用更省 token,因为它避免了把庞大的工具 schema 和冗长的可访问性树加载进模型上下文;MCP 仍然推荐给需要持久状态和丰富自省的探索式 agent loop。
这是最值得学的一种态度:不是宣布谁死,而是说清楚各自适合什么。同一家公司、同一个团队,先后给了两份答卷——2024 年的 MCP 假设「LLM 看不到工具之外的世界」,所以每次动作后必须把页面状态塞回去;2026 年的 CLI 假设「Agent 有 shell、有磁盘」,所以数据落盘,要看自己读。
第四类:干脆不走协议路线,直接 CLI 化
钉钉 2026-03-17 发布「悟空」平台,宣布全面 CLI 化改造完成;10 天后 CLI 代码以 Apache-2.0 开源,首批开放 10 项核心能力,原生支持 Claude Code、Cursor 这类环境。
飞书 2026-03-28 开源 lark-cli,MIT 协议、Go 实现,200+ 条命令覆盖消息、文档、多维表格、日历、邮箱、会议,配 19 个 Agent Skills。
网易云音乐 2026-03-23 全面接入 OpenClaw,做标准化 CLI 与自动化 Skill 封装。
三家分属企业办公、协同工具、音乐流媒体三个完全不相干的赛道,在同一个月份做了同一件事:把自己的产品压扁成命令行,从「只有人能用」变成「Agent 能调」。
这个现象比任何基准数字都有说服力。用 Karpathy 回复 Box CEO Aaron Levie 那篇《Building for trillions of agents》时的话说:
「If you build it, they will come.」现在你去任何一家公司,他们还在用传统界面给你下指令——让你导航到某个网页、点某个按钮、在某个输入框里填东西。这突然让人觉得很粗鲁。你为什么要告诉我该怎么操作?请直接给我一个能复制粘贴给 Agent 的东西。
「很粗鲁」这个词选得很准。它说的是:GUI 是给人设计的,而 Agent 需要的是一行能执行的意图。
三、MCP 到底错在哪:三个结构性缺陷
先说清楚一点:批评 MCP 不等于它没有价值。在工具数量有限、环境可控、需要强类型约束的场景里,MCP 确实带来确定性。问题出在把它当成通用工具连接层、让它承载几十个工具的真实工作流时。
① Token 通胀:schema 是常驻的
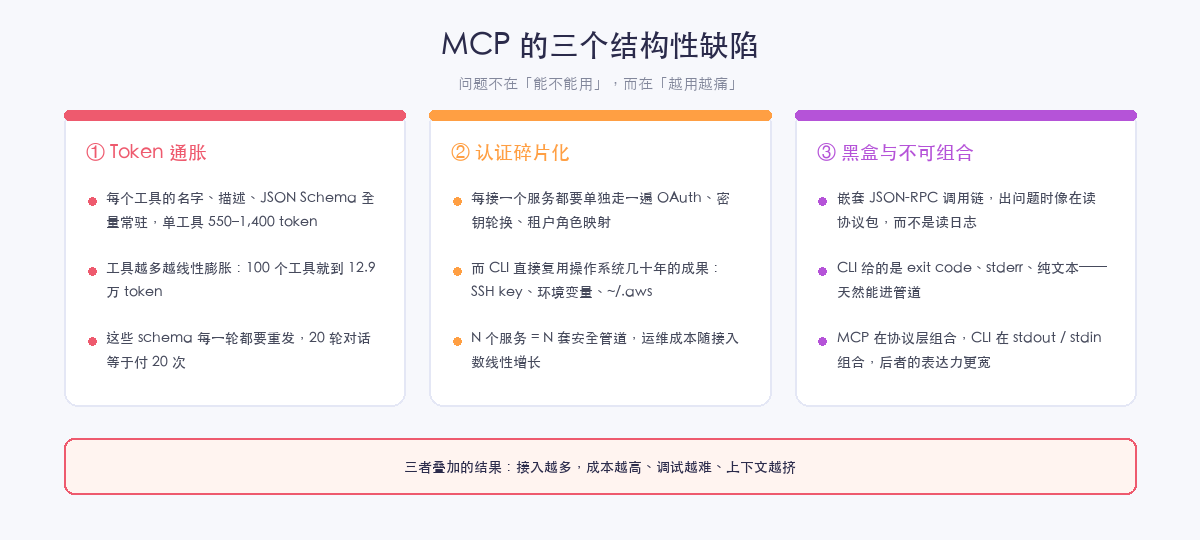
这一条是根子上的。机制值得讲透,因为它解释了后面所有数字。
模型是无状态的。 每次请求都要带上完整的画面:system prompt、工具定义、全部对话历史。不存在「模型上次已经知道我的工具了」这回事。
所以流程是这样:客户端在每个连接上的 server 调用 tools/list,收集每一个工具的名字、描述、完整 JSON Schema,然后全部注入请求。一个你六个月没调用过的工具,照样在每一轮被发送一次。
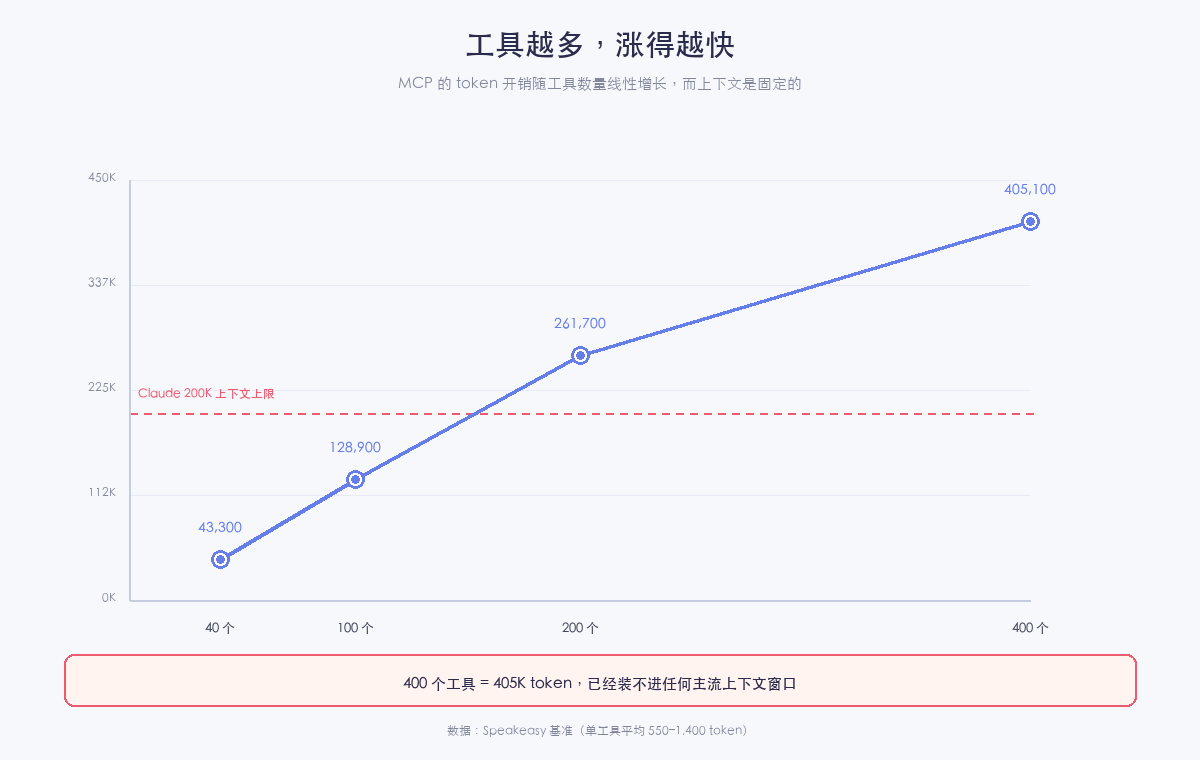
单个工具的开销是 550–1,400 token——名字、描述、JSON Schema、字段说明、枚举值、系统指令都得算进去。工具一多就是线性膨胀:
- 40 个工具 → 43,300 token
- 100 个工具 → 128,900 token
- 200 个工具 → 261,700 token
- 400 个工具 → 405,100 token
而 2026-07-28 版的规范还引入了完整的 JSON Schema 2020-12 支持(oneOf / anyOf / allOf / $ref)。表达力确实更强了,schema 也确实更大了。
有一个反直觉的细节:prompt caching 能省钱,但省不掉上下文空间。缓存过的 token 更便宜,可它占的位置一点没少。而位置才是稀缺资源——每一个没用上的工具 schema,都是你的文档、代码库、对话历史拿不到的空间。
② 认证碎片化:每个服务一套管道
MCP 的架构是「模型 ↔ MCP 服务 ↔ 工具」,每接一个服务,就要单独处理一遍:OAuth 流程、API key 轮换、租户角色映射、环境隔离。
而 CLI 直接复用了操作系统几十年攒下的东西:
- SSH key 与 ssh-agent
- 环境变量(
GITHUB_TOKEN、AWS_ACCESS_KEY_ID) - 本地配置文件(
~/.ssh/config、~/.gitconfig、~/.aws/credentials) - 标准 Unix 权限模型
Perplexity 把「认证流程繁琐」和「上下文浪费」并列作为弃用理由,说明这两件事在他们的实际成本里是同一个量级的。
③ 黑盒与不可组合
MCP 用嵌套的 JSON-RPC 通信。出问题时,你得把长长的请求/响应链复原出来,在脑子里搭一个状态机。
CLI 给的是:exit code 告诉你成没成,stderr 告诉你为什么失败,纯文本随时能 grep、能 diff、能进 CI 日志。
组合能力的差别更本质:MCP 在协议层组合(拼 JSON 字段),CLI 在 stdout / stdin 层组合(管道、重定向、脚本)。 后者的表达力宽得多,而且不需要为「组合」这件事再设计一套规范。
有人把这种落差总结成一句话:MCP 把开发者变成「协议包工程师」,CLI 让他们留在熟悉的地方——文本流和管道里。
附加一条:性能
Quandri 团队拿 Jira MCP server 和 Jira REST API 直接对比过:单次调用 MCP 慢 3 倍,首次调用慢 9.4 倍,差距来自初始化开销。
这是架构决定的:每个 MCP server 都在模型和真正的 API 之间插了一个额外进程层。Linear、Notion、Slack 的 server 同样如此。
四、token 到底差多少:把数字摆出来
这是全文最实在的一节。下面每一个数字都标了来源,因为它们来自不同团队、不同任务形态,绝对值不能横向比较,倍数关系才是重点。
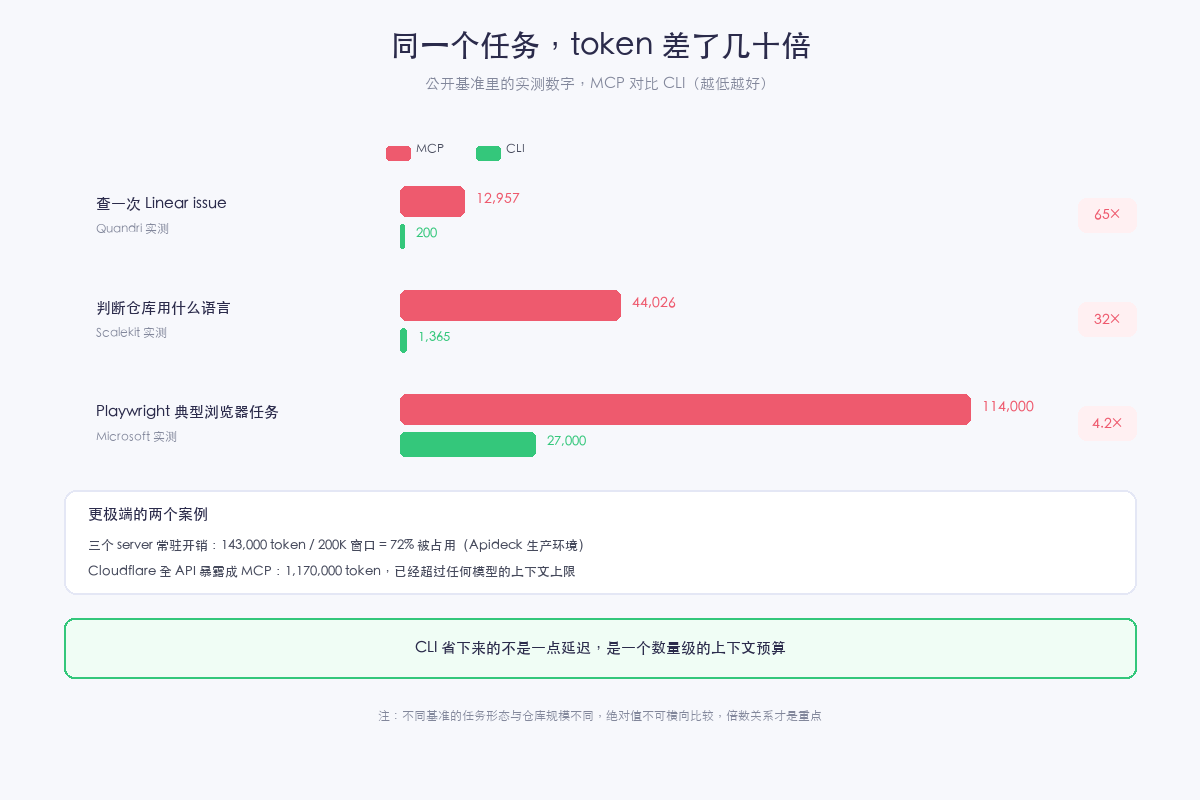
| 场景 | MCP | CLI | 倍数 | 来源 |
|---|---|---|---|---|
| 查一次 Linear issue | 12,957 | 约 200 | 65× | Quandri |
| 判断仓库用什么语言 | 44,026 | 1,365 | 32× | Scalekit |
| Playwright 典型浏览器任务 | 114,000 | 27,000 | 4.2× | Microsoft |
| Cloudflare 全 API 接入 | 1,170,000 | 约 1,000(Code Mode) | 99.9% 降幅 | Cloudflare |
再看总量侧的三个数字:
- **三个 server 常驻就吃掉 72%**:Apideck 的生产环境里,GitHub + Slack + Sentry 三个 MCP server 在对话开始前就消耗了 143,000 / 200,000 token。剩下的 57,000 要同时装下对话、检索到的文档和推理过程。
- 七个 server 是 67,300 token,占 200K 窗口的 33.7%。这是社区在 2025 年 11 月对 Claude Code 做的实测。单个 server 的量级参考:Filesystem 约 3,500、Notion 约 9,000、GitHub 约 18,000–26,000。
- Anthropic 自己承认过 134,000:官方在讲 Tool Search 时提到,「在优化之前,我们看到工具定义消耗了 134K token」。
还有一个特别值得看的对照——Anthropic 官方给的五个 server 拆分:
| Server | 工具数 | Token |
|---|---|---|
| GitHub | 35 | 约 26,000 |
| Slack | 11 | 约 21,000 |
| Sentry | 5 | 约 3,000 |
| Grafana | 5 | 约 3,000 |
| Splunk | 2 | 约 2,000 |
| 合计 | 58 | 约 55,000 |
58 个工具,55,000 token,对话还没开始。再加上 Jira(单独就要 17,000),很快就奔着 10 万去了。
换算成钱是多少
有个粗算值得放在这里:一个 10 server、每天 10 次对话的部署,大约浪费 1,370 美元 / 开发者 / 年。
这个数字因模型定价和缓存命中率而浮动,不必当精确值看。但它说清了为什么这是商业模型问题而不是工程审美问题:几千个开发者、几十次日常对话,乘起来就是实打实的成本,直接影响损益表。
一个必须说的公道话
上面的对比有一个隐含前提:MCP 的 schema 是「全量预加载」的实现。 这不是协议的硬性要求,而是当时所有主流客户端的默认做法。Anthropic 后来加了 Tool Search 之后,这个前提就变了。
所以看这些数字时,要问一句:对比的是「MCP 协议」还是「MCP 的一种特定实现」? 大部分批评文章没说清这一点,这也是「MCP 已死」这个结论站不住脚的原因之一。
五、不只更贵,还更不准
这是整件事里最容易被忽略的一层。大多数团队把它当成本问题处理,其实它首先是质量问题。
工具越多,选得越错
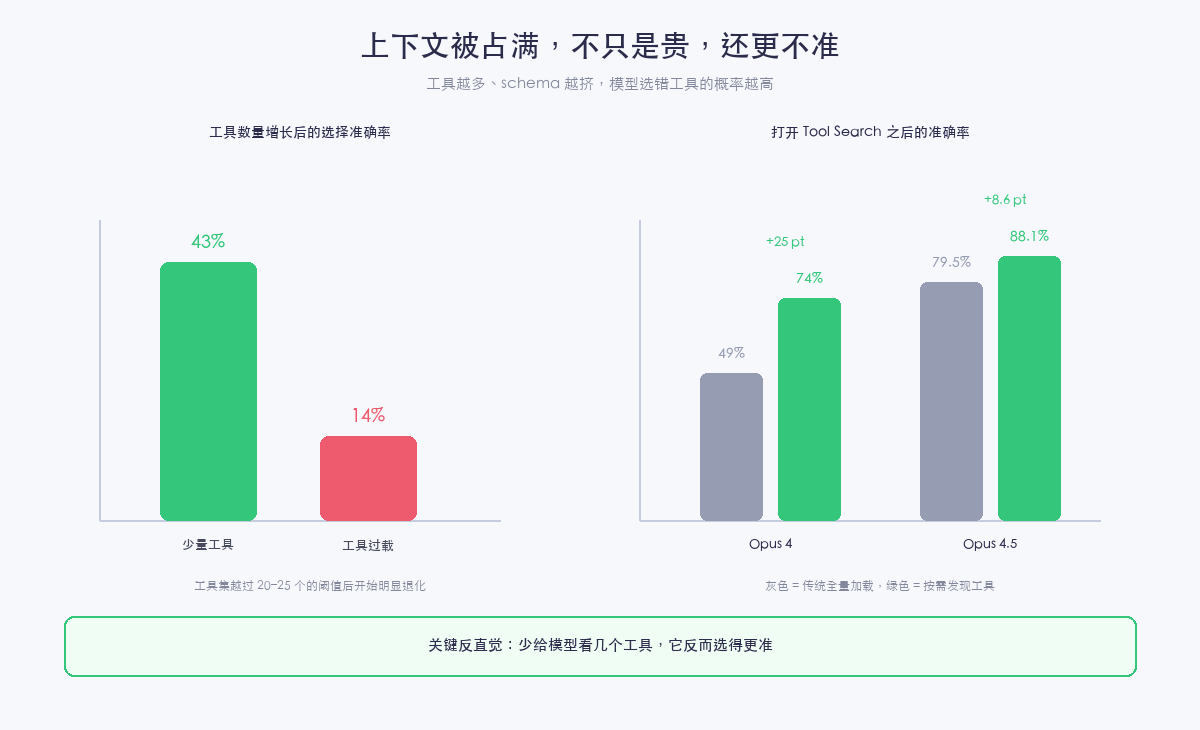
「Less is More」(arXiv:2411.15399)那篇研究给出了一个阈值:工具数量超过 20–25 个之后,选择准确率开始明显退化。生产环境的遥测数据更狠——随着工具集膨胀,准确率从 43% 掉到 14%,三倍劣化。
MCP-Atlas:失败的 56.7% 都出在工具使用
Scale AI 和新加坡国立大学合作的 MCP-Atlas 基准,跑了 1,000 个任务、36 个真实 MCP server。主结论很扎眼:
- 56.7% 的 agent 失败,属于「工具使用失败」——选错工具、参数构造错、或者没能正确串联
- 最常见的一种失败叫「没有调用任何工具」,占全部失败的 36%
- 模型通过率:Claude Opus 4.5 是 62.3%,GPT-5 是 44.5%,GPT-4o 只有 7.2%
「没调用工具」这个失败模式特别有解释力:当一个 agent 花了 70% 的上下文读工具说明书,它连「该动手了」这件事都判断不准。
反直觉的解法:少给几个工具,反而更准
Anthropic 在推 Tool Search 时公布了一组内部数据,我第一遍看的时候以为看错了:
- Claude Opus 4:49% → 74%
- Claude Opus 4.5:79.5% → 88.1%
减少可见工具的数量,准确率是上升的。 机制其实好理解:工具越少,相似命名造成的混淆越少(比如 notification-send-user 和 notification-send-channel 这种),动态选出来的工具也更贴合当前任务。
这条结论的价值超出了 MCP vs CLI 的争论:「把所有能力都摆到模型面前」这个思路本身,在工具规模超过某个阈值之后就是负收益的。 不管底层用的是什么协议。
六、CLI 为什么像 Agent 的「母语」
这里要澄清一个误解:CLI 的复兴不是复古,也不是「把老工具重新包装一遍」。
四个结构性的便宜
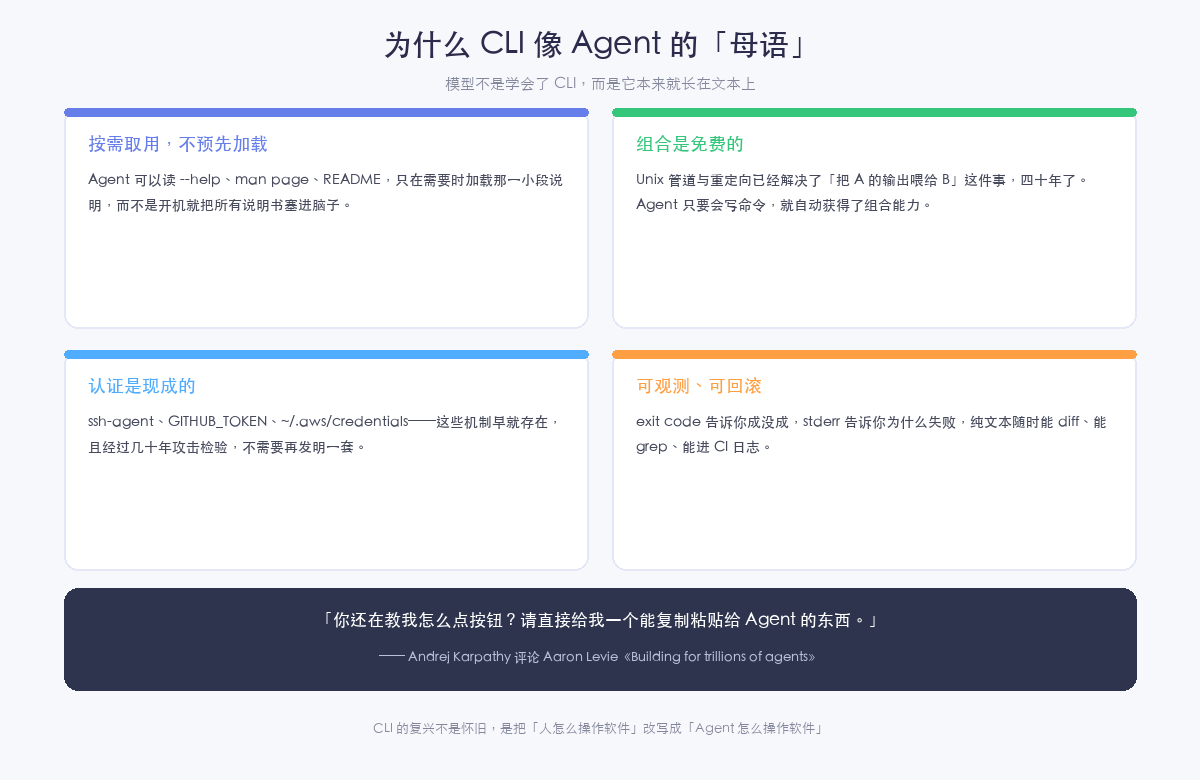
① 按需取用,不预先加载。 Agent 可以读 --help、man page、README,只在需要时加载那一小段说明。这和「开机把所有说明书塞进脑子」是两种成本结构。
② 组合是免费的。 Unix 管道与重定向已经解决「把 A 的输出喂给 B」这件事四十年了。Agent 只要会写命令,就自动获得了组合能力——不需要再为组合设计一套规范。
③ 认证是现成的。 ssh-agent、GITHUB_TOKEN、~/.aws/credentials——这些机制早就存在,而且经过了几十年的攻击检验。
④ 可观测、可回滚。 exit code 说成没成,stderr 说为什么失败,纯文本随时能 diff、能 grep、能进 CI 日志。
现在的 CLI 不是你以为的那个 CLI
「AI 原生 CLI」是一套特意为 Agent 重新设计过的东西,和给人用的 CLI 有明确区别:
- 不是 GUI 套壳,直连底层能力,绕过图形界面
- 没有交互式弹窗,全参数执行——避免 Agent 卡在一个「请确认 Y/N」上直到超时
- 输出结构化(
--json、--yaml),AI 直接可解析 - 自带
--dry-run预览、--mock测试、权限沙箱这类 Agent 专属设计
飞书的 lark-cli 能开出 200+ 条命令、配 19 个 Skills,说明这不是「凑合能用」的接口,而是当产品在做。
Playwright 那组对比最能说明问题
同一个团队、同一个引擎,两种哲学,数字差 4 倍:
| 维度 | Playwright MCP | Playwright CLI |
|---|---|---|
| 通信方式 | 持久 MCP 连接(JSON-RPC) | 无状态 shell 命令 |
| 数据流 | 结果直接注入模型上下文 | 写入磁盘,Agent 按需 Read |
| Token 成本 | 约 114,000 / 典型任务 | 约 27,000 / 同任务 |
| 工具数量 | 21–26 个(受上下文预算限制) | 命令不受限 |
| 状态自省 | 每步返回完整可访问性树 | Agent 主动 snapshot 到文件 |
| 运行前提 | 任何支持 MCP 的宿主 | 必须有文件系统 + shell |
4 倍的差距从哪来?MCP 每次点击后必须把最新页面状态原路奉还,一棵可访问性树常常几 KB 到几十 KB,十步操作就是几万 token,长会话里像滚雪球。CLI 只把数据写到 page.yaml,Agent 要看就 Read,不看就无事发生。
用一句中国话讲:MCP 是「藏书楼,要求来人过目不忘」,CLI 是「借阅处,用时取之」。
七、六维正面对照
| 维度 | MCP | CLI |
|---|---|---|
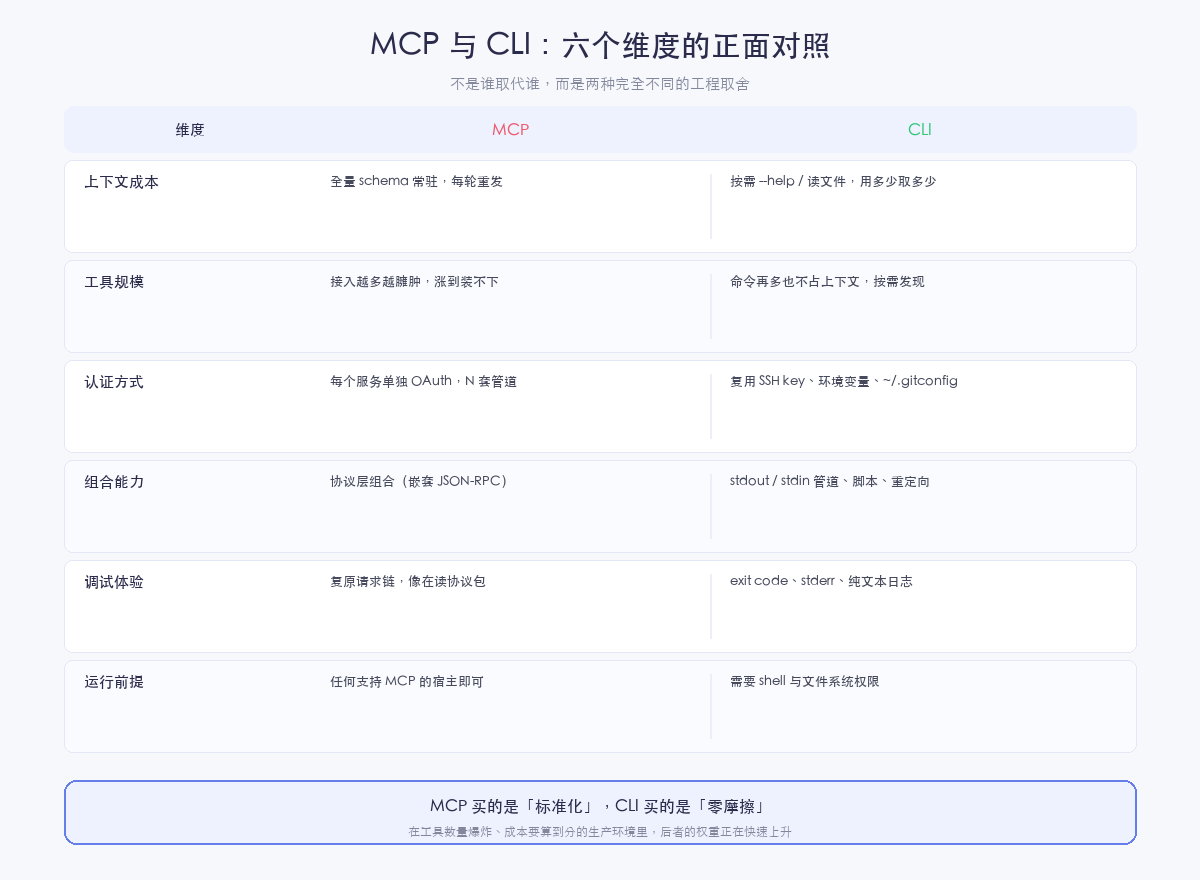
| 上下文成本 | 全量 schema 常驻,每轮重发 | 按需 --help / 读文件 |
| 工具规模 | 接入越多越臃肿,会涨到装不下 | 命令再多也不占上下文 |
| 认证方式 | 每个服务单独 OAuth,N 套管道 | 复用 SSH key、环境变量、配置文件 |
| 组合能力 | 协议层组合(嵌套 JSON-RPC) | stdout / stdin 管道、脚本、重定向 |
| 调试体验 | 复原请求链,像读协议包 | exit code、stderr、纯文本日志 |
| 运行前提 | 任何支持 MCP 的宿主即可 | 需要 shell 与文件系统权限 |
最后一行是 CLI 的硬约束,不能忽略:sandbox 严格的宿主里,CLI 根本跑不起来。 Claude Desktop 这类纯聊天界面没有文件系统、没有 shell,MCP 是唯一选择。
所以「MCP 还是 CLI」这个问题本身就带着错误的预设——它俩不在同一个赛场。MCP 买的是一致性和可治理性,CLI 买的是零摩擦。
八、MCP 没有坐等:三条自救路线
这是很多「MCP 已死」的文章完全跳过的部分。协议侧在 2025 年底到 2026 年给出了三套工程解法,而且都有公开数据。
① Tool Search:按需发现
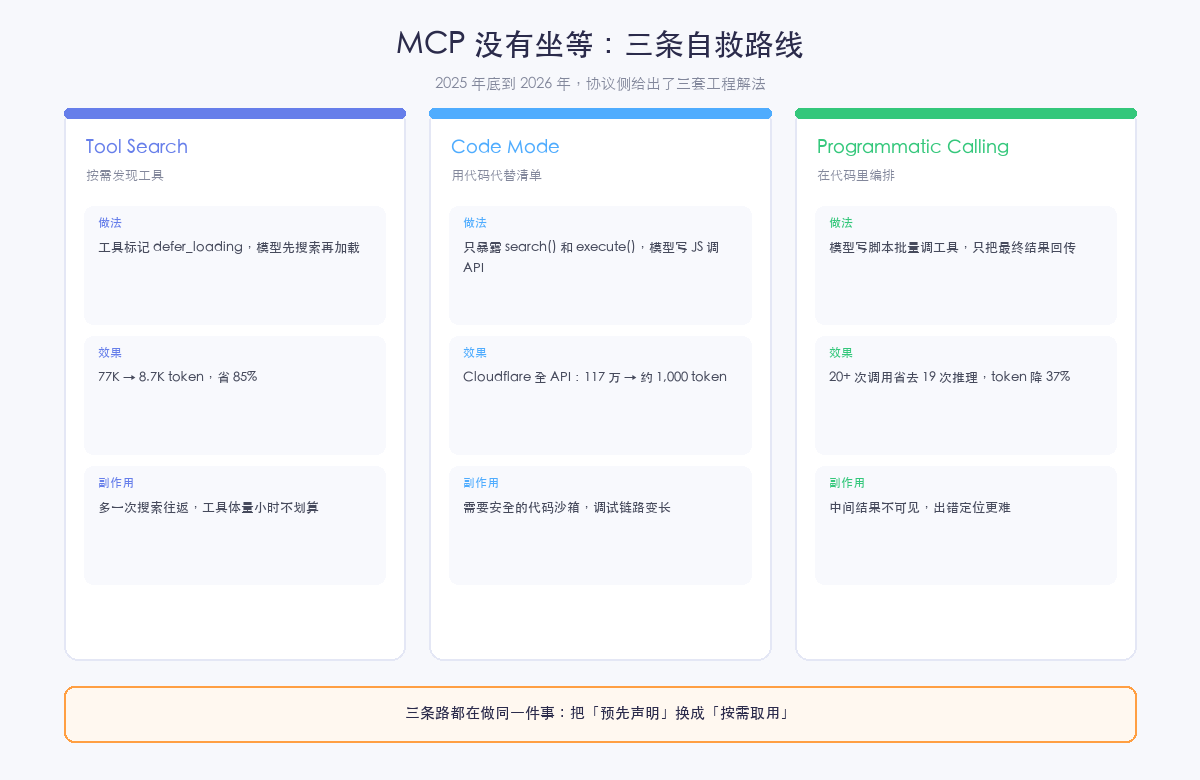
做法:工具标记 defer_loading: true,不预先加载。模型先搜索(regex 或 BM25),匹配到的工具才展开完整定义。
效果:传统方式 72K token 起步;Tool Search 后初始只有约 500 token,搜索后再加载 3–5 个相关工具(约 3K),总计 **8.7K,省 85%**。而且不破坏 prompt caching——延迟加载的工具根本不在初始 prompt 里。
代价:多一次搜索往返。工具体量小的时候(比如就 5 个工具)不划算。
我特别欣赏这个方案的一点:它顺手解决了准确率问题。上面那组 49%→74%、79.5%→88.1% 就是这条路的副产品。
② Code Mode:用代码代替清单
做法:只暴露 search() 和 execute() 两个工具,模型对着类型化的 SDK 写 JavaScript,代码在沙箱(Cloudflare 是 Dynamic Worker 隔离环境)里执行。
效果:Cloudflare 全 API(2,500+ 端点)从 117 万 token 降到约 1,000 token,**降幅 99.9%**。而且这个占用是固定的——API 再加 500 个端点,token 不变。
代价:需要安全的代码执行沙箱;调试链路变长(出错时你要看的是生成的代码,不只是工具调用)。
③ Programmatic Tool Calling:在代码里编排
做法:模型写 Python 去编排工具调用,中间结果留在沙箱里,只把最终结果回传。
效果:20+ 次工具调用可以省掉 19 次以上的推理往返,复杂研究任务 token 降 37%。Claude for Excel 就是靠它在不撑爆上下文的前提下处理几千行的表格。
代价:中间过程不可见,出错定位更难。
三条路的共同点
把三个方案放在一起看,会发现它们在说同一件事:
把「预先声明」换成「按需取用」。
这恰好就是 CLI 的默认行为。所以严格说,MCP 的自救方向,是向 CLI 的工作方式靠拢——只不过保留了协议带来的标准化与治理能力。
这个观察对后面那个「会不会被完全替代」的判断很关键。
九、MCP 会被完全替代吗?
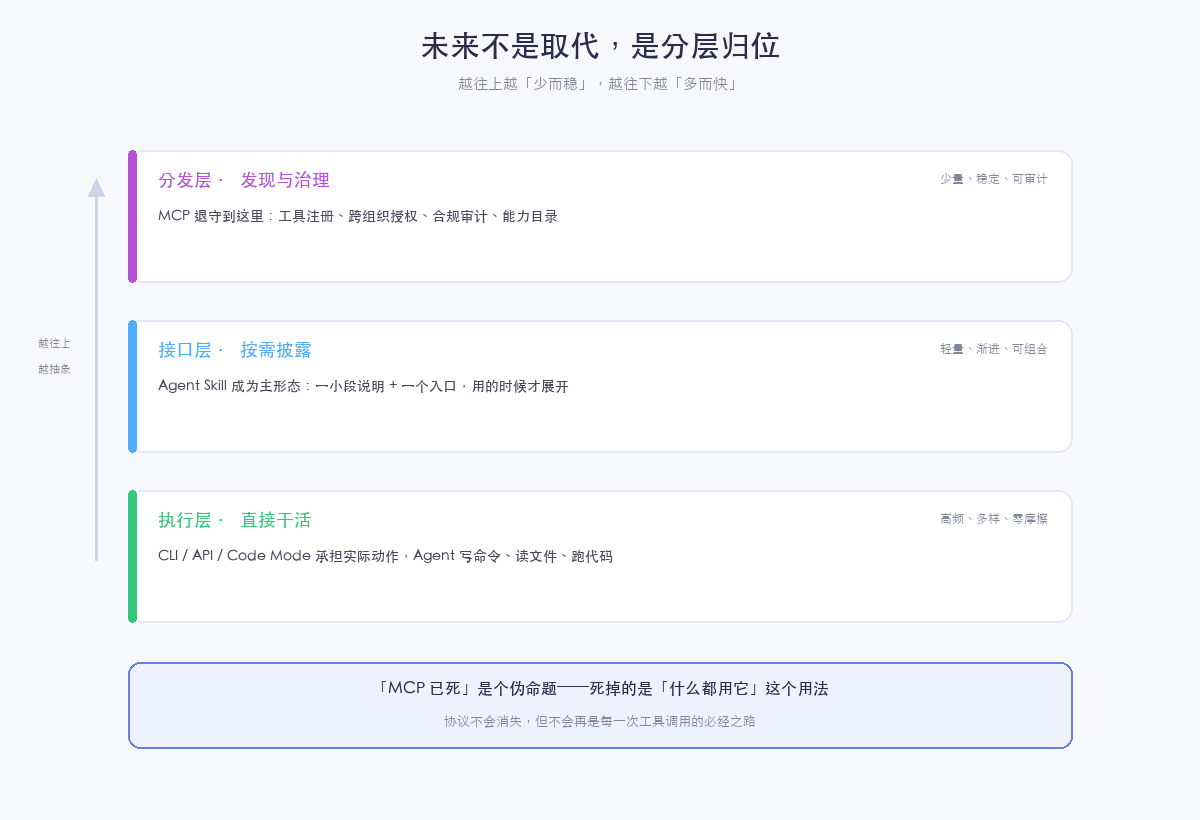
我的判断是:不会完全替代,但它会从一个位置退到另一个位置。而且这个位置调整,对整个生态是好事。
先说会失去什么
它会失去「每一次工具调用的必经之路」这个地位。
过去一年很多团队的做法是:只要能包成 MCP,就包成 MCP。结果是连「查一下 git 状态」这种一条命令的事,也要过一遍协议。这种用法会被清掉,而且是应该被清掉的。
默认选项会从 MCP 变成 CLI 或 Skill。 只要 agent 能访问 shell,CLI 就是更便宜的起点。这个趋势不可逆,因为成本差异是数量级的,不是百分比。
再说会保留什么
有四类场景,MCP 仍然是更好的答案:
① 没有 shell 的环境。 纯聊天界面、浏览器端、严格 sandbox。这里没有文件系统,CLI 无从谈起。
② 本来就没有 CLI 的服务。 大量 SaaS 只有 HTTP API,没有命令行工具。给它包一层 MCP,比让 agent 自己拼 HTTP 请求加鉴权要稳。
③ 需要跨团队统一认证与审计。 MCP 原生带 OAuth 2.1,能做细粒度权限管控。当「谁授权了这个 agent、它能访问什么数据」成为合规问题时,这一层的价值会上升,不是下降。
④ 跨组织的工具分发。 这是 MCP 最被低估的价值:它是唯一一个「别人写好的工具,我能直接装」的机制。 CLI 没有这个能力——你不能 npm install 一个命令就指望 agent 会用,还得配 Skill、写说明、处理认证。
一个常被忽略的证据
如果 MCP 真的要死了,Cloudflare 不会花力气用 Code Mode 重写自己的 MCP server。它大可以直接砍掉 MCP 支持,只留 REST API。
它没有。它选择了「保留协议、换掉实现」。
这个选择的含义很清楚:协议层的价值(标准化、发现、治理)和实现层的问题(schema 全量加载)是可以分开处理的。而 Anthropic 的 Tool Search 恰好证明了后者能修。
所以更准确的描述是:被弃用的是「MCP 的默认实现方式」,不是「MCP 这个协议」。 只是在口语里,这两件事被压缩成了一个词。
还有一个反向信号
MCP 生态并没有萎缩——2026 年 5 月的生态报告里,server 数量超过 13,000 个,平均每个开发者连 4 到 7 个。数字还在涨。
涨的同时被批评,这两件事并不矛盾:接入数在涨,是因为「能接」这件事变容易了;被批评,是因为「接了之后」的成本开始显形。 这是任何基础设施都会经历的阶段——先解决「能不能」,再解决「贵不贵」。
十、我对 AI Agent 通信趋势的六个判断
下面是预测部分,我会给出判断依据,你可以不同意,但至少知道我是从哪推的。
判断一:会分成三层,各管各的
- 执行层(多而快):CLI、HTTP API、Code Mode。agent 在这里写命令、读文件、跑代码,追求零摩擦。
- 接口层(轻而可组合):Agent Skill。一小段说明 + 一个入口,用的时候才展开,天然是渐进式披露。
- 分发层(少而稳):MCP。工具注册、跨组织授权、合规审计、能力目录。
判断依据:这三层解决的是三个不同的问题(怎么执行、怎么描述、怎么分发),而现在的争论把它们混成了一场「谁赢」的比赛。一旦分开看,各层的胜负就没那么重要了。
这三层,就是 2026 年 AI Agent 工具接入的三条路线:能跑 shell 就用 CLI 干活,要复用流程就写 Skill,要跨组织分发与治理才上 MCP。 三条路不是三选一,而是同一套系统里的三个位置。
判断二:Skill 会成为主流的封装形态
Skill 的本质是渐进式披露:平时只占几十个 token 的描述,被调用时才展开完整说明。Playwright CLI 的 skill 描述约 68 token,对比 MCP 26 个工具的完整 schema 约 3,600 token 起——两个数量级的差别。
判断依据:飞书 200+ 命令配 19 个 Skills、Apideck 用 80 token 的 prompt 替代几万 token 的 schema、Quandri 用 Skills 包住 CLI 省下约 21,000 token 上下文。三家独立做同一件事,说明这个形态是对的。
判断三:「代码即工具」会变成默认
模型写代码调 API,比模型逐个调用工具更省——这几乎成了共识。Cloudflare 的 Code Mode、Anthropic 的 Programmatic Tool Calling,两家独立得出同一结论,时间差不到两个月。
判断依据:代码天然能表达循环、条件、数据变换,这些用「工具调用」表达要么做不到,要么要调用很多次。而每次调用都是一次完整的推理 pass。
判断四:文件系统会成为 Agent 的「外部记忆」
Playwright 的对比给了最好的证据:同样一件事,把结果写进上下文是 114K token,写进磁盘按需读是 27K。
判断依据:磁盘是免费的、无限的、可 diff 的、可版本化的;上下文是昂贵的、有限的、易失的。把「状态」和「上下文」分开,是所有长期运行的 agent 都必须做的事。
判断五:认证会回归操作系统
每个服务一套 OAuth 的做法,在工具数量到几十个之后就不成立了。CLI 复用 ssh-agent、环境变量、~/.aws 这套东西,不是因为它先进,而是因为它已经被几十年的攻击检验过。
判断依据:安全领域有一个规律——不要自己发明认证管道。MCP 被迫在协议层重新实现一遍,本身就是一种成本。
判断六:多 Agent 之间会有独立协议,但和工具接入选型无关
这里要区分两件事:
- Agent 与 Agent 通信(一个 agent 委托另一个 agent 干活):这块会更依赖 A2A 这类协议,因为它要解决的是任务委派、能力协商、结果回传。
- Agent 与工具/资源通信(agent 操作外部系统):这块正在往 CLI / API / Skill 收敛。
判断依据:现在很多讨论把这两件事混在一起,导致「MCP 要不要 A2A」这种问题被反复问。它们服务的是不同的通信对象,长期看会各自演化,不会合并。
一句总结
协议不会消失,但「什么都走协议」的时代结束了。
未来更可能是:Agent 用 CLI 干活、用 Skill 知道怎么干、用 MCP 发现和治理能干什么。
十一、现在该怎么选
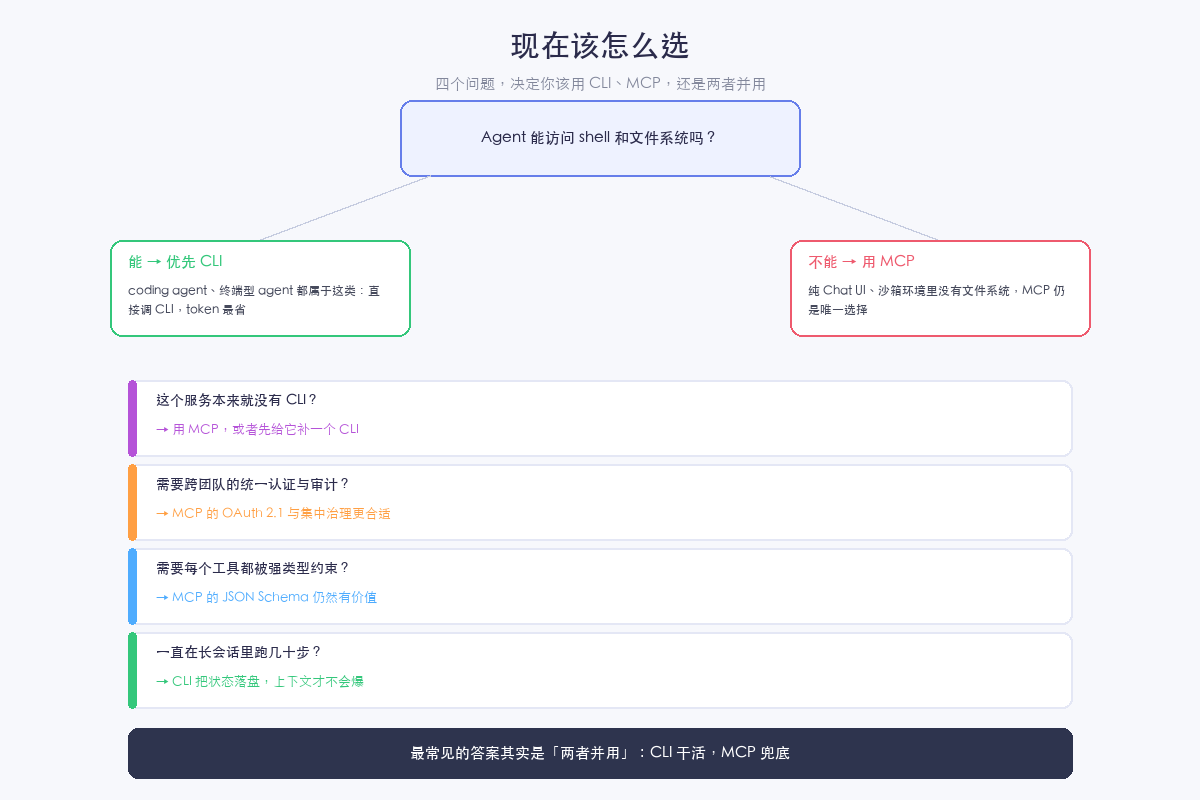
四个问题,按顺序问:
Q1:Agent 能访问 shell 和文件系统吗?
- 能 → 优先 CLI。coding agent、终端型 agent 都属于这类,token 最省。
- 不能 → 用 MCP。纯 Chat UI、沙箱环境里没有文件系统,MCP 仍是唯一选择。
Q2:这个服务本来就没有 CLI?
→ 用 MCP,或者先给它补一个 CLI(长期看更划算)。
Q3:需要跨团队的统一认证与审计?
→ MCP 的 OAuth 2.1 与集中治理更合适,尤其是在合规压力大的场景。
Q4:需要每个工具都被强类型约束?
→ MCP 的 JSON Schema 仍然有价值,这是它相对 CLI 的真实优势。
如果你要迁,这张清单能省几天
- 先量,再动。 用 tiktoken 数一遍你每个 server 的
tools/list输出,别凭感觉。多数团队第一次量完都会吓一跳。 - 优先迁这几类:有成熟 CLI 的(git、gh、aws、kubectl)、高频短任务的、长会话里跑几十步的。
- 保留这几类:没有 CLI 的 SaaS、需要统一认证的内部系统、跨组织分发的工具。
- 不要两套并存。 同一项目里既装 MCP 又装 CLI 做同一件事,agent 会陷入选择困难,表现为在两种调用之间来回切。
- 如果暂时不能迁,先开 Tool Search。 一行
defer_loading: true能省 85%,这是性价比最高的动作。 - 把常用命令写进 CLAUDE.md 或项目说明里。 agent 不知道你的项目用哪套 CLI,你得告诉它。
写在最后
回头看这一年的转向,最有意思的不是「谁赢了」,而是判断标准变了。
2025 年选工具接入方案,问的是「标不标准、生态大不大」。2026 年问的是「一次调用花多少 token、出错时我看不看得懂」。
这个变化背后是一个很朴素的事实:当 agent 真的开始干活,账是要算到分的。
但我不认为这是 MCP 的失败。它解决了一个真实的问题——N 个应用乘 M 个工具的组合爆炸,在 MCP 之前确实没有好答案。它只是在解决这个问题的过程中,把一个次要成本(schema 的上下文开销)放大成了主要成本,然后在真实规模下被发现了。
任何基础设施都会经历这个过程:先跑通,再算账,然后重写。
MCP 现在在第三步。Tool Search 和 Code Mode 都是重写的开始,不是结束。
所以那句话可以改得更准确一点:
死掉的不是 MCP,是「把一切都塞进上下文」这个直觉。
而这个直觉的死亡,对所有人都好。
数据口径说明:本文的 token 基准、准确率数据与项目时间线来自以下公开来源——Scalekit、Quandri、Apideck、Microsoft Playwright 官方仓库与文档、Cloudflare Code Mode 官方博客(2025-09-26)、Anthropic《Introducing advanced tool use》(2025-11-04)、Speakeasy 基准、MCP-Atlas(Scale AI 与新加坡国立大学)、arXiv:2411.15399「Less is More」,以及 2026 年 5 月的 MCP 生态报告。抓取与核对时间为 2026-10-17。各家基准的任务形态、仓库规模、模型版本不同,绝对值不可横向比较,倍数关系与趋势才具备参考意义。文中对未来的判断为个人观点,已标注判断依据。
 微信
 支付宝
欢迎来到李苟蛋的个人博客,对本站的文章和技术问题有疑问或建议,欢迎留言,或者关注我的公众号:狗蛋的智栈