企业级智能助手 RAG 搭建指南:从原理到落地,一次讲透
序言
大模型火了这几年,很多企业的第一个落地场景都是「智能问答助手」:把内部文档、规章制度、产品手册喂给大模型,让员工或客户直接提问。
但直接拿大模型当问答机器人有两个致命问题:知识截止日期(训练数据是旧的,上个月新发的报销制度它不知道)和幻觉(不知道也不说不知道,一本正经地编一个看起来很专业的答案)。RAG(Retrieval-Augmented Generation,检索增强生成)就是当前解决这两个问题的主流方案——先从企业知识库里检索出相关内容,再把检索结果连同问题一起交给大模型作答。
这篇文章不打算只讲「怎么搭」,而是像讲一门技术那样把它讲透:先讲清楚它为什么有效、企业都在拿它干什么,再拆开原理看六大组件,然后横向对比向量库、Embedding 模型和 GitHub 上的一堆开源知识库,最后给出一个能直接跑的本地 Demo 和一套智能客服的落地数据,顺带泼点冷水,聊聊它现在还有哪些坑、未来会走向哪。
说明:本文涉及的行业收益数据来自公开的技术文章与实践分享(如各类 RAG 落地案例报道),属于量级参考,不同业务基线差异很大,请结合自己的数据复测。
一、先建立全局认知:RAG 到底是什么
一句话概括:RAG 是「搜索 + 大模型摘要」的工程化组合。它不改变模型本身,而是让模型在回答之前先「翻资料」。
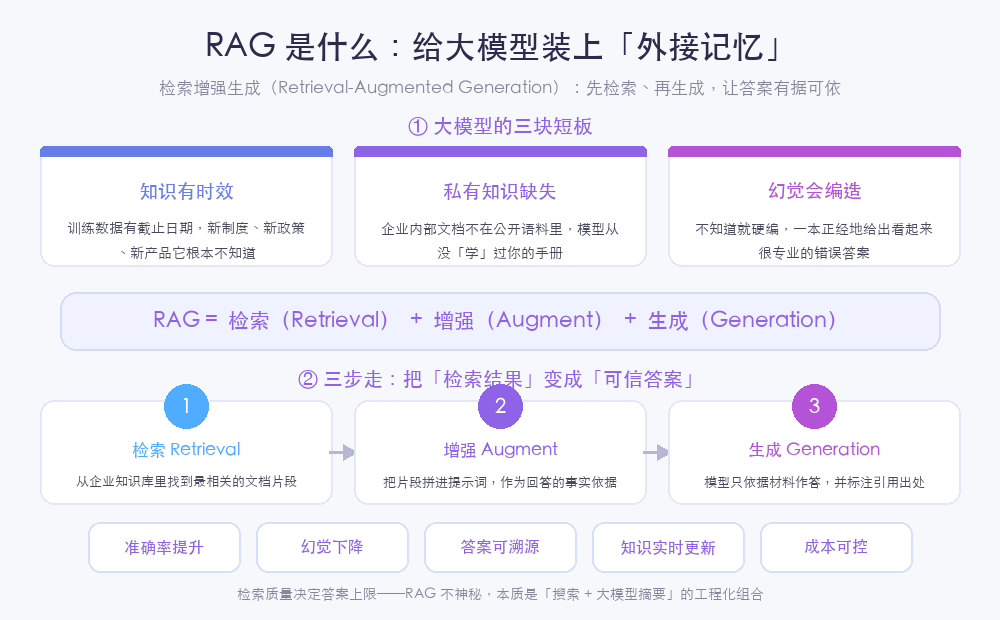
整个链路可以拆成三步:检索(Retrieval) 从知识库找回最相关的片段 → 增强(Augment) 把片段拼进提示词作为事实依据 → 生成(Generation) 模型只依据材料作答并标注出处。
1.1、RAG 与微调:不是二选一,而是分工不同
这是最常被搞混的一个问题。很多人以为「要模型懂我的数据」就该去微调,其实两条路解决的是完全不同的需求:
| 维度 | RAG(检索增强) | 微调(Fine-tuning) |
|---|---|---|
| 解决什么 | 注入事实知识 | 改变行为/风格/格式 |
| 知识更新 | 实时,重新灌库即可 | 需重新训练,周期长 |
| 成本 | 低,只需向量库 + 推理 | 高,单次训练约 $500~$10,000 起 |
| 可解释性 | 强,能给出引用出处 | 弱,黑盒 |
| 幻觉控制 | 强(有据可依) | 有限 |
| 实施周期 | 基础版 2 |
4~8 周起 |
| 适用场景 | 知识密集型问答、文档检索、合规问答 | 品牌语气、创意写作、特定输出格式 |
一句话记法:知识问题用 RAG,能力问题用微调。企业助手 90% 的需求是知识问答,所以 RAG 是首选;两者也可以叠加——用微调定语气,用 RAG 保事实。
1.2、一个必须先纠正的误解
RAG 不能彻底消除幻觉。 在搭建良好的系统里,幻觉率通常能从 15%30% 降到 3%8%,但模型仍可能误读检索到的上下文、错误拼接片段,或者「顺着材料往下编」。所以生产环境必须配齐护栏、引用校验和置信度评分——「诚实地说不知道,比编一个答案更值钱」。
1.3、什么时候反而不该用 RAG
- 语料很小(总量不到十万 token):直接塞进长上下文窗口,比搭一套 RAG 更简单;
- 需要的是模型「风格」而非「事实」:那应该微调;
- 问题高度依赖实时计算(如「我现在账户余额多少」):应该走 API / SQL 工具调用,而不是检索文档。
二、RAG 的优势与企业用途
2.1、三层优势
第一层是成本。 把整份知识库塞进上下文最贵——单个请求可能吃掉 5 万~15 万 token。RAG 只取最相关的几段,token 消耗能降一到两个数量级。有个公开的客服平台案例:改造前每月 LLM 花费 9.2 万美元,改用 RAG 后降到 2.2 万美元,**降了 76%**,单请求 token 从 8.5 万降到 8,500。
第二层是准确与可溯。 同一案例中答案准确率从 71% 提升到 95%,平均响应从 9.2 秒降到 3.8 秒。更关键的是引用溯源——法务、财务、医疗场景里,答案必须能追回原始文档,否则没人敢用。
第三层是实时。 政策更新、产品迭代只需要重新入库,不用重训模型;好的架构能做到准实时甚至实时。
2.2、企业都在拿它做什么
RAG 已经是企业 AI 落地的默认架构,公开数据显示 2026 年超过 80% 的企业 AI 项目涉及 RAG。按行业看,价值最明确的几类场景是:
| 行业 | 典型场景 | 公开案例中的收益量级 |
|---|---|---|
| 金融 | 合规咨询、监管政策解读 | 政策解读准确率 92%,人工复核工作量 -65%,年省合规成本 200 万+ |
| 电商 | 全渠道智能客服 | 应答一致性 58%→89%,跨渠道问题处理时长 -55%,NPS +21 |
| 制造 | 设备故障远程诊断 | 首次修复率 67%→84%,现场服务需求 -40%,停机时间 -35% |
| 法律 / 法务 | 合同审查、条款与判例检索 | 合同审查从 2 小时缩短到 18 分钟;法律研究时间 -70%~80% |
| SaaS / IT | 产品文档、工单自助、代码库问答 | 支持工单 -33%,准确率 91%,NPS 42→53,ROI 约 25 倍 |
| 通用客服中心 | 人力与知识维护成本优化 | 200 人团队年人力成本 1200 万→840 万(-30%),知识维护成本 -62.5% |
共性规律很清楚:知识越密集、更新越频繁、合规要求越高的场景,RAG 的收益越明显。
三、原理解剖:双链路 + 六大组件
在拆开细节之前,先看看 RAG 架构本身的演进脉络——你现在要搭的那套系统,处在下面这级台阶上。
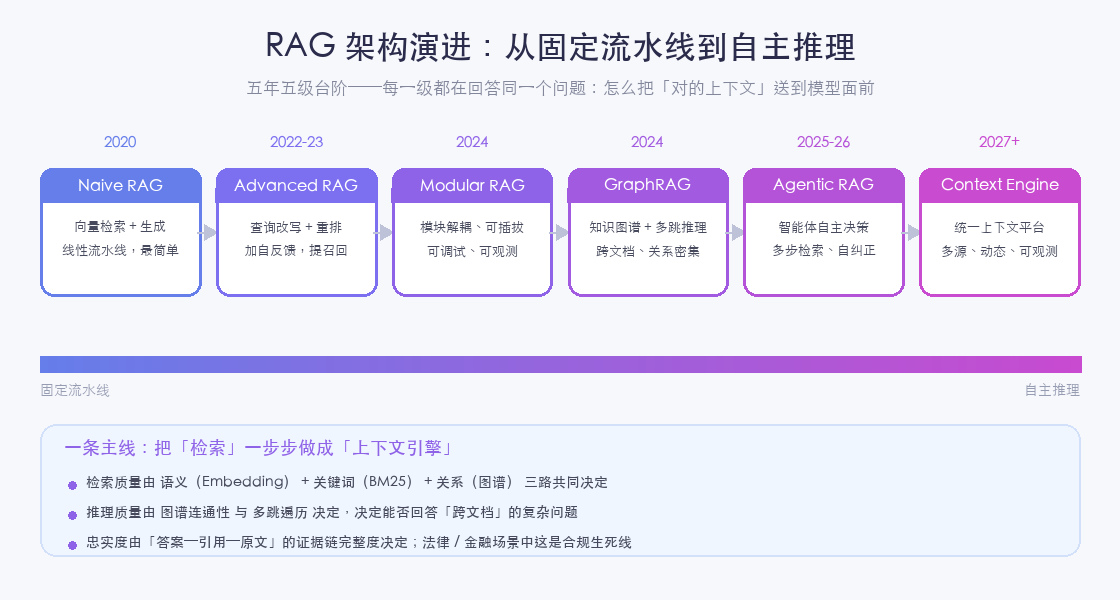
从最早的 Naive RAG 线性流水线,到查询改写与重排的 Advanced RAG,再到模块解耦的 Modular RAG、引入知识图谱的 GraphRAG、自主决策的 Agentic RAG,最终指向统一的「上下文引擎」——每一级台阶,都在回答同一个问题:怎么把「对的上下文」送到模型面前。而下面的拆解,就从这个体系里最通用、也最值得先打扎实的一层开始。
3.1、双链路架构
一套生产可用的 RAG,核心是两条各自独立的链路。
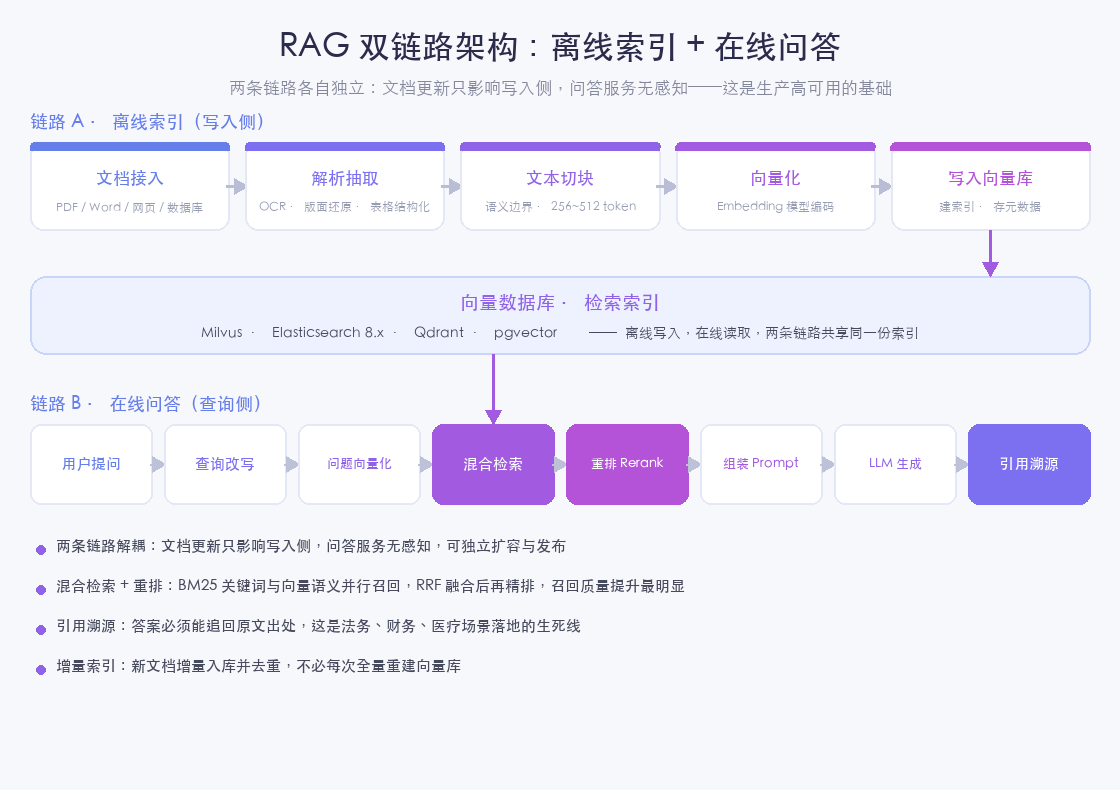
- 链路 A 离线索引(写入侧):文档接入 → 解析抽取 → 文本切块 → 向量化 → 写入向量库
- 链路 B 在线问答(查询侧):用户提问 → 查询改写 → 问题向量化 → 混合检索 → 重排 → 组装 Prompt → LLM 生成 → 引用溯源
两条链路解耦的价值在于:文档更新只影响写入侧,问答服务无感知,两侧可以独立扩容、独立发布、独立回滚。这是生产高可用的基础设计。
3.2、六大组件细节拆分
把上面两条链路拆到组件级别,就是下面这六块。每个环节都有一个最容易翻车的细节,我在图上标了「关键」那一行。
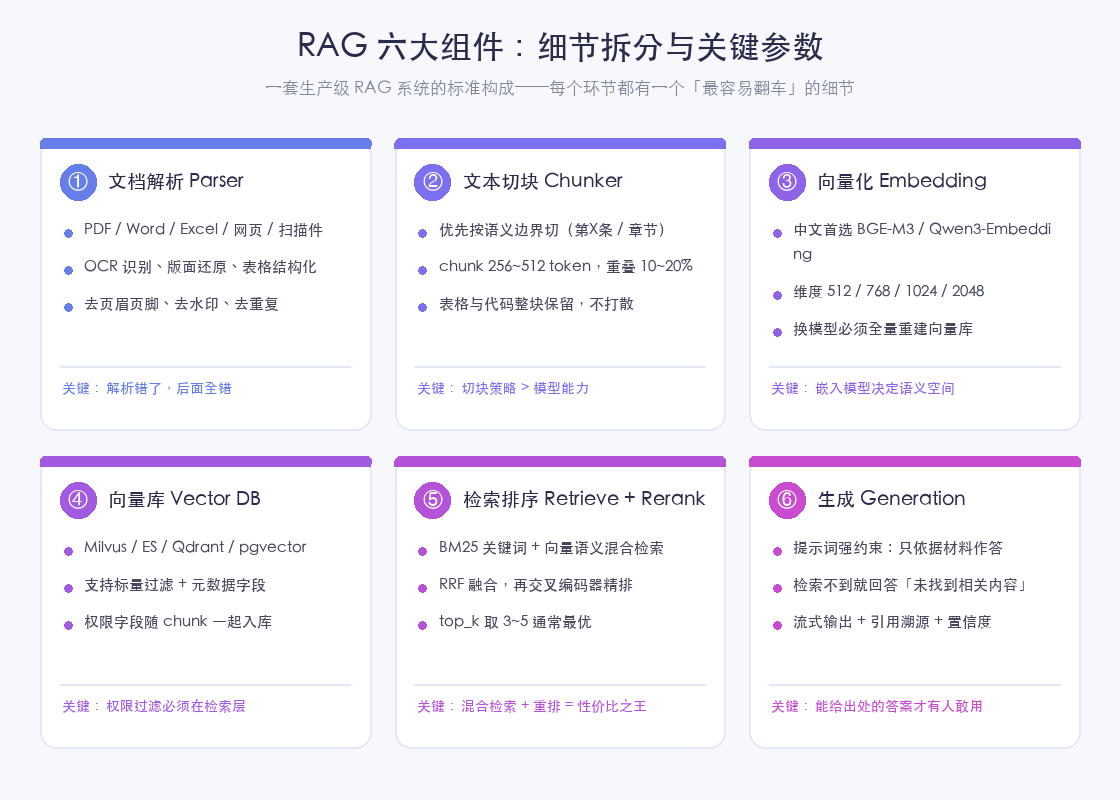
- 文档解析 Parser:PDF、Word、Excel、网页、扫描件都要能吃进来,做 OCR、版面还原、表格结构化,并清理页眉页脚。解析错了,后面全错——很多团队把 50% 的精力花在数据清洗和解析上,这是对的。
- 文本切块 Chunker:优先按语义边界切(规章按「第 X 条」、手册按章节),chunk 控制在 256
512 token,重叠 10%20%,表格与代码整块保留。经验之谈:切块策略的影响力大于模型能力。 - 向量化 Embedding:把文本编码成向量。中文场景首选 BGE-M3 / Qwen3-Embedding 系列。换嵌入模型必须全量重建向量库,新旧向量不能混用。
- 向量库 Vector DB:存向量与元数据,支持标量过滤。权限过滤必须在检索层做(用 filter),绝不能检索完再在应用层裁剪,那会砍掉 top_k 导致内容不足。
- 检索排序 Retriever + Rerank:BM25 关键词与向量语义并行召回,用 RRF 融合,再用交叉编码器精排。混合检索 + 重排是性价比之王,两行配置换来召回率大幅提升。
- 生成 Generation:提示词强约束、检索不到就拒答、流式输出、引用溯源、置信度提示。能给出处的答案才有人敢用。
3.3、四个决定成败的技术点
① 切块:别迷信固定长度
1 | from langchain_text_splitters import RecursiveCharacterTextSplitter |
实践心得:制度类按「第 X 条」切、技术手册按章节切,效果远好于暴力等分;每个 chunk 要带上来源文件、章节标题、部门等元数据,检索后才能做权限过滤和引用溯源。
② 混合检索 + RRF 融合
纯向量检索最大的问题是丢失精确匹配——型号、法条编号、专有名词很容易「语义漂移」。所以工业界标准做法是 BM25 + 向量双路召回:
1 | # Elasticsearch 8.x:BM25 与 KNN 并行,RRF 融合 |
③ 重排 Rerank
召回之后一定要精排。bge-reranker-v2-m3 这类交叉编码器能把真正相关的片段顶上来,这也是 top_k 可以放心设小的原因——top_k 不是越大越好,塞太多无关内容模型反而被带偏,配合重排后取 3~5 条通常最优。
④ 查询改写
用户口语化提问(「报销超了咋整」)直接检索命中率很低。加一步 LLM 把问题改写成规范表述,召回率能有明显提升。这一层还可以做意图路由:简单问题直接答、复杂问题才触发多步检索。
四、选型之一:向量数据库
| 产品 | 部署方式 | 优势 | 劣势 | 适用规模 |
|---|---|---|---|---|
| Milvus | 自建集群 / 云 | 性能强、生态全、支持标量过滤 | 运维成本高 | 亿级以上 |
| Qdrant | 单机 / Docker | Rust 编写性能好、过滤查询强 | 中文生态一般 | 中小型 |
| Weaviate | 单机 / 集群 | 内置混合检索、GraphQL API、模块化 | 资源占用偏高 | 中型 |
| Elasticsearch 8+ | 集群 | 复用现有 ES,BM25 + 向量混合检索 | 向量性能非最优 | 已有 ES 的团队 |
| pgvector | PostgreSQL 扩展 | 已在用 PG 则零成本,HNSW/IVFFlat 索引 | 亿级以上吃力 | 中小型 |
| Chroma | 嵌入式 / 轻量 | 上手最快,适合原型验证 | 不适合大规模生产 | 原型 / 小规模 |
我们的场景是文档百万级以内、团队已有 ES 运维经验,最终选了 ES 8.x 的混合检索——一套存储同时搞定关键词和向量两种召回,省掉了一个组件。如果你的数据量在十亿级,那还是老老实实上 Milvus。
五、选型之二:Embedding 模型
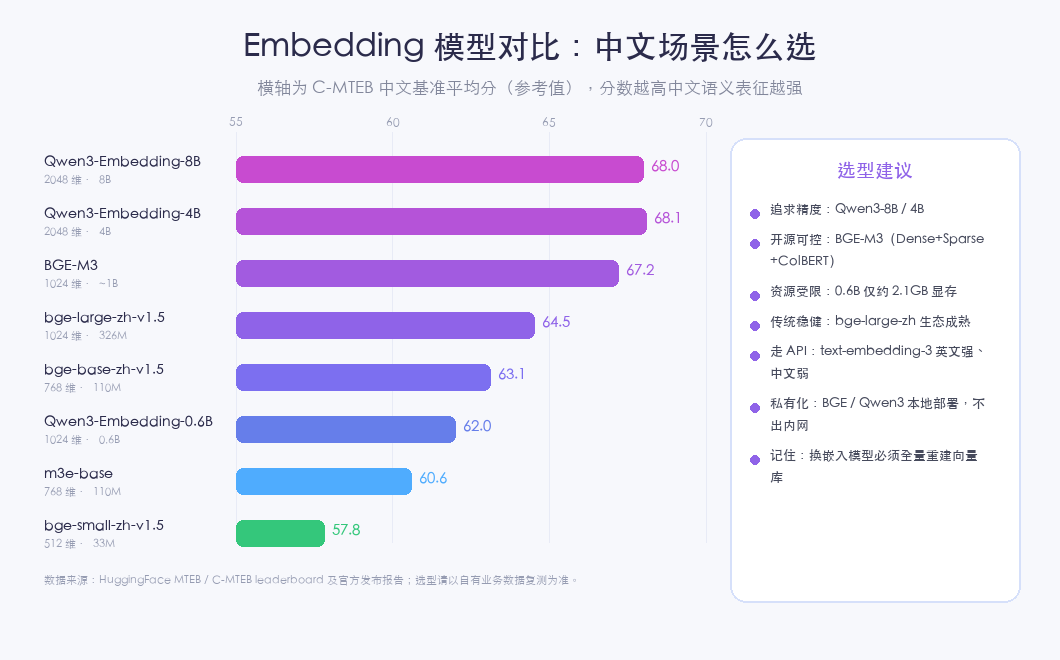
向量模型决定语义空间的质量,是检索效果的天花板之一。中文场景下当前的主流排名大致是这样:
| 模型 | 参数量 | 维度 | C-MTEB(参考) | 推荐场景 |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 8B | 2048 | ~68+ | 追求最高精度(2025 新标杆) |
| Qwen3-Embedding-4B | 4B | 2048 | 68.09 | 高精度且算力可控 |
| BGE-M3 | ~1B | 1024 | 67.20 | 开源基线首选,多语言,Dense+Sparse+ColBERT |
| bge-large-zh-v1.5 | 326M | 1024 | 64.53 | 传统首选,生态成熟 |
| bge-base-zh-v1.5 | 110M | 768 | 63.13 | 生产环境均衡之选 |
| Qwen3-Embedding-0.6B | 0.6B | 1024 | ~62+ | 轻量,约 2.1GB 显存 |
| m3e-base | 110M | 768 | 60.57 | 中文早期优化模型 |
| bge-small-zh-v1.5 | 33M | 512 | 57.82 | 快速开发、资源受限 |
选型建议:
- 追求精度:Qwen3-Embedding-8B / 4B(4B 在 RTX 3060 12GB 上 FP16 约 8GB 显存,Q4 量化约 3GB);
- 开源可控 + 多语言:BGE-M3,同时支持稠密、稀疏和 ColBERT 多向量检索;
- 私有化合规:BGE / Qwen3 都能本地部署,数据不出内网;
- 走 API:OpenAI
text-embedding-3-large英文强、中文相对弱,且数据要出网。
⚠️ 两个必须记住的坑:一是换嵌入模型必须全量重建向量库(维度和语义空间都变了);二是别只信公开榜单,先用 C-MTEB 缩小候选范围,再拿自己 50100 条人工标注问句做最终验证——两个来源吻合,选型才可信。合成 Query(用 LLM 从文档反生成问题)会导致指标虚高 10%30%,只能用来做冒烟测试。
六、选型之三:GitHub 开源知识库 / RAG 平台
这块是选型里最花眼的部分。2025 年 GitHub 上的 RAG 相关项目已经非常丰富,我按「框架层」和「平台层」分开看:
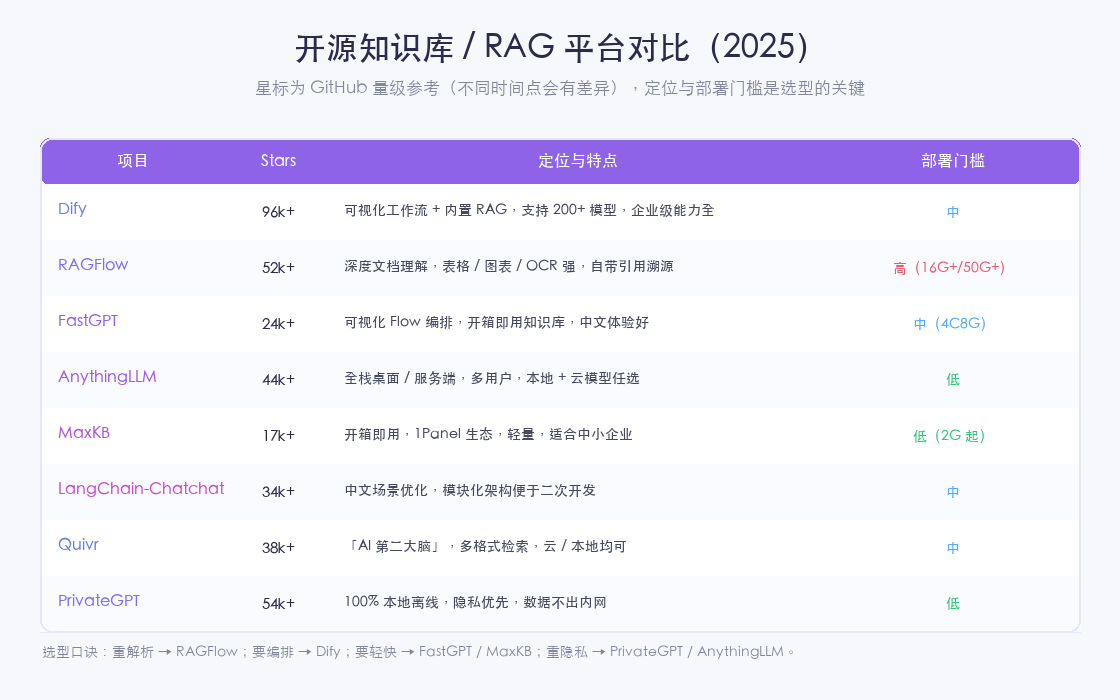
平台层(开箱即用,带界面):
- Dify(96k+ ⭐):可视化工作流 + 内置 RAG,支持 200+ 模型接入,企业级能力最全,适合要快速搭中后台应用的团队;
- RAGFlow(52k+ ⭐):深度文档理解,表格 / 图表 / OCR 强,自带引用溯源,复杂 PDF 解析的「外科医生」,代价是部署门槛高(16G+ 内存、50G+ 磁盘);
- FastGPT(24k+ ⭐):可视化 Flow 编排,开箱即用知识库,中文体验好,中小团队的性价比之选;
- AnythingLLM(44k+ ⭐):全栈桌面 / 服务端,多用户,本地 + 云模型任选,前端体验好;
- MaxKB(17k+ ⭐):开箱即用,2G 内存可跑,适合中小企业快速起步;
- LangChain-Chatchat(34k+ ⭐):中文场景优化,模块化架构便于二次开发;
- Quivr(38k+ ⭐):主打「AI 第二大脑」,多格式检索;PrivateGPT(54k+ ⭐)则主打 100% 本地离线、隐私优先。
框架层(自己写代码,灵活性最高):
- LangChain:事实上的 LLM 应用标准框架,
LangGraph用于智能体编排、LangSmith做可观测; - LlamaIndex:专为 RAG 设计的数据框架,100+ 连接器、分层检索、多模态 RAG,做文档问答最顺手;
- Haystack(deepset):企业级端到端流水线,内置评估,生产就绪。
图增强方向:
- GraphRAG(微软):用知识图谱补齐「关系」,擅长跨文档多跳问答;原版索引成本曾高达数万美元,2025 年的 LazyGraphRAG 已把成本大幅拉低;
- LightRAG(港大):双图(图 + 向量)索引,支持 local / global 双模式检索。
选型口诀:重解析 → RAGFlow;要编排 → Dify;要轻快 → FastGPT / MaxKB;重隐私 → PrivateGPT / AnythingLLM;要深度定制 → LangChain / LlamaIndex 自己写。
七、本地 Demo:15 分钟跑通一套 RAG
理论铺垫完了,动手跑一遍。这套 Demo 全程本地、免费、不需要任何 API Key,用 Ollama 跑模型,LangChain 做框架,Chroma 做向量库。
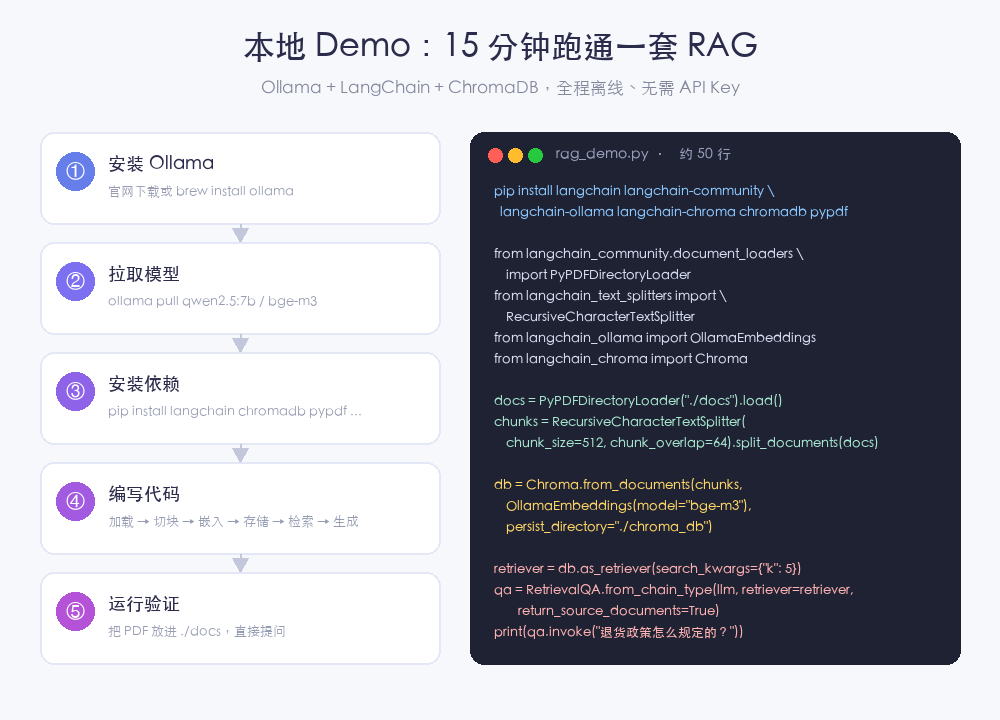
7.1 环境准备
1 | # 1) 安装 Ollama(macOS 为例,官网也可下载安装包) |
7.2 安装依赖
1 | pip install langchain langchain-community langchain-ollama \ |
7.3 约 50 行核心代码
1 | from langchain_community.document_loaders import PyPDFDirectoryLoader |
把几个 PDF 丢进 ./docs,运行脚本,就能直接提问了。首次运行会做一次嵌入(几百页大概一两分钟),之后从本地 chroma_db 加载,秒级响应。
7.4 新手最容易踩的坑
- 切块太大:2000 token 的块往往横跨多个主题,检索出来的内容 30% 相关、70% 是噪音,模型容易被带偏;
- 嵌错模型:领域术语多(法律、医疗、代码)时通用嵌入模型可能抓不住语义,先检查检索出来的片段对不对,再怪生成模型;
- 上下文塞太满:一次塞 20 个片段进提示词,模型会「迷失在中间」——开头结尾认真看,中间被略过,所以取 3~5 条就够;
- 模型无视你的文档:检索没错但模型还是照训练记忆答——提示词要写死「仅依据以下材料回答,找不到就说不知道」。
八、企业级落地:RAG 智能客服实战
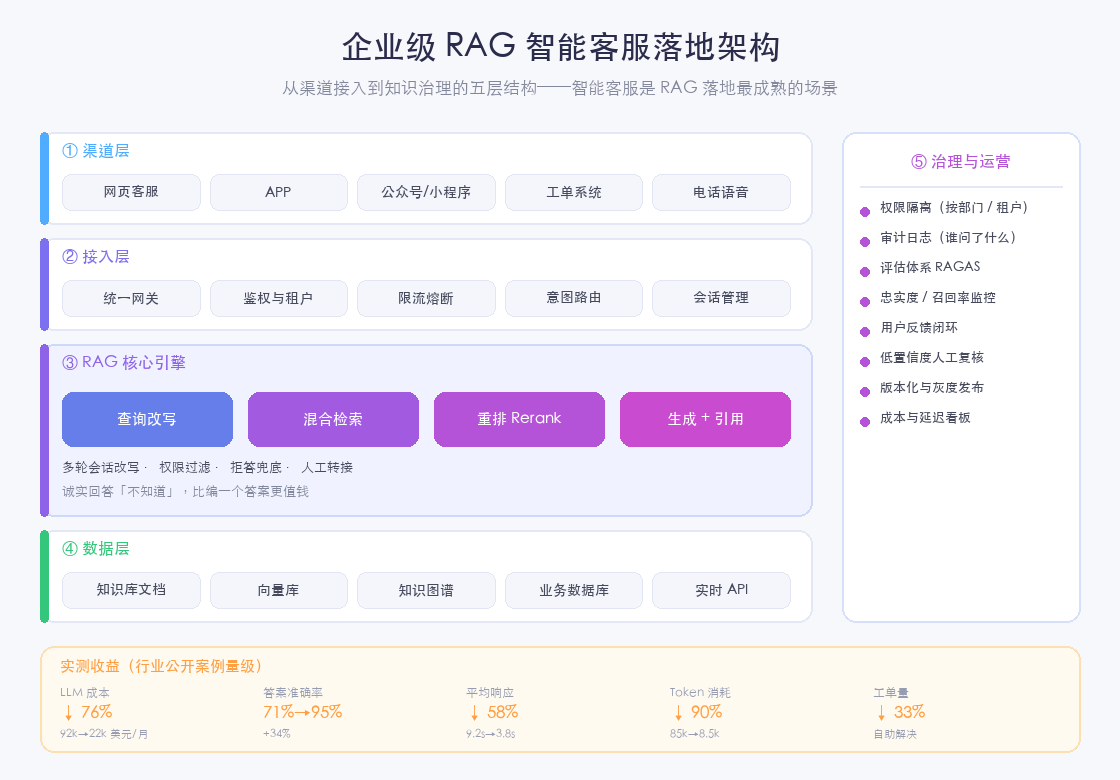
智能客服是 RAG 落地最成熟的场景。它比内部知识助手难的地方在于:多租户、多渠道、强合规、要可控。下面是一套可参考的落地架构。
8.1 分层设计
- 渠道层:网页客服、APP、公众号 / 小程序、工单系统、电话语音,统一接入;
- 接入层:统一网关、鉴权与租户隔离、限流熔断、意图路由、会话管理;
- RAG 核心引擎:查询改写 → 混合检索 → 重排 → 生成 + 引用;做好多轮会话改写、权限过滤、拒答兜底、人工转接;
- 数据层:知识库文档、向量库、知识图谱、业务数据库、实时 API;
- 治理与运营:权限隔离、审计日志、RAGAS 评估体系、忠实度 / 召回率监控、用户反馈闭环、低置信度人工复核、版本化灰度、成本延迟看板。
8.2 权限过滤必须在检索层
多租户场景最容易出安全事故。以 pgvector 为例,在 SQL 里就带上租户条件,而不是检索完再过滤:
1 | SELECT content, metadata, |
这样客户 A 永远检索不到客户 B 的文档,也避免了「先取 top_k 再裁剪」导致召回不足的问题。
8.3 落地路线图
| 阶段 | 周期 | 目标 |
|---|---|---|
| 试点期 | 1~3 月 | 选 1~2 个高频场景(如订单查询、退换货政策)跑通 |
| 扩展期 | 4~6 月 | 接入核心业务系统知识,打通多渠道 |
| 优化期 | 7~12 月 | 完善监控评估体系与反馈闭环,做权限与审计 |
8.4 实测收益(公开案例量级)
- 成本:某客服自动化平台 LLM 花费 9.2 万 → 2.2 万美元/月(**-76%),单请求 token 8.5 万 → 8,500(-90%**);
- 质量:答案准确率 71% → 95%(**+34%),平均响应 9.2s → 3.8s(-58%**);
- 自助率:某产品支持工单 87 → 58 件/周(**-33%**),NPS 42 → 53,投入产出比约 25 倍;
- 行业化:金融监管解读准确率 92%、人工复核 -65%;电商应答一致性 58%→89%;制造首次修复率 67%→84%。
8.5 评估体系不能省
没有评估就没有优化方向。建议维护一份黄金问答集(200 条左右,人工标注正确出处),每次调整切块策略、换模型、改提示词都跑一遍:
- 检索指标:Recall@5(前 5 条是否包含正确出处)、上下文精确率 / 召回率;
- 生成指标:忠实度(答案是否忠于材料)、相关性(是否回答了问题)、引用准确率。
RAGAS、ARES 这类框架已经把忠实度、上下文精度、召回率做成了标准指标,可以直接接进 CI。
九、RAG 的缺陷与挑战
泼点冷水——RAG 目前远不是银弹。
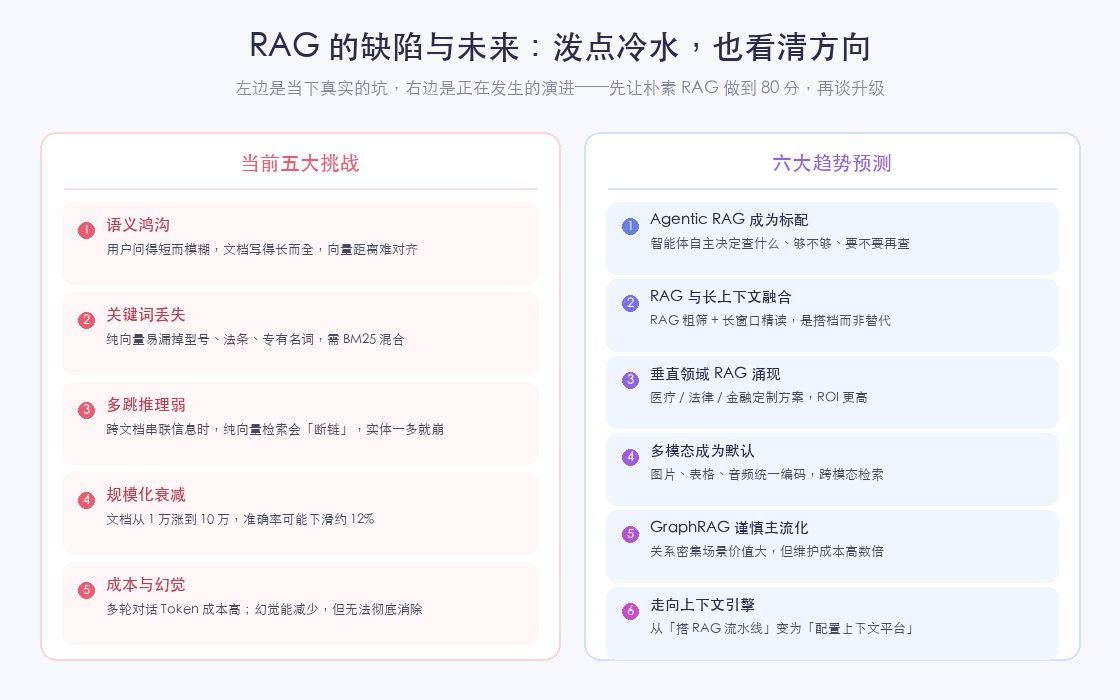
- 语义鸿沟:用户的问题往往又短又模糊(「Q3 数据为什么异常」),而文档写得又长又全,向量空间的对称假设在这类非对称匹配上表现很差;
- 关键词精确匹配丢失:稠密向量是语义压缩,容易丢掉型号、法条编号、SKU、代码错误码这类关键词,必须靠 BM25 补;
- 多跳推理弱:需要跨多个文档串联信息时,纯向量检索会「断链」。有研究指出,当查询涉及的实体数量超过 5 个时,纯向量检索的准确率会断崖式下跌——这是结构性问题,调参救不回来;
- 规模化衰减:文档从 1 万页涨到 10 万页,某些 RAG 方案的准确率会下降约 12%;
- 成本与幻觉:多轮对话的 token 成本高;幻觉能减少,但无法彻底消除;领域术语(医疗、法律、金融)上基线 RAG 表现尤其吃力;
- 工程复杂度高:从 Demo 到生产级,中间隔着 2~4 个月的工程投入——切块、元数据、评估、监控、权限,每一项都是坑。
还有一个反直觉的现象:GraphRAG 这类高级方案不是万能药。微软原版 GraphRAG 索引大语料成本曾高达 3.3 万美元以上,虽然 LazyGraphRAG 已大幅降低门槛,但它的抽取与维护成本仍数倍于基线向量方案,所以业界更倾向于在关系密集的受监管领域选择性使用,而不是默认全上。常见的失败模式有三类:一上来就上 GraphRAG 结果成本失控、数据质量差导致检索再准也没用、把 RAG 当黑盒缺少产品化设计。
十、发展趋势预测
最后聊聊我的判断:
- Agentic RAG 成为标配:固定流水线「检索 → 增强 → 生成」走完就结束,而 Agentic RAG 让智能体自主决策——要不要检索、查哪个源、证据够不够、要不要再查。Cursor 边写代码边检索代码库就是典型应用。注意:不是所有场景都需要 Agentic,简单场景用规则 + 轻量模型就够。
- RAG 与长上下文融合,而非替代:千万 token 的上下文窗口并不会杀死 RAG,因为太贵(一次几十美元)、太慢(延迟高一个数量级)、且存在「迷失在中间」。正确姿势是 RAG 粗筛(10 万文档筛到 10 篇)+ 长窗口精读。
- 垂直领域 RAG 涌现:医疗接医学知识图谱、法律内置法条与判例、金融实时接市场数据——领域文档有明显结构特征时,定制方案 ROI 更高。
- 多模态成为默认:财务报表 PDF、产品手册结构图、会议录音、CAD 图纸……企业文档本来就不只是纯文本。2026 年的 RAG 平台要学会「读文字 + 看图 + 听音频」,ColPali 这类页面级视觉嵌入正在绕过 OCR。
- GraphRAG 谨慎主流化:关系密集、受监管的领域会率先采用,但不会成为默认选项。
- 最终走向「上下文引擎」:从「搭一套 RAG 流水线」演化为「配置一个上下文平台」——统一管理文档、数据库、API、图谱、实时流,理解查询意图动态选源,处理权限,优化上下文窗口,并提供可观测性。等这些原语被抽象成更高层接口,「RAG」这个词可能就消失了,就像 SQL 抽象掉了 B+ 树遍历一样。
十一、总结
回头看整个搭建过程,三条最重要的经验:
- 切块策略 > 模型能力:检索质量的天花板在数据预处理,别急着调模型。把 50% 的精力放在解析与清洗上,是划算的。
- 混合检索 + 重排是性价比之王:BM25 + 向量的双路召回,配一个交叉编码器重排,两行配置换来召回率大幅提升。
- 引用溯源决定系统生死:能给出处的答案才有人敢信、有人敢用;检索不到就诚实拒答,比编一个答案更值钱。
行动建议:
- 想快速验证:本地按第七节用 Ollama + LangChain + Chroma 跑一遍,15 分钟出效果;
- 要开箱即用:重解析选 RAGFlow,要编排选 Dify,轻快起步选 FastGPT / MaxKB;
- 要上生产:先搭评估集,再谈优化;权限过滤写在检索层;成本、延迟、忠实度三个看板一个都不能少。
RAG 不神秘,它本质是「搜索 + 大模型摘要」的工程化组合。把检索做扎实,把链路做稳,企业级智能助手就成了。
本文为个人技术笔记,行业数据与模型排名均整理自公开资料(截至 2026-10-13),属于量级参考,落地请以自有业务数据复测为准。如果你在搭建过程中遇到问题,欢迎在留言板交流。
 微信
 支付宝
欢迎来到李苟蛋的个人博客,对本站的文章和技术问题有疑问或建议,欢迎留言,或者关注我的公众号:狗蛋的智栈