企业级智能助手 RAG 搭建指南
序言
- 大模型火了这几年,很多企业的第一个落地场景都是”智能问答助手”:把内部文档、规章制度、产品手册喂给大模型,让员工或客户直接提问。但直接用大模型有两个致命问题:知识截止日期(训练数据是旧的)和幻觉(一本正经地胡说八道)。RAG(Retrieval-Augmented Generation,检索增强生成)就是解决这两个问题的主流方案——先从企业知识库里检索相关内容,再把检索结果连同问题一起交给大模型作答。
- 这篇文章记录我搭建企业级 RAG 助手的完整过程:从架构设计、技术选型,到向量库对比、核心代码,最后是生产环境踩过的坑。读完你可以直接照着搭一套能用的系统。
1、为什么需要 RAG
在决定动手之前,先想清楚 RAG 到底解决什么问题,别为了技术而技术。
1.1、大模型的两大硬伤
- 知识时效性:模型的训练数据有截止日期,公司上个月新发的报销制度它根本不知道
- 私有知识缺失:企业内部文档不在公开语料里,模型从没”学”过你的产品手册
- 幻觉问题:问它不知道的,它不会说”不知道”,而是编一个看起来很专业的答案
1.2、RAG 与微调怎么选
| 维度 | RAG | 微调(Fine-tuning) |
|---|---|---|
| 知识更新 | 实时,重新灌库即可 | 需重新训练 |
| 成本 | 低,只需向量库+检索 | 高,需要算力和标注数据 |
| 可解释性 | 强,能给出引用出处 | 弱,黑盒 |
| 适用场景 | 知识密集型问答 | 风格/格式/领域语言学习 |
一句话总结:知识问题用 RAG,能力问题用微调。企业助手 90% 的需求是知识问答,RAG 是首选。
2、整体架构设计
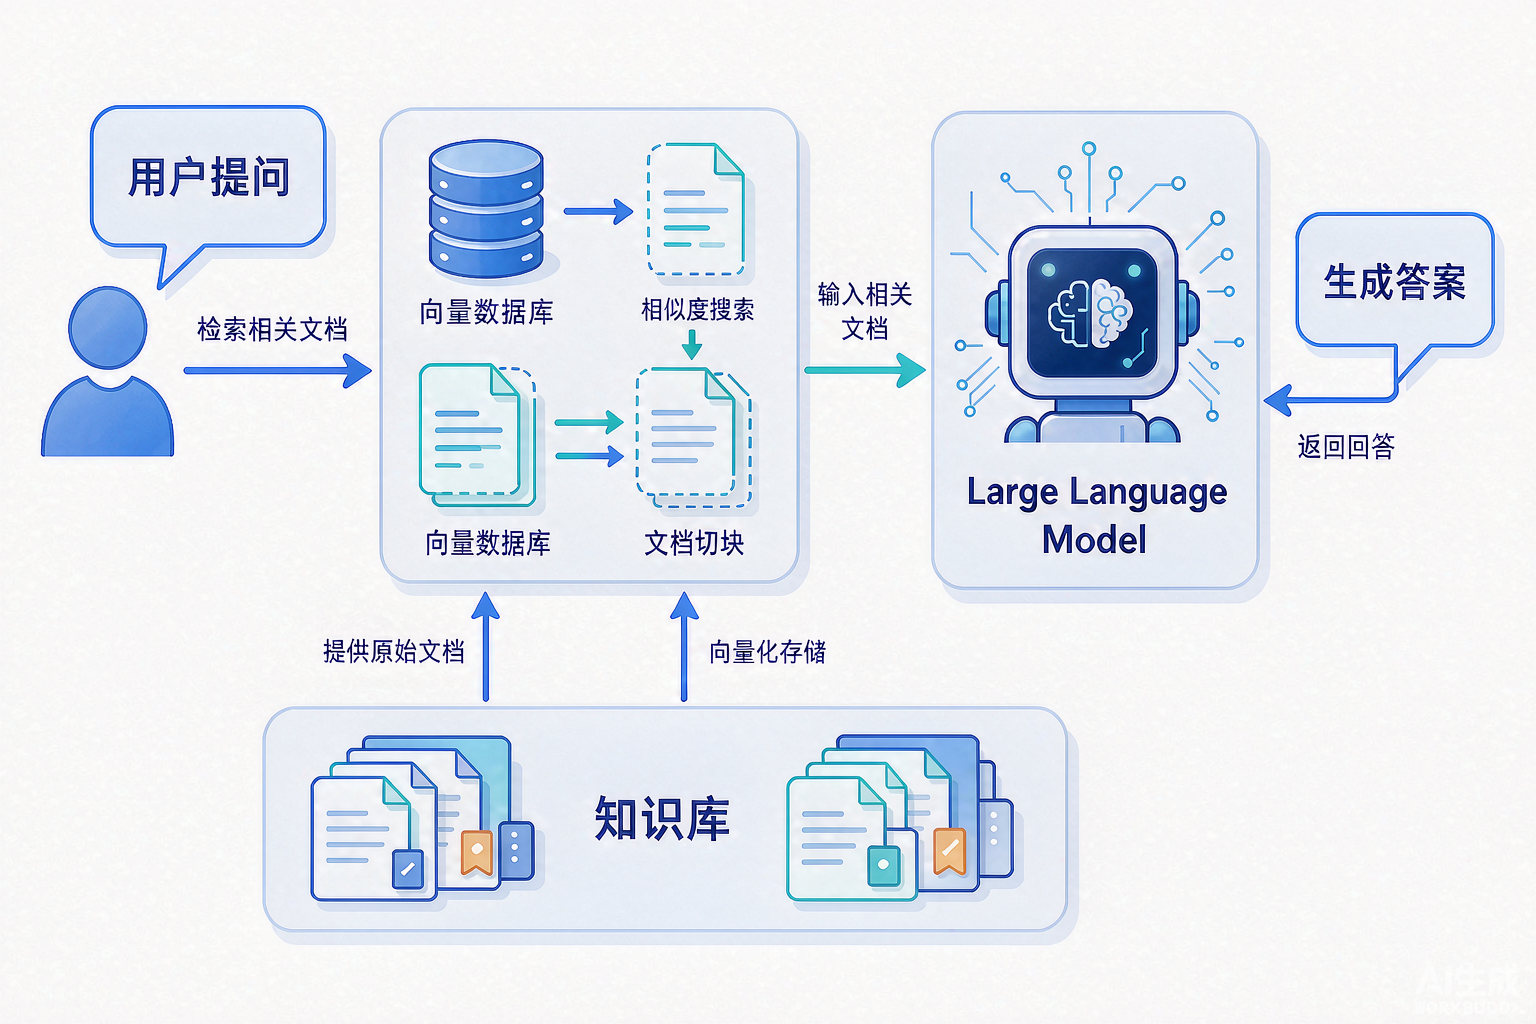
一套生产可用的 RAG 系统,核心分两条链路:
2.1、离线索引链路(写入侧)
1 | 原始文档 → 解析抽取 → 文本切块 → 向量化(Embedding) → 写入向量库 |
2.2、在线问答链路(查询侧)
1 | 用户提问 → 问题向量化 → 相似度检索 → 重排序(Rerank) → 组装Prompt → LLM生成 → 引用溯源 |
两条链路各自独立,文档更新只影响写入侧,问答服务无感知——这是生产环境高可用的基础设计。
3、技术选型
3.1、向量数据库对比
选型时我实测了四家主流产品:
| 产品 | 部署方式 | 优势 | 劣势 | 适用规模 |
|---|---|---|---|---|
| Milvus | 自建集群 | 性能强、生态全、支持标量过滤 | 运维成本高 | 亿级以上 |
| Qdrant | 单机/Docker | Rust 编写性能好、过滤查询强 | 中文生态一般 | 中小型 |
| Weaviate | 单机/集群 | 内置混合检索、模块化 | 资源占用偏高 | 中型 |
| Elasticsearch 8+ | 集群 | 复用现有 ES、BM25+向量混合检索 | 向量性能非最优 | 已有ES的团队 |
我们的选择:文档量在百万级以内、团队已有 ES 运维经验,最终选了 ES 8.x 的混合检索(BM25 关键词 + KNN 向量),一套存储搞定两种召回,省了一个组件。
3.2、模型选择
- Embedding 模型:中文场景首选 BGE 系列(bge-large-zh-v1.5),MTEB 榜单表现好且开源可私有化;走 API 可选各云厂商的 embedding 服务
- 生成模型:私有化用 Qwen / DeepSeek 系列开源自部署;上云则按预算和合规要求选
- Rerank 模型:bge-reranker-v2-m3,检索后再精排,召回质量提升非常明显
4、核心实现
4.1、文档切块(Chunking)
切块策略直接决定检索质量,是最容易被低估的环节:
1 | from langchain.text_splitter import RecursiveCharacterTextSplitter |
实践心得:
- 不要迷信固定长度切块:规章制度类文档按”第X条”切,技术手册按章节切,效果远好于暴力切
- 块里带元数据:每个 chunk 附上来源文件、章节标题、部门,检索后可以直接做权限过滤和引用溯源
- 表格和代码单独处理:整表作为一个 chunk,别打散
4.2、向量写入与检索
以 Elasticsearch 8.x 为例:
1 | # 创建索引(含向量字段) |
1 | # 混合检索:BM25 + KNN,RRF 融合 |
4.3、带引用溯源的生成
把检索结果组装进 Prompt,让模型只基于给定材料回答:
1 | PROMPT = """你是企业知识库助手。请仅根据以下参考材料回答问题, |
引用溯源是企业级落地的刚需——法务、财务场景下,答案必须能追溯到原始文档,否则没人敢用。
5、生产环境踩坑记录
上线过程中踩的坑,按疼痛程度排序:
5.1、检索质量类
- top_k 不是越大越好:塞太多无关内容进 Prompt,模型反而被带偏,配合 Rerank 后 top_k=5 通常最优
- 必须做查询改写:用户口语化提问(”报销超了咋整”)直接检索命中率很低,加一步 LLM 改写成规范表述,召回率提升约 20%
- 文档去重常被遗忘:同一份制度改了三版都在库里,检索出旧版就出事故。写入时按内容 hash 去重 + 按 version 字段过滤
5.2、工程类
- Embedding 模型升级是大事:换嵌入模型必须全量重建向量库,新旧向量不能混用(维度和语义空间都变了)
- 权限过滤要在检索层做:部门隔离文档在检索时用 filter 实现,绝不能检索完再在应用层过滤(会砍掉 top_k 导致内容不足)
- 流式响应必备:生成答案动辄几秒,不做 streaming 用户体验极差
5.3、评估体系
没有评估就没有优化方向。我们维护了一个 200 条的黄金问答集,每次调整切块策略或换模型都跑一遍:
- 检索指标:Recall@5(前 5 条召回是否包含正确出处)
- 生成指标:忠实度(答案是否忠于材料)、相关性(是否回答了问题)
6、效果与总结
上线后的数据:常见问题准确率从基线的 62% 提升到 **91%**,平均响应 2.3 秒,每周节省客服人工约 40 小时。
回头看整个搭建过程,三条最重要的经验:
- 切块策略 > 模型能力:检索质量的天花板在数据预处理,别急着调模型
- 混合检索 + Rerank 是性价比之王:两行配置换来召回率大幅提升
- 引用溯源决定系统生死:能给出处的答案才有人敢信、有人敢用
RAG 不神秘,它本质是”搜索 + 大模型摘要”的工程化组合。把检索做扎实,把链路做稳,企业级智能助手就成了。
 微信
 支付宝